Toolso.AI
Toolso.AI
OutilsCatégoriesTendancesNouveautésTarifsBlog
Toolso.AI
Toolso.AI

💌Abonnez-vous à AI Tools Weekly

Sélection hebdomadaire des derniers et meilleurs outils IA et tendances, livrés dans votre boîte mail S'abonner

Toolso.AI
Toolso.AI

Découvrez les meilleurs outils IA pour booster votre productivité

GitHubGitHubTwitterX (Twitter)YouTubeYouTubeTikTokEmail

Catégories populaires

  • Écriture IA
  • Image IA
  • Vidéo IA
  • Codage IA
  • Plus de catégories

Explorer

  • Derniers outils
  • Outils populaires
  • Plus d'outils
  • Soumettre un outil
  • Tarifs

À propos

  • À propos de nous
  • Contact
  • Blog
  • Journal des modifications

Légal

  • Politique des cookies
  • Politique de confidentialité
  • Conditions d'utilisation
  • Politique de remboursement
© 2026 Toolso.AI Tous droits réservés
Offre limitéeOffre limitéeMise en avantExamen sous 24 h · Sans backlink · 30 jours en vedette$29.90puis $59.90Passe à $59.90 après le 31 oct.Fin dans--:--:--Soumettre
  1. Accueil
  2. Tous les outils
  3. IA Open Source
  4. Unsloth
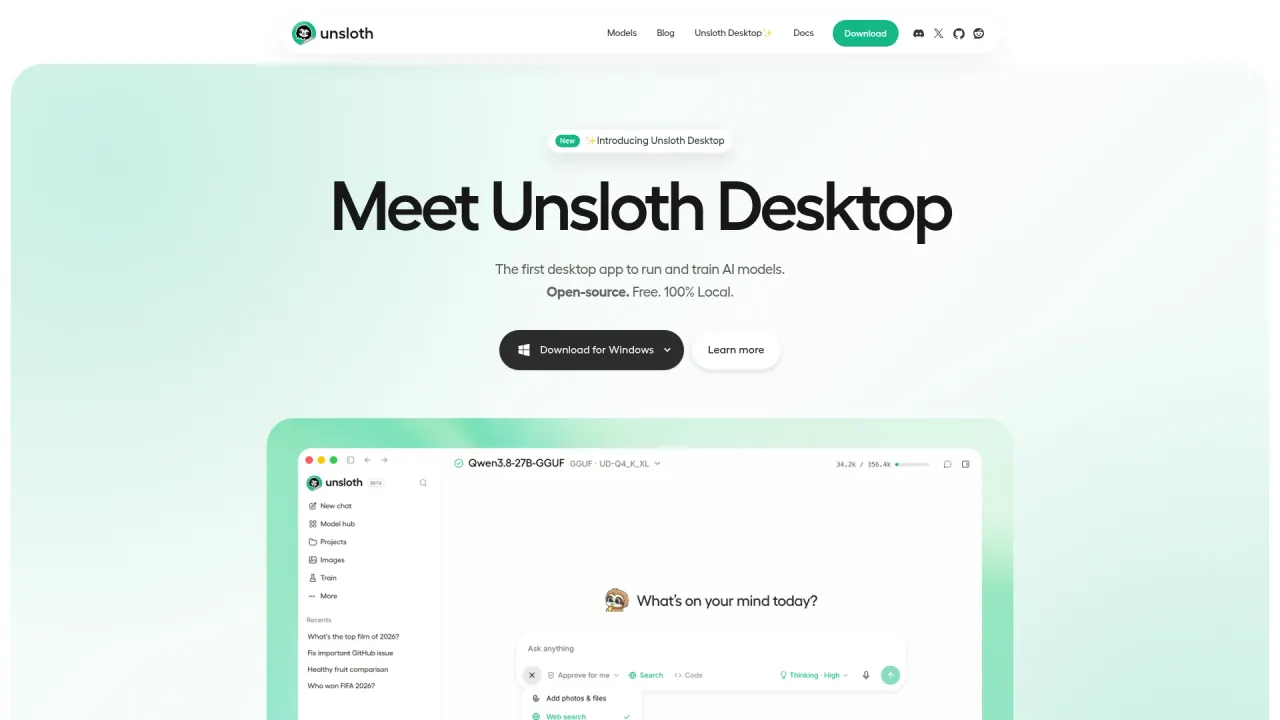
Aperçu de l’interface de Unsloth
Logo de Unsloth

Unsloth

Unsloth est un framework, une application de bureau et une interface web open source pour affiner et exécuter des LLM et des modèles de diffusion, d’audio et d’embedding sur votre propre matériel. Il couvre l’entraînement sans code, LoRA, QLoRA, les méthodes RL, la création de jeux de données et l’export GGUF.

IA Open SourceDéveloppement IAPlateforme d'Entraînement IA#Open source#Sans code#LLM
Essayer gratuitement
Favoris
Visites
Vues
Tarif
Gratuit
Publié le
3 oct. 2026
Domaine
unsloth.ai
Note des utilisateurs

Vous avez utilisé cet outil ? Notez-le

Noter cet outil

Informations produit Unsloth

Essayer gratuitement
Informations sur l'outil
Favoris
Visites
Vues
Tarif
Gratuit
Publié le
3 oct. 2026
Domaine
unsloth.ai
Note des utilisateurs

Vous avez utilisé cet outil ? Notez-le

Noter cet outil

Outils en vedette

Outils associés

Essayer gratuitement

Unsloth, qu’est-ce que c’est ?

Unsloth est un framework open source pour exécuter et entraîner des LLM, qui permet d’exécuter et d’entraîner des modèles d’IA sur votre propre matériel local via une interface open source. Il couvre les modèles de texte, de vision, de diffusion pour l’image et la vidéo, d’audio et d’embedding, aussi bien pour l’inférence locale que pour le fine-tuning de LLM.

Unsloth s’installe de trois façons distinctes : Unsloth Desktop, l’application native ; Unsloth Studio, l’interface web dans le navigateur ; ou Unsloth Core, le package Python d’origine, piloté par le code. Desktop et Studio sont les interfaces sans code ; Core est la bibliothèque que les développeurs appellent depuis leurs propres scripts d’entraînement et notebooks.

Unsloth Desktop porte la mention Beta et est décrit comme une application gratuite et open source pour exécuter et entraîner des modèles d’IA sur votre propre matériel, disponible pour macOS, Windows et Linux. Unsloth Studio est lui aussi en Beta, présenté comme une interface web open source et sans code pour entraîner, exécuter et exporter des modèles ouverts dans une seule interface locale. La page d’accueil résume Unsloth Desktop en trois mots : open source, gratuit et 100 % local. Un portrait paru en 2024 dans la presse économique rapportait que les cofondateurs de l’entreprise sont les frères Michael et Daniel Han, qui participaient alors à Y Combinator.

Fonctionnalités principales

L’argument phare d’Unsloth est qu’il entraîne les modèles LLM, de diffusion, TTS et d’embedding 2× plus vite avec 70 % de VRAM en moins et sans perte de précision. Il s’agit du chiffre de l’éditeur lui-même ; les conditions de test qui le sous-tendent sont détaillées plus bas.

Méthodes d’entraînement et modèles couverts

  • Méthodes d’entraînement : Unsloth prend en charge l’apprentissage par renforcement, LoRA, QLoRA, le fine-tuning complet, le pré-entraînement, GRPO, DPO et l’entraînement FP8.
  • Éventail de modèles : l’entreprise affirme prendre en charge l’inférence et l’entraînement de plus de 500 modèles, les workflows de vision, TTS, embedding et RL étant documentés séparément.
  • Entraînement sans code : dans Unsloth Desktop, vous déposez un fichier PDF, CSV ou JSON et choisissez LoRA, le fine-tuning complet ou le pré-entraînement ; la même page reprend l’argument « 2x plus rapide, 70 % de VRAM en moins » et indique que le multi-GPU fonctionne.
  • Suivi de l’entraînement : Unsloth Studio suit en temps réel la perte d’entraînement, les normes de gradient et l’utilisation du GPU, et la vue de progression peut s’ouvrir sur d’autres appareils, par exemple un téléphone.

Conditions des benchmarks derrière l’argument de vitesse

Les benchmarks d’entraînement publiés ont été réalisés sur des GPU H100 et Blackwell avec le jeu de données Alpaca, une taille de batch de 2, 4 étapes d’accumulation de gradient, un rang (rank) de 32 et QLoRA sur toutes les couches linéaires. Face à une référence Hugging Face + FA2, le tableau indique pour Llama 3.3 (70B) une vitesse 2x, plus de 75 % de VRAM en moins et un contexte 13x plus long, et pour Llama 3.1 (8B) une vitesse 2x, plus de 70 % de VRAM en moins et un contexte 12x plus long, dans les deux cas sur des GPU de 80 Go.

Unsloth attribue ses résultats en contexte long à son algorithme de gradient checkpointing combiné à l’algorithme CCE d’Apple, et affirme que plus il y a de données, moins il consomme de VRAM. Ce sont des benchmarks de l’éditeur, pas des mesures indépendantes.

Exécution de modèles, outils et recherche

  • Appels d’outils auto-réparateurs : selon Unsloth, des appels d’outils qui détectent, réparent et relancent les échecs rendent les appels d’outils jusqu’à 50 % plus précis, et les modèles peuvent exécuter du Bash et du Python dans un environnement sécurisé.
  • Recherche web et recherche approfondie : la recherche web normale s’exécute pendant que le modèle réfléchit encore, et la recherche approfondie planifie d’abord, cherche des sources, puis rédige un rapport détaillé avec citations.
  • Génération d’images et de vidéos : Unsloth génère avec Qwen-Image-2.1, FLUX, Z-Image, LTX, Wan et des adaptateurs LoRA affinés. Selon son propre exemple, une exécution de MiniMax-H3 FP8 sur une NVIDIA B200 a fait passer une génération en 960×544, 124 images et 8 étapes de plus de 70 secondes à 13 secondes.
  • Nouveaux modèles : Unsloth affirme pouvoir exécuter et entraîner presque tous les modèles, y compris ceux à venir, et promet un support Day Zero pour des familles comme Qwen3.8, Gemma, Meta, NVIDIA et GLM, en attribuant le travail de fond à llama.cpp et Hugging Face.
  • Comparaison de modèles et inférence : Studio peut faire s’affronter des modèles côte à côte, et ses backends llama.cpp et Hugging Face gèrent l’inférence multi-GPU, le déchargement (offloading) automatique et l’ajustement (fitting).

Export, API et fournisseurs

Unsloth Studio exporte les modèles, y compris affinés, en safetensors ou GGUF pour llama.cpp, vLLM, Ollama, LM Studio et d’autres environnements d’exécution. C’est cette étape d’export qui fait passer un modèle entraîné dans Unsloth vers d’autres logiciels.

Dans l’autre sens, Unsloth sert des modèles locaux via une API compatible OpenAI, et peut aussi connecter un abonnement ChatGPT/Codex et des fournisseurs cloud. La commande unsloth run sert un modèle et modifie des paramètres comme la taille du contexte, les couches GPU, le threading, l’échantillonnage, le réseau et la configuration des outils.

Guide

Installer Unsloth Desktop

  1. Téléchargez l’installateur de votre système : un fichier .dmg sur macOS, un .exe sur Windows ou un .deb sur Linux.
  2. Sur macOS, ouvrez l’installateur .dmg, faites glisser Unsloth dans Applications, puis lancez l’app et attendez la fin de l’installation ; sous Windows et Linux, suivez les instructions de l’installateur.
  3. Ouvrez le menu déroulant Select model ou l’onglet Model hub, choisissez un modèle et une quantification adaptée à votre appareil, téléchargez-le et commencez à discuter une fois le téléchargement terminé.

Workflow de fine-tuning dans Unsloth Studio

  1. Lancez Unsloth et chargez un modèle depuis des fichiers locaux ou une intégration prise en charge.
  2. Importez des données d’entraînement depuis des fichiers PDF, CSV ou JSONL, ou construisez un jeu de données de zéro.
  3. Nettoyez et enrichissez le jeu de données dans Data Recipes, puis entraînez avec les préréglages recommandés ou une configuration personnalisée.
  4. Discutez avec le modèle entraîné, comparez-le au modèle de base, puis enregistrez-le ou exportez-le localement vers la stack que vous utilisez déjà.

Studio peut aussi importer une configuration d’entraînement YAML et préremplir les réglages correspondants au lieu de partir des préréglages.

Accès à distance

Par défaut, unsloth studio se lie à 127.0.0.1, si bien que seule la machine locale peut y accéder. L’option --secure ne le sert que via un lien HTTPS Cloudflare gratuit et ne démarre pas du tout si le tunnel ne peut pas s’établir, de sorte que le port brut n’est jamais exposé.

Cas d’usage d’Unsloth

  • Agents de code locaux : Unsloth Start connecte Claude Code, Codex et d’autres agents à des modèles locaux via la commande unsloth start, pour qu’un workflow d’agent puisse tourner sur un modèle exécuté sur votre propre GPU.
  • Transformer des documents en données d’entraînement : Data Recipes convertit les PDF, CSV et JSON importés en jeux de données exploitables ou synthétiques grâce à un workflow à nœuds de graphe propulsé par NVIDIA NeMo Data Designer, pour qu’un jeu de fine-tuning puisse partir de vos propres documents.
  • Styles d’image personnalisés : Unsloth entraîne des adaptateurs LoRA pour SDXL, FLUX.2, Qwen-Image et Z-Image sur vos propres images, avec le sous-titrage (captioning) et le choix du rang effectués dans l’app ; le résultat peut être exporté puis rechargé pour l’inférence.
  • Workflows vocaux locaux : l’app génère, affine ou transcrit de l’audio entièrement en local, en couvrant la synthèse vocale, la reconnaissance vocale, Whisper et Qwen3-ASR.
  • Essayer le fine-tuning sans GPU local : un notebook Google Colab gratuit exécute Unsloth Studio sur les GPU T4 de Colab, où la plupart des modèles jusqu’à 22B paramètres peuvent être entraînés et exécutés avant de passer à un GPU plus puissant.

Pour qui

  • Développeurs avec un seul GPU : une comparaison indépendante de frameworks publiée en 2026 recommande Unsloth pour un seul GPU grand public avec une architecture prise en charge et LoRA ou QLoRA, en citant sa marge en longueur de contexte.
  • Personnes qui veulent exécuter un LLM en local sans entraînement : l’interface n’exige aucun fine-tuning ; vous pouvez télécharger n’importe quel GGUF ou modèle et l’utiliser tel quel.
  • Utilisateurs sans GPU dédié : sans GPU, Unsloth fonctionne toujours pour Chat et Data Recipes, si bien qu’une machine CPU seule peut quand même discuter avec des modèles et constituer des jeux de données.
  • Moins adapté aux équipes ayant besoin de parallélisme avancé : la même comparaison indique qu’Unsloth échoue lorsque le parallélisme de tenseurs, de contexte ou d’experts doit être une configuration de premier plan, et lorsqu’un modèle ne figure pas sur sa liste prise en charge, car ses gains viennent de kernels propres à chaque architecture.

Plateformes

  • Téléchargements desktop : Unsloth Desktop est proposé en .dmg pour Mac (Apple Silicon et Intel), en .exe pour Windows 10 et versions ultérieures, et en .deb pour Ubuntu et les distributions Linux compatibles.
  • Systèmes d’exploitation et puces : Unsloth prend en charge Mac, Windows, Linux et WSL, ainsi que les GPU et CPU NVIDIA, Intel, AMD et Mac, même si le matériel plus ancien peut être mal pris en charge.
  • Matériel d’entraînement de Studio : l’entraînement dans Unsloth Studio fonctionne actuellement sur les appareils NVIDIA, AMD, MLX et Intel et requiert Python 3.11–3.13 ; Unsloth Core peut aussi entraîner sur des appareils AMD et Intel.
  • Windows : Studio fonctionne sous Windows sans WSL, mais les prérequis d’entraînement indiqués sont Windows 10 ou 11 (64 bits) et un GPU NVIDIA avec ses pilotes installés.
  • Unsloth Core sur NVIDIA : Core requiert un GPU de CUDA Capability 7.0 ou supérieure, comme V100, T4, RTX séries 20 et 50, A100, H100 ou L40 ; les GTX 1070 et 1080 fonctionnent mais sont lentes.
  • Unsloth Core sur d’autres matériels : les GPU AMD et Intel fonctionnent via des guides dédiés, tandis que la prise en charge d’Apple Silicon/MLX par Core est décrite comme en préparation.
  • Docker : une image Docker officielle fonctionne pour Unsloth, la compatibilité Mac étant encore en cours.
  • Service sur réseau local : servir via le LAN garde le trafic dans votre réseau et fonctionne sans connexion Internet ; l’accès à distance passe par le tunnel Cloudflare décrit dans le guide.

Tarification

FormulePrix affichéGain de vitesseRéduction de VRAMPrise en charge GPU
FreeGratuit2x60 %Un seul
Unsloth ProNon affiché (Contact us)2,5x nombre de GPU80 %Multi
Unsloth EnterpriseNon affiché (Contact us)32x nombre de GPU90 %Multi + nœud

Unsloth Pro est présenté avec un entraînement 2,5x plus rapide, 20 % de VRAM en moins et jusqu’à 8 GPU pris en charge, et Unsloth Enterprise avec un entraînement 30x plus rapide, le multi-nœud et 30 % de précision, mais les deux n’affichent qu’un bouton Contact us : aucun prix public n’est donc indiqué pour l’un ni pour l’autre. Enterprise liste en outre jusqu’à +30 % de précision, une inférence 5x plus rapide, l’entraînement complet, toutes les fonctionnalités Pro, le multi-nœud et le support client.

Les cartes des formules ne disent pas la même chose que la documentation. La carte Free se décrit comme un freeware de la version standard d’Unsloth, la marque comme open source, cite la prise en charge de Mistral, Gemma et Llama 1, 2, 3, et indique toujours MultiGPU comme à venir (coming soon). Le tableau comparatif des formules attribue au palier Free un gain de vitesse 2x et 60 % de réduction de VRAM, ce qui diffère du chiffre « 2× plus rapide, 70 % de VRAM en moins » repris dans toute la documentation.

La licence fait partie de ce que « gratuit » signifie ici. Unsloth applique une double licence : le package Unsloth principal reste sous Apache 2.0, tandis que certains composants optionnels comme l’interface Unsloth Studio sont sous AGPL-3.0. L’entreprise affirme que cette structure aide à soutenir le développement continu tout en gardant le projet open source.

Alternatives à Unsloth

Une comparaison indépendante de frameworks de fine-tuning open source publiée en 2026 oppose Unsloth à trois autres projets et attribue à chacun un rôle différent :

  • Axolotl : la comparaison oriente vers Axolotl les équipes disposant de deux à huit GPU, ayant besoin de contexte long, de fine-tuning complet ou de pipelines RLHF, et qualifie FSDP2 combiné au parallélisme de séquence de voie la mieux documentée.
  • LLaMA-Factory : c’est le choix recommandé pour la couverture de modèles la plus large, les opérateurs non ingénieurs et la première exécution la plus rapide, avec un passage à sa CLI lors de la montée en charge.
  • TRL : les boucles d’entraînement personnalisées, les nouveaux algorithmes de post-entraînement et un couplage étroit avec Hugging Face orientent vers TRL, décrit comme la couche qu’enveloppent les autres frameworks.

Ces choix ne s’excluent pas : LLaMA-Factory peut utiliser Unsloth comme backend, TRL propose une intégration Unsloth et Axolotl appelle en interne les trainers de TRL. Choisir LLaMA-Factory ou TRL peut donc tout de même impliquer de faire tourner Unsloth en dessous.

Limitations

Maturité et passage à l’échelle

  • Configuration multi-GPU : le guide multi-GPU d’Unsloth lui-même indique que le processus peut être complexe et demande une configuration manuelle, la prise en charge multi-GPU officielle restant à annoncer.
  • Regard indépendant : une comparaison indépendante de 2026 conclut qu’Unsloth l’emporte en vitesse sur un seul GPU et en longueur de contexte, tandis que le multi-GPU reste son point faible documenté.
  • Nouvelles architectures : Unsloth fonctionne avec tout modèle pris en charge par transformers, mais certains modèles récents peuvent nécessiter un petit ajustement manuel en raison de ses optimisations.

Réserves sur le matériel et les performances

  • VRAM minimale : le tableau des besoins en VRAM donne des minimums absolus, et certains modèles en demandent davantage. Pour un modèle 8B, il indique 6 Go avec QLoRA (4-bit) et 22 Go avec LoRA (16-bit).
  • Studio sur CPU uniquement : sur les appareils CPU uniquement, Studio prend en charge Chat pour les modèles GGUF et Data Recipes, l’Export étant décrit comme disponible très bientôt.
  • Vitesse d’inférence : la recherche web, l’exécution de code et la réparation des appels d’outils ralentissent l’inférence ; une fois désactivées, la vitesse devrait égaler celle des autres apps llama.cpp.
  • Temps de chauffe : l’entraînement peut sembler plus lent au début, car torch.compile met généralement environ 5 minutes ou plus pour chauffer et terminer la compilation.
  • Modèles exportés : quand un modèle qui fonctionnait dans Unsloth produit une sortie médiocre, incohérente ou répétitive dans Ollama, vLLM ou un autre environnement d’exécution, la cause la plus fréquente est un modèle de chat (chat template) incorrect ; celui utilisé à l’entraînement doit aussi y être utilisé.

Confidentialité, sécurité et licences

  • Télémétrie : Unsloth Desktop déclare n’avoir aucune télémétrie ; il détecte votre type de GPU et votre appareil pour la compatibilité et peut fonctionner entièrement hors ligne.
  • Contrôle d’accès de Studio : Unsloth Studio peut être utilisé entièrement hors ligne et repose sur une authentification par jeton avec mots de passe chiffrés et flux JWT d’accès et de rafraîchissement.
  • Autorisations des outils : grâce aux contrôles d’autorisation, le modèle et Unsloth ne peuvent ni accéder à vos fichiers, ni les modifier ou les éditer, ni utiliser Internet sans votre approbation.
  • Serveurs exposés : les outils côté serveur (recherche web, exécution de code Python et terminal) s’exécutent sous votre compte utilisateur et sont activés par défaut, si bien que toute personne pouvant joindre le serveur avec la clé API peut exécuter du code sur la machine ; la documentation associe l’exposition au flag --disable-tools.
  • Partage des licences : le fichier LICENSE du dépôt place la bibliothèque principale, les tests et les scripts sous Apache 2.0, tandis que les dossiers Studio et CLI, à installation facultative, sont sous licence AGPLv3 (studio/* et unsloth_cli/*).

FAQ

Q1. Unsloth est-il gratuit ?

Unsloth Desktop est décrit comme une application gratuite et open source, et la formule Free correspond à la version standard. Unsloth Pro et Unsloth Enterprise existent, mais la page de tarifs affiche Contact us au lieu d’un prix.

Q2. Faut-il un GPU NVIDIA ?

Pas pour toutes les tâches. Chat et Data Recipes fonctionnent sur CPU, et l’entraînement dans Studio prend en charge les appareils NVIDIA, AMD, MLX et Intel. Pour l’entraînement sous Windows, un GPU NVIDIA figure parmi les prérequis.

Q3. Unsloth peut-il utiliser des modèles déjà téléchargés ?

Oui. Les modèles déjà téléchargés sont détectés automatiquement, et vous pouvez indiquer des dossiers personnalisés s’ils ne le sont pas.

Q4. Un modèle entraîné dans Unsloth peut-il tourner dans Ollama ou LM Studio ?

Oui. Unsloth exporte en GGUF ou safetensors pour des environnements d’exécution comme llama.cpp, Ollama, vLLM et LM Studio, à condition que le modèle de chat corresponde à celui utilisé à l’entraînement.

Q5. Quelle licence s’applique à Unsloth ?

Le package principal est sous Apache 2.0, tandis que des composants optionnels comme l’interface Unsloth Studio sont sous AGPL-3.0.

Connaissez-vous un outil similaire ?
Si vous connaissez d'autres excellents outils IA, n'hésitez pas à nous les soumettre