Replicate est une plateforme cloud qui exécute, affine et héberge des modèles d'IA derrière une seule API HTTP. La plupart des modèles sont facturés à la seconde de GPU, les modèles officiels à la sortie produite, et le crédit s'achète d'avance.
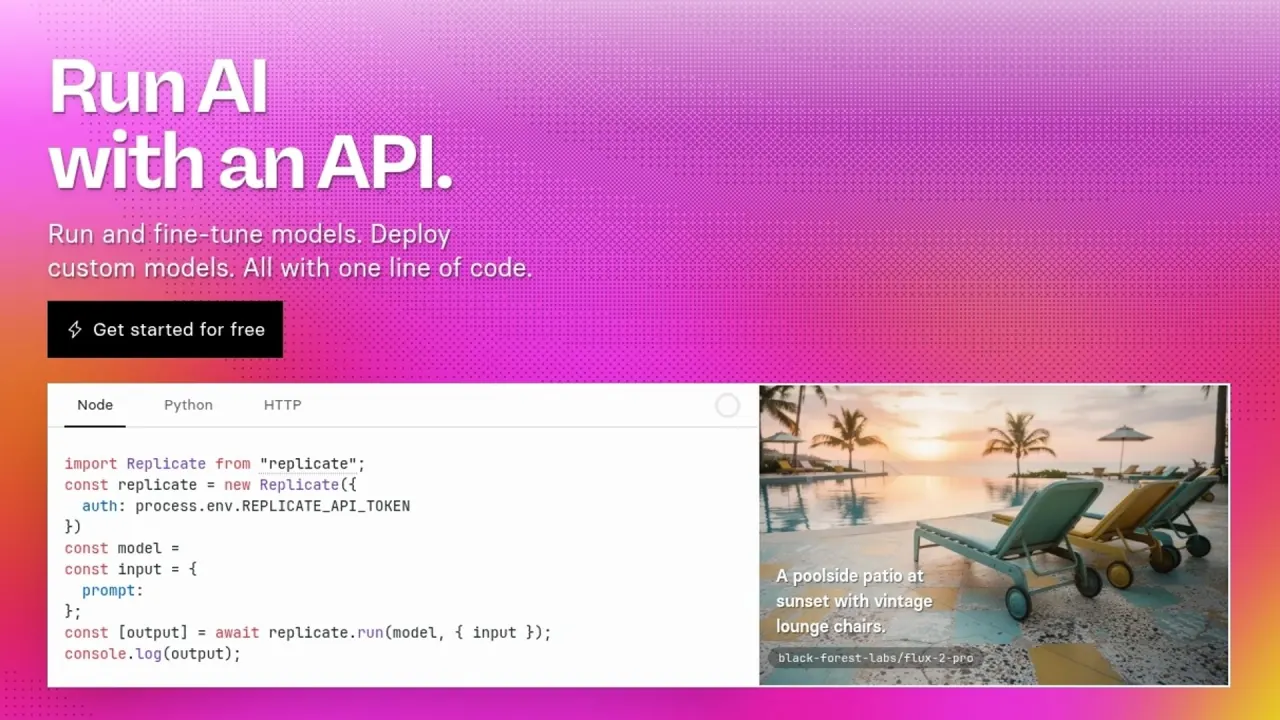
Replicate vous permet d'exécuter des modèles d'IA avec une API cloud, sans comprendre le machine learning ni gérer votre infrastructure. Une requête HTTP envoie une entrée vers un modèle d'image, de vidéo, d'audio ou de langage et renvoie le résultat : aucun GPU à louer, aucun conteneur à construire. C'est une API de modèles IA, rien de plus.
Trois métiers se cachent derrière cette interface : exécuter un modèle publié par quelqu'un d'autre, en affiner un sur vos données, déployer du code que vous avez empaqueté. Chacun tient en une ligne de code.
L'opérateur est Replicate, LLC., au 101 Townsend Street à San Francisco. Le 17 novembre 2025, la propriété a changé : « la principale plateforme d'exécution de modèles d'IA » a annoncé rejoindre Cloudflare. La surface produit a été explicitement exclue — l'éditeur affirme que l'API ne change pas et que les modèles utilisés aujourd'hui continueront de fonctionner, et l'acquéreur a pris le même engagement : les API et workflows des utilisateurs existants continueront sans interruption. Le développement non plus ne s'est pas arrêté : la dernière entrée du journal ajoute des fichiers d'instructions Markdown qui donnent aux assistants de code une connaissance experte des modèles d'IA sur cette plateforme.
La taille du catalogue reste un chiffre d'éditeur : l'annonce de rachat évoque plus de 50 000 modèles open source et modèles affinés, et aucun décompte indépendant n'est ressorti des canaux vérifiés ce tour-ci.
Une seule API donne accès à quatre objets dont la latence et le coût diffèrent :
« Un modèle sur la plateforme » ne correspond donc pas à un profil de performance unique : les modèles officiels restent chauds et prêts à répondre, ce qui permet de les exécuter sans se soucier des démarrages à froid, tandis qu'un modèle communautaire peu utilisé est d'abord chargé depuis zéro.
La capacité évolue dans les deux sens sans configuration : en cas d'afflux de trafic, la plateforme monte automatiquement en charge, et redescend à zéro lorsqu'elle est inactive. Quand ce défaut est trop souple, la fonctionnalité de déploiement (deployment) permet notamment de contrôler le matériel et les paramètres de mise à l'échelle de n'importe quel modèle. Côté équipe, les organisations (organization) partagent l'accès aux modèles, aux jetons d'API, à la facturation et aux tableaux de bord.
Le filtre de sécurité par défaut couvre un périmètre plus étroit que son nom ne le suggère : pour les prédictions lancées depuis le web, il n'est activé que sur le modèle de base SDXL, le modèle de base Flux et tous leurs affinages dérivés. Une sortie de secours existe — vous pouvez désactiver le vérificateur de sécurité lorsque vous exécutez le modèle via l'API — ce qui laisse le chemin API sans filtre garanti.
La première intégration est courte, mais deux de ces étapes coûtent peu maintenant et cher plus tard.
Les capacités documentées correspondent à un ensemble de tâches étroit.
Les mêmes faits tracent la frontière : temps de réponse garanti, exécution de plus de trente minutes ou sorties stockées pour être récupérées plus tard sortent du périmètre documenté d'un compte standard.
Elle convient aux équipes logicielles qui veulent de l'inférence GPU sans serveur sans posséder la pile de machine learning, et qui peuvent absorber une facture variable plutôt que d'exploiter des clusters. Elle convient aussi aux auteurs de modèles : publication et affinage y sont des opérations de premier ordre.
Quatre situations conviennent mal, et chacune remonte à une clause publiée :
Tout est accessible en HTTP. Les clients maison couvrent Node.js, Python, Swift et Go, plus un client MCP hébergé ; les autres écosystèmes, Elixir par exemple, sont maintenus par des contributeurs et non par l'éditeur, ce qui change le support que vous pouvez espérer.
Un parcours navigateur existe aussi : c'est le moyen le plus rapide d'inspecter les entrées d'un modèle avant d'écrire du code.
Les tarifs Replicate n'ont aucun palier d'abonnement. Vous ne payez que ce que vous consommez : certains modèles sont facturés au matériel et au temps, d'autres à l'entrée et à la sortie. Le compteur applicable dépend du modèle, pas de votre compte. Sur le compteur temporel, le tarif suit le matériel :
| Matériel | Par seconde | Par heure |
|---|---|---|
| Nvidia T4 | $0.000225 | $0.81 |
| Nvidia L40S | $0.000975 | $3.51 |
| Nvidia A100 (80 Go) | $0.001400 | $5.04 |
| Nvidia H100 | $0.001525 | $5.49 |
Ce sont des prix par seconde d'exécution, pas par requête : la plupart des modèles sont facturés selon le temps qu'ils mettent à s'exécuter, et le prix à la seconde varie selon le matériel utilisé, si bien qu'une même invite coûte davantage sur un modèle plus lourd. Le compteur de sortie fonctionne à l'inverse : les modèles officiels sont tarifés selon des métriques prévisibles comme le nombre d'images générées, les secondes de vidéo ou les jetons d'entrée et de sortie, avec des exemples allant de $0.04 par image générée à $3.75 par million de jetons d'entrée. Un budget par requête ne se calcule d'avance que de ce côté, et les paliers les plus élevés ne relèvent pas du libre-service : la capacité multi-GPU H100 supplémentaire est disponible dans le cadre de contrats d'engagement de dépenses.
Le démarrage à froid est un problème de latence sur la capacité partagée et un problème de facturation sur la capacité dédiée. Côté partagé, quand vous utilisez un modèle public, vous ne payez que le temps pendant lequel il traite activement vos requêtes ; la mise en route et l'inactivité du modèle sont gratuites. L'attente reste réelle : dans certains cas, ce processus peut prendre plusieurs minutes. Elle ne dépend pas entièrement de vous, puisque par défaut vous partagez un pool matériel avec d'autres clients et que vos requêtes entrent dans une file commune.
Supprimer l'attente déplace le compteur. Sur la capacité dédiée, vous payez tout le temps pendant lequel les instances sont en ligne : le temps passé à démarrer, le temps passé inactives à attendre des requêtes, et le temps passé à traiter activement vos requêtes. Les affinages à démarrage rapide font exception et ne sont facturés que sur le temps de traitement actif, publics comme privés.
L'accès gratuit existe, borné et non chiffré. Vous pouvez exécuter gratuitement une sélection de modèles, puis la configuration de la facturation vous sera demandée — sans montant, sans liste de modèles ni durée. Les comptes non approvisionnés sont bridés : si un crédit vous a été accordé sans moyen de paiement enregistré, vous êtes limité à 1 requête par seconde et à 6 requêtes par minute au maximum.
L'accès payant est prépayé et expire. Le crédit acheté est valable 1 an à compter de l'achat et n'est pas remboursable en dehors de ce que la loi impose ; le contrat reprend la règle : chaque paiement destiné à alimenter le solde prépayé expire à la fin du douzième mois suivant la date de paiement s'il n'a pas été entièrement consommé. Le rechargement automatique comporte des planchers — seuil minimal de $5, solde de recharge minimal de $15 — et dès que le solde tombe à zéro, tout nouveau travail est bloqué et l'infrastructure en cours est arrêtée.
Les conditions entreprise se négocient : gestionnaire de compte dédié, support prioritaire, limites GPU plus élevées et SLA de performance, avec des remises sur volume liées à un engagement de dépenses.
Deux faits font l'essentiel de la comparaison. Le premier est l'étendue : les utilisateurs entreprise accèdent à plus de 50 000 modèles via une seule API et un seul contrat, ce qui n'est pas la proposition d'un service réglé pour une seule modalité. Le second est que la configuration la moins chère est la configuration partagée, celle où vous rencontrerez parfois des démarrages à froid ou des limites de mise à l'échelle selon la façon dont les autres clients utilisent le modèle.
Les sources indépendantes nomment le terrain sans le classer. Un article technique signé, publié au lancement de l'entreprise en février 2023, décrivait un marché encombré : la startup est en concurrence avec des fournisseurs comme Hugging Face et OctoML, et dans une certaine mesure Runway ML, qui ont collectivement levé des centaines de millions de dollars. Une discussion publique entre développeurs a produit plus tard une liste de praticiens plus longue — combien d'acteurs compte ce secteur ? Replicate, RunPod, Modal, Northflank, FAL.
Trois questions les départagent : le fournisseur publie-t-il un tarif matériel à la seconde ou seulement un prix à la sortie ; facture-t-il l'inactivité une fois les instances fixées ; conserve-t-il vos sorties ou les supprime-t-il par minuterie. Aucun banc d'essai indépendant n'a atteint le seuil de qualité de source ce tour-ci : les pages de comparaison remontées venaient de plateformes concurrentes ou d'agrégateurs rémunérés à l'apport d'affaires.
La documentation et le contrat divergent sur le travail qui échoue. La documentation de facturation indique qu'une exécution ratée n'est facturée sur aucun modèle, tandis que l'annulation d'une exécution sur un modèle officiel peut malgré tout être facturée. Les conditions énoncent l'inverse : les exécutions partielles et les tentatives échouées sont facturables selon le point d'échec exact enregistré dans les journaux de l'éditeur. Une troisième règle couvre les modèles enchaînés : si le modèle échoue, la durée de l'exécution vous est facturée, plus le coût des modèles en aval appelés avant l'échec. Ces pages ne sont pas cohérentes, et ces mêmes journaux tranchent les litiges de facturation : une charge de travail sujette aux échecs a besoin d'une confirmation écrite de la règle applicable.
Rien n'est verrouillé contractuellement en libre-service. L'éditeur se réserve le droit, à sa seule discrétion, d'apporter à tout moment des modifications au service, y compris en limitant ou en supprimant certaines fonctionnalités, de façon temporaire ou permanente, et sans préavis. Faute d'engagement sur la disponibilité, un modèle dont dépend votre produit peut disparaître sans préavis : figez les versions et gardez un repli. Le règlement des litiges est encadré : les conditions sont régies par le droit de l'État de Californie et aucune procédure d'arbitrage collectif n'est autorisée.
Une interface uniforme masque des licences qui ne le sont pas : vous ne devez pas utiliser de modèles de machine learning en violation des restrictions de licence open source de leur propriétaire. Licences permissives, usage réservé à la recherche et conditions propriétaires cohabitent derrière le même appel.
La rétention est asymétrique. Les prédictions passées par l'API sont effacées par une minuterie d'une heure, alors que les données des prédictions créées via l'interface web sont conservées indéfiniment : c'est le parcours navigateur qui accumule un historique. La surveillance est explicite : l'éditeur se réserve le droit de surveiller votre utilisation du service afin de vérifier le respect de cette politique, ce qui inclut des examens automatisés et manuels des contenus et des activités. La politique de confidentialité avertit que les données d'entraînement téléversées peuvent contenir tout type d'informations, dont certaines pourraient être considérées comme « sensibles » au regard de diverses lois sur la vie privée.
Les droits sur les sorties sont larges mais conditionnels. L'éditeur vous concède l'ensemble des droits, titres et intérêts éventuels sur la sortie, y compris l'usage commercial comme la vente ou la publication, sous réserve des conditions tierces applicables — cette réserve étant la licence du modèle qui a produit la sortie. En échange, vous concédez sur vos entrées une licence limitée à ce qui est nécessaire pour fournir la sortie, entraîner et générer des modèles dérivés du client, fournir le service selon les conditions, et créer et compiler les Resultant Data. Quant à savoir si ces entrées entraînent les modèles propres à l'éditeur, les politiques publiées ne disent ni oui ni non.
La plateforme déclare ne pas « vendre » ni « partager » de données personnelles au sens des lois d'États américains sur la vie privée, et la politique indique qu'aucune donnée personnelle n'est collectée intentionnellement auprès d'enfants de moins de 16 ans.
Une enveloppe gratuite bornée, pas une formule gratuite : une sélection de modèles s'exécute gratuitement jusqu'à ce que la configuration de la facturation soit demandée, et ni quota, ni durée, ni liste de modèles ne sont publiés. Tant qu'aucun moyen de paiement n'est enregistré, le débit est plafonné à une requête par seconde.
Pas sur les modèles publics, où le temps de mise en route et le temps d'inactivité sont gratuits. Cela change dès que vous fixez de la capacité : les instances dédiées et les déploiements facturent aussi la mise en route et l'inactivité.
Oui. Le crédit est valable un an à compter de l'achat et le contrat précise que chaque paiement expire à la fin du douzième mois suivant son règlement s'il n'est pas entièrement consommé. Les soldes prépayés ne sont pas remboursables, sauf lorsque la loi l'exige ou que l'accord le prévoit expressément.
Pas par défaut côté API : entrées, sorties, fichiers et journaux sont supprimés au bout d'une heure, ce qui impose de copier ailleurs ce que vous voulez garder. Seules les prédictions créées dans le navigateur restent jusqu'à ce que vous les supprimiez.
