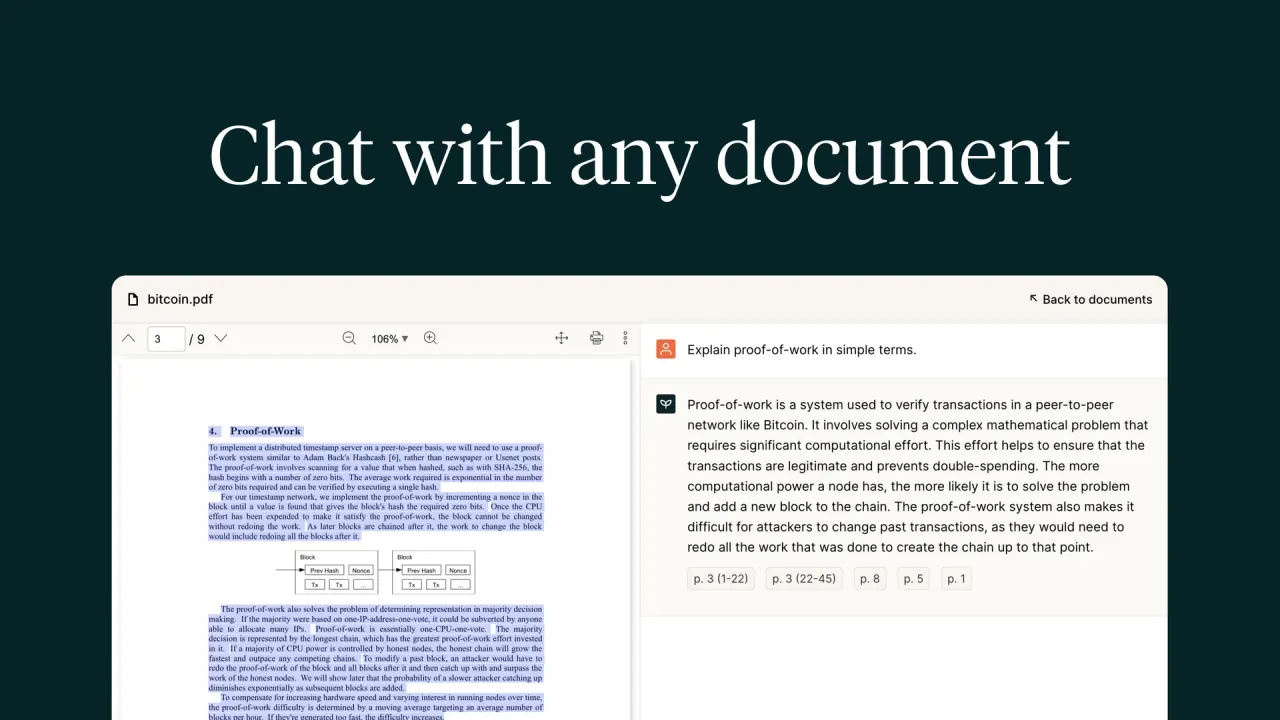
Posez des questions sur plusieurs PDF, obtenez des résumés ou transformez vos documents en données structurées. Une API distincte propose analyse, extraction par schéma, détection de sections et questions documentaires.
Vous avez utilisé cet outil ? Notez-le
Vous avez utilisé cet outil ? Notez-le
PDF.ai est un service de chat PDF et une plateforme pour développeurs permettant de poser des questions, de résumer des documents et de trouver des informations dans des fichiers PDF. L’expérience web repose sur la conversation avec les documents ; son API PDF propose analyse, extraction structurée, identification de sections et questions sur les fichiers traités. Ces deux voies d’accès ont des tarifs et des mesures d’utilisation distincts.
L’offre pour développeurs vise à transformer les PDF en données structurées, à extraire des champs personnalisés et à identifier intelligemment des sections. Le produit concerne ainsi aussi bien la personne qui lit un document que le développeur qui transfère son contenu vers une autre application.
Le point de terminaison v2 Parse convertit un PDF en Markdown ou en JSON et prend en charge l’OCR, la mise en forme des tableaux et l’extraction d’images.
Deux modes de qualité d’analyse sont décrits. Standard est le mode par défaut et permet de choisir la langue de l’OCR ; son paramètre de liste de langues utilise l’anglais par défaut. Advanced utilise des modèles vision-langage et est présenté comme pouvant offrir une meilleure précision sur les documents complexes, sans sélection de langue. Ce caractère éventuel compte : la documentation décrit une option de traitement, pas une précision mesurée et garantie pour chaque mise en page ou numérisation.
L’extraction de documents s’appuie sur un schéma JSON fourni pour définir les champs à renvoyer. Le point de terminaison v2 Extract retourne des données structurées avec des citations reliant chaque champ à des passages sources du document.
Le point de terminaison v2 Split identifie des sections à partir des descriptions fournies et renvoie les pages qui les contiennent, avec des niveaux de confiance. L’entrée décrivant les sections est un tableau JSON ; chaque objet exige un nom et peut aussi comporter une description.
Le point de terminaison v2 Ask accepte des questions sur un ou plusieurs documents déjà analysés. L’entreprise indique qu’il inclut le contexte complet des documents, et la requête fournit un tableau d’identifiants de documents. L’analyse est une condition préalable à cette voie : les identifiants du tableau doivent désigner des documents déjà traités.
La conversation multilingue fait également partie du produit web. Un PDF peut être dans une langue et la question dans une autre ; selon le fournisseur, la réponse suit la langue de la question. C’est une fonction conversationnelle : elle ne définit ni une liste complète des langues OCR ni une qualité de reconnaissance identique entre langues.
Les requêtes API sont authentifiées par une clé générée sur la page Developer. La clé n’apparaît qu’une fois, lors de sa génération ; en cas de perte, elle peut être régénérée sur la même page. Une requête sans clé renvoie une erreur.
La méthode de réutilisation documentée repose sur l’identifiant du document et les paramètres d’analyse :
Les résultats de Parse sont mis en cache pour les appels suivants utilisant un identifiant de document avec les mêmes paramètres ; une réponse en cache ne consomme aucun crédit d’analyse. La documentation précise que cette réutilisation peut aussi économiser les crédits d’analyse d’Extract et de Split.
Parse est présenté pour l’extraction de contenu, la création de bases de connaissances et les flux de génération augmentée par récupération. Dans ces flux, du Markdown ou du contenu documentaire structuré peut constituer la sortie de l’analyse.
Une bibliothèque de prompts enregistrés permet de conserver les questions favorites et de les retrouver pour des demandes récurrentes. Le fournisseur décrit aussi la modification des prompts enregistrés avec une commande en forme de crayon et la suppression des prompts inutilisés.
La fonction web de conversation avec tous les documents recherche des réponses pertinentes dans les PDF importés et affiche celui qu’elle juge le plus pertinent pour les mots-clés de la question. Elle permet d’interroger une collection existante tout en gardant un lien avec le document source sélectionné. Le comportement décrit est une recherche fondée sur la pertinence dans les fichiers importés, sans affirmer que tous les documents contribuent de façon égale à chaque réponse.
PDF.ai répond à des besoins différents selon le résultat recherché : un fichier téléchargeable dans lequel on peut effectuer des recherches, une conversation documentaire ou une réponse exploitée par du code. Ses voies OCR dans le navigateur et API rendent cette distinction explicite :
L’interface documentaire hébergée de PDF.ai est accessible sur le site web ; les intégrations pour développeurs utilisent des requêtes HTTP API. La documentation Parse fournit des exemples en cURL, Python, Node.js et PHP.
Les voies disponibles ont des points d’entrée différents :
Les prix web capturés le 29 octobre 2026 affichaient une facturation annuelle pour les offres payantes. Pro était indiqué à $10 par mois, facturé annuellement ; Ultimate à $20 par utilisateur et par mois, facturé annuellement ; Enterprise à $30 par utilisateur et par mois, facturé annuellement. Hobby était présenté comme gratuit à vie. Ce sont les tarifs annuels observés ; ils n’établissent pas le montant applicable à une sélection de facturation mensuelle.
| Offre web | Prix capturé | Imports PDF mensuels | Questions mensuelles | OCR par fichier | Taille maximale du fichier |
|---|---|---|---|---|---|
| Hobby | $0, gratuit à vie | 1 | 100 | 2 pages | 10MB |
| Pro | $10/mois, facturé annuellement | 100 | 1,000 | 10 pages | 50MB |
| Ultimate | $20/utilisateur/mois, facturé annuellement | Illimité | Illimité | 50 pages | 50MB |
| Enterprise | $30/utilisateur/mois, facturé annuellement | Illimité | Illimité | 100 pages | 100MB |
Les quotas mensuels d’imports et de questions sont des compteurs séparés.
L’OCR comporte un quota de pages par fichier, tandis que la taille maximale s’exprime en MB. Le fournisseur distingue explicitement ces plafonds OCR du produit du tableau des crédits API. La limite de pages OCR ne peut donc pas être interprétée comme un quota de crédits API ; un fichier respectant la taille maximale ne prouve pas, à lui seul, que toutes ses pages numérisées entrent dans le quota OCR de l’offre.
La documentation des crédits v2 présente une offre API gratuite de 200 crédits par mois, sans carte bancaire requise. Ses niveaux mensuels payants comportent les quotas ci-dessous ; ils sont distincts des offres web précédentes.
| Prix mensuel API | Crédits par mois |
|---|---|
| $0 | 200 |
| $49 | 3,000 |
| $99 | 10,000 |
| $249 | 30,000 |
| $599 | 100,000 |
Parse coûte 1 crédit par page en mode standard et 2 crédits par page en mode avancé. Lorsque le traitement optionnel des images par LLM est activé, le coût supplémentaire documenté est de 1 crédit par groupe de cinq images, arrondi au supérieur. Les résultats d’analyse en cache avec les mêmes paramètres ne consomment aucun crédit d’analyse : un traitement répété et une première analyse ont donc des composantes de coût différentes.
Extract calcule les frais d’extraction selon la taille du schéma : jusqu’à cinq champs, le coût est de 2 crédits par page ; au-delà de cinq champs, il passe à 4 crédits par page. Les frais d’analyse applicables s’ajoutent en l’absence de résultat analysé en cache. Les exemples du point de terminaison distinguent l’extraction de l’analyse initiale, au lieu de considérer l’extraction comme un montant forfaitaire par requête.
Le bref aperçu des crédits désigne plutôt les deux tarifs Extract par « Standard » et « Advanced », à 2 et 4 crédits par page. La référence du point de terminaison utilise le nombre de champs pour cette distinction. Ces descriptions publiées ne sont pas identiques ; les deux formulations restent ici séparées, sans les fusionner en une règle inventée.
Split facture 2 crédits par page, en plus de l’analyse applicable. Sa documentation indique que transmettre un identifiant de document évite les crédits d’analyse, tandis que fournir un fichier ou une URL déclenche une analyse lors de l’appel. Réutiliser le contenu analysé modifie cette composante d’analyse ; les frais Split restent une partie de l’opération.
Ask facture 3 crédits multipliés par le nombre total de pages de tous les documents interrogés. L’exemple documenté combine un document de 10 pages et un autre de 5 pages pour 45 crédits. La facturation dépend du total intégral des pages de la requête ; elle n’est pas décrite comme trois crédits par question quel que soit le nombre de documents concernés.
La politique de résiliation publiée indique qu’aucun remboursement partiel ou intégral n’est proposé. Elle autorise la résiliation à tout moment via le Stripe Portal et précise qu’aucuns frais supplémentaires ne seront facturés après résiliation. La résiliation et l’éligibilité à un remboursement sont donc deux sujets distincts : pouvoir arrêter un abonnement n’est pas une promesse de rembourser une somme déjà débitée.
Deux alternatives répondent à des besoins proches de conversation documentaire, avec des priorités différentes. Les distinctions suivantes proviennent des descriptions de chaque concurrent et ne constituent pas une validation indépendante de la précision de l’un ou l’autre service.
La documentation API dédiée Legacy v1 indique un maximum de 100MB pour les imports PDF par URL et de 4.5MB pour les envois directs de fichiers, avec 500 requêtes par minute. Elle ne fixe pas de limite de pages mais décrit un délai d’expiration de 60 secondes pour l’import de PDF ayant beaucoup de pages. La même référence marque l’ancienne offre API Ultimate comme n’étant plus prise en charge. Il s’agit de déclarations Legacy v1, pas de limites universelles attribuées au web ou aux points de terminaison v2 actuels.
Les modèles nommés ont aussi une frontière de version. La référence de chat Legacy v1 cite gpt-4o et gpt-4-turbo, respectivement à 2 et 4 crédits par message, ainsi qu’un paramètre de langue de réponse. Cette description par message appartient à v1 ; elle ne remplace pas la formule par pages de v2 Ask et n’identifie pas le modèle derrière un niveau web Basic ou Advanced.
La politique de confidentialité décrit les coordonnées fournies volontairement, les cookies et informations d’appareil, ainsi que des mesures raisonnables pour protéger les données personnelles. Elle indique que les informations personnelles ne sont ni vendues ni partagées avec des tiers, sauf obligation légale ou nécessité de répondre aux demandes. Les exceptions font partie de cette déclaration : ce n’est pas une promesse inconditionnelle qu’aucun tiers ne reçoive jamais d’information.
La politique de confidentialité examinée ne précise pas la durée de conservation des documents importés ni si les contenus importés servent à entraîner des modèles d’IA. Cette limite de divulgation importe pour les fichiers sensibles : le texte général sur les données personnelles ne documente pas, à lui seul, combien de temps un PDF, son texte extrait ou son contenu conversationnel restent disponibles.
Un guide du fournisseur décrit séparément une option de document privé. Il indique que le fichier PDF privé ne sera pas envoyé vers les systèmes de l’entreprise, que l’affichage du document devient indisponible et que le chat reste possible. L’option doit être définie avant le début de l’import. Cette déclaration concerne le mode de fichier privé ; elle n’établit ni une architecture entièrement locale ni un engagement de non-entraînement pour toutes les informations impliquées dans une conversation.
La section marketing pour développeurs indique que les fichiers sont supprimés après traitement. La référence de suppression v2 décrit séparément un fichier PDF stocké, un enregistrement documentaire et des résultats d’analyse en cache pouvant être supprimés définitivement. Ces descriptions laissent le calendrier de conservation automatique indéterminé ; la phrase marketing ne remplace pas le comportement précis de stockage et de suppression du point de terminaison.
Le point de terminaison v2 Delete s’applique uniquement aux documents créés via v2 Parse, Extract ou Split. Il supprime définitivement l’enregistrement documentaire associé, le fichier importé stocké et les résultats d’analyse en cache ; l’opération est irréversible et ne coûte aucun crédit API. Sa portée n’établit pas un mécanisme de suppression identique pour toutes les autres voies du produit ou les anciens points de terminaison.
La suppression de documents web a une procédure documentée distincte : ouvrir Documents dans le tableau de bord, sélectionner la corbeille à côté d’un fichier, puis répondre à la fenêtre demandant s’il faut le retirer définitivement du compte. Cette instruction au niveau du compte décrit un contrôle utilisateur. Elle ne donne pas de durée de conservation fixe et ne résout pas la question distincte de l’utilisation pour l’entraînement de l’IA.
Non. Hobby prévoit un import PDF et 100 questions par mois. L’offre API gratuite prévoit, elle, 200 crédits mensuels, dont la consommation dépend du point de terminaison et du nombre de pages.
Oui. Le fournisseur décrit l’import d’un PDF dans une langue et des questions dans une autre, avec des réponses dans la langue de la question. Le choix de langue OCR constitue un paramètre d’analyse distinct.
La politique publiée permet la résiliation via le Stripe Portal, mais exclut les remboursements partiels et intégraux. Arrêter les frais futurs et rembourser un débit existant relèvent de politiques différentes.
