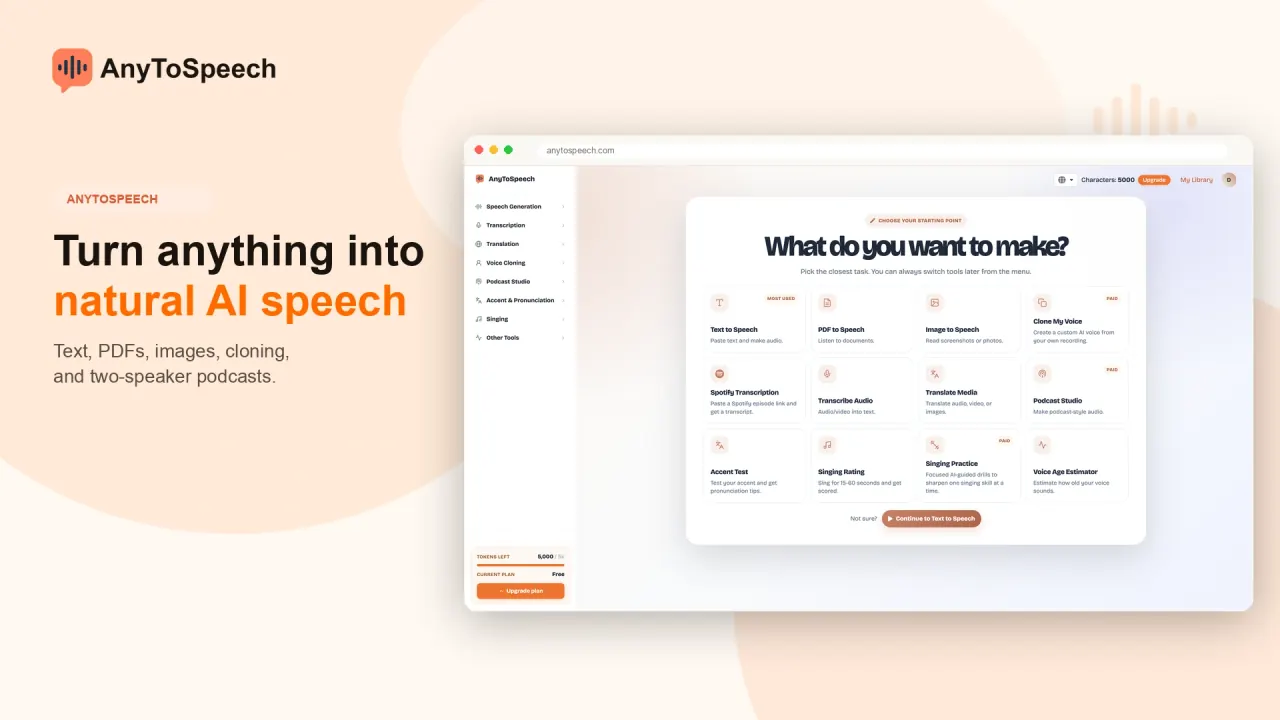
Transformez textes et documents en audio, transcrivez des enregistrements, créez des dialogues et podcasts, et analysez votre accent ou votre chant. Navigateur, mobile et MCP partagent le compte AnyToSpeech.
Vous avez utilisé cet outil ? Notez-le
Vous avez utilisé cet outil ? Notez-le
AnyToSpeech associe génération de parole, transcription, traduction et analyse vocale dans un même service. L'écoute de documents, les conversations scénarisées, les voix personnalisées et de brèves évaluations vocales complètent ces fonctions principales.
La synthèse vocale transforme du texte brut, des documents ou des PDF en audio, avec un choix de voix et un téléchargement MP3. Le service propose des parcours de création distincts pour lire des documents, interpréter un scénario écrit et composer une conversation à partir d'un thème.
L'accès varie selon la fonction : aperçu gratuit, quota mensuel et génération payante correspondent à des offres distinctes.
Les transcriptions terminées sont récupérables dans My Library sans laisser la page de traitement ouverte. La fonction de transcription annonce aussi la traduction et le téléchargement aux formats TXT ou DOCX.
La bibliothèque de voix comprend des extraits et des filtres par langue, genre, ton et accent. Le filtre de genre propose les options féminine, masculine et neutre.
Le clonage vocal commence par trois enregistrements guidés de 10–15 secondes chacun. L'enregistrement dans le navigateur et l'envoi de fichiers WAV, MP3 ou M4A existants sont pris en charge. Le clone obtenu devient une voix réutilisable au sein du service.
La FAQ du clonage indique 27 langues, dont l'anglais, le français, l'espagnol, l'allemand, le portugais brésilien, le japonais, le coréen, le chinois et l'arabe. Ce chiffre concerne le clonage et ne constitue pas un total commun à tous les outils. Voice Design énumère séparément l'anglais, le français, l'espagnol, l'allemand, le portugais, l'italien, le japonais, le coréen et le chinois.
Voice Design accepte soit 13 attributs structurés, soit une description libre de 30–250 caractères. Les attributs couvrent le dialecte, le genre, l'âge, l'émotion, le ton, la hauteur, le volume, la vitesse, la clarté, la fluidité, la personnalité, la texture et l'environnement. Aucun enregistrement n'est nécessaire pour ce parcours fondé sur une description.
Chaque demande Voice Design produit trois aperçus vocaux à comparer. Une fois enregistré, le résultat devient une voix personnalisée disponible dans les outils AnyToSpeech compatibles. La formulation de l'accès demande de la prudence : Voice Design est présenté comme une fonction Pro, mais aussi comme inclus avec le clonage dans les abonnements payants. Ces termes ne le réservent pas clairement au seul niveau du site nommé Pro.
Multi-Speaker Text to Speech prend en charge deux à six intervenants, des pauses et des indications émotionnelles, puis mixe la conversation en un MP3 unique. L'utilisateur rédige le dialogue et décide qui prononce chaque réplique.
Podcast Studio génère à partir d'un thème un MP3 à deux voix, avec une musique d'introduction et un titre d'épisode prononcé. Il accepte aussi un scénario préparé. L'introduction fait partie de l'épisode généré.
Les épisodes créés à partir d'un thème visent une durée parlée de 2, 5, 10 ou 20 minutes ; les scénarios collés peuvent contenir jusqu'à 12,000 caractères. Il s'agit, d'une part, de durées cibles et, d'autre part, d'un plafond distinct pour le scénario saisi.
English Accent Test analyse un passage lu pour estimer la langue maternelle et fournir un score de proximité avec un locuteur natif, des caractéristiques des voyelles et consonnes, ainsi qu'une analyse de l'intonation. Ce sont les catégories d'analyse déclarées par l'entreprise, et non une certification indépendante de la maîtrise de la langue.
L'analyse du chant rapporte la hauteur, le rythme, le timbre, l'étendue vocale, l'expression, le contrôle du souffle et la clarté des paroles, avec une étiquette de type de voix. Elle évalue la prestation vocale soumise.
L'éditeur à plusieurs voix permet de contrôler chaque réplique, les intervenants et les pauses.
Avant d'enregistrer un podcast IA, il est possible de relire et réécrire le scénario, de réattribuer les répliques entre les intervenants et d'ajouter des consignes d'interprétation. La page indique que la facturation intervient lorsque l'on appuie sur Record.
La timeline du podcast permet de déplacer et raccourcir les clips, de réenregistrer une réplique, de modifier le volume de chaque intervenant et d'annuler des changements. Une phrase peut être révisée sans remplacer tout l'épisode.
L'enregistrement met à jour l'épisode dans la bibliothèque ainsi que la version lue par son lien de partage. Le téléchargement fournit le dernier montage, avec la pochette intégrée au MP3.
La distinction utile porte sur le résultat recherché : conserver des répliques écrites, expliquer une source dans une discussion générée ou lire un document à voix haute.
Les aperçus gratuits, l'obligation de payer pour certaines générations et les conditions ci-dessous sur l'usage des sorties et du site constituent des limites importantes pour la production.
AnyToSpeech dispose d'applications pour iPhone et Android. La présence de points d'accès sur plusieurs plateformes ne démontre pas que chaque interface dispose de catalogues ou de limites identiques.
La configuration MCP utilise la connexion au compte pour ChatGPT, Claude, Cursor ou VS Code ; Perplexity et Meta Muse utilisent une clé d'intégration.
L'utilisation MCP consomme les crédits, minutes de transcription et limites déjà associés au compte. La création pilotée par un assistant partage donc le même budget d'utilisation que l'accès au site.
Le site propose les niveaux Free, Hobby, Standard et Pro. Le tableau reprend les prix affichés sous Monthly et les droits relevés le 29 octobre 2026. Le signe $ est le symbole affiché ; aucun code monétaire ISO n'est précisé.
| Niveau du site | Prix mensuel affiché | Caractères de parole par mois | Minutes de transcription par mois | Quota de clones vocaux |
|---|---|---|---|---|
| Free | $0 | 5,000 | 50 | Non inclus |
| Hobby | $7 | 50,000 | 200 | 1 |
| Standard | $14 | 100,000 | 1,000 | 3 |
| Pro | $69 | 1,000,000 | 5,000 | 10 |
La page tarifaire décrit les conversions vocales Free comme durant environ 30 secondes chacune et exclut les voix premium de ce niveau. La carte Free de l'accueil affiche plutôt environ 15 secondes d'audio. L'interface distincte de transcription indique un quota Free de 50 minutes par mois. Les caractères de parole et les minutes de transcription constituent deux compteurs mensuels séparés.
La parole à plusieurs voix coûte un crédit par caractère et les nouveaux comptes incluent des crédits gratuits. L'utilisation de caractères et les minutes de transcription sont mesurées séparément.
L'interface tarifaire propose Monthly et Yearly, avec la mention « Save 40%+ ». Sa FAQ de facturation continue toutefois de présenter tous les abonnements comme mensuels, indique que les allocations de caractères se renouvellent chaque mois et que les caractères inutilisés sont reportés au mois suivant. Le sélecteur annuel et cette FAQ uniquement mensuelle coexistent ; ils ne donnent pas un récit entièrement cohérent des intervalles de facturation.
Les abonnements peuvent être annulés, mis en pause, augmentés ou réduits à tout moment. Un remboursement peut être demandé par courriel dans les sept jours suivant l'achat, uniquement si le produit n'a pas été utilisé. La condition de non-utilisation fait partie de la politique : cette période n'est donc pas un essai inconditionnel de sept jours après un usage de production.
Luvvoice propose la conversion de texte en parole, avec écoute dans le navigateur et téléchargements MP3. C'est une comparaison pertinente pour transformer directement du texte en audio.
Luvvoice accepte également des documents PDF et TXT à convertir en parole. Ce recoupement concerne aussi bien l'écoute de documents que les scénarios collés ; il ne démontre pas une qualité vocale, des conditions ou des limites de production équivalentes.
Narakeet propose la conversion de documents en audio et des parcours de création de vidéos à partir de PowerPoint ou de Markdown. Son parcours vidéo à base de diapositives mérite un examen distinct lorsque le livrable comprend une présentation visuelle, en plus d'une narration ou d'un fichier audio conversationnel.
Narakeet transforme aussi des sous-titres SRT ou WebVTT en audio synchronisé avec leurs horodatages. Cela concerne les projets dont les repères temporels existants définissent le résultat.
La génération dans Podcast Studio exige un abonnement payant ; les comptes Free peuvent écouter les voix en aperçu sur la page. Un accès visible permettant d'« essayer » ne signifie donc pas qu'un compte gratuit peut produire un épisode terminé.
L'évaluateur de chant attend une prestation de 15–60 secondes et attribue au fredonnement sans paroles un score de clarté des paroles plus faible. Cette règle compte pour interpréter le résultat global : un exercice vocal sans paroles n'est pas évalué exactement comme une prestation aux paroles intelligibles.
Les conditions du site excluent les mineurs et les personnes de moins de 18 ans. Cette restriction s'applique même si les usages éducatifs et l'écoute par les étudiants font partie du positionnement du produit ; ces publics ne signifient pas que tous les utilisateurs d'âge scolaire sont admissibles.
Les voix de personnes nommées sont décrites comme des recréations par IA à des fins de divertissement, sans affiliation, vérification ni approbation par ces personnes. Le site comprend un générateur de style Donald Trump. Le résultat effectivement généré et l'autorisation des personnes nommées n'ont pas été vérifiés de façon indépendante.
Sur le générateur de voix de personnalités, les invités et comptes gratuits sont limités à cinq générations par mois civil, avec un maximum de 500 caractères chacune. Ce quota est propre à cet outil et ne doit pas être interprété comme l'allocation générale de caractères du forfait vocal.
La page marketing du clonage affiche l'appel « Start Cloning -- It's Free ». En revanche, le comparatif tarifaire exclut le clonage de Free et indique des quotas de clones sur les niveaux payants. Les formulations publiques donnent donc des impressions différentes quant à l'inclusion de la création d'un clone dans l'accès gratuit.
La carte Free de l'accueil barre l'utilisation commerciale de toutes les sorties. La page tarifaire dédiée place également l'utilisation commerciale parmi les fonctions non incluses dans Free.
La FAQ de conversion de texte en parole autorise les publications sociales monétisées, les publicités payantes, les systèmes IVR et les messages vocaux de petites entreprises, tout en ajoutant une réserve distincte pour l'usage commercial à grand volume. Les conditions du site restreignent séparément l'utilisation du site à des fins publicitaires ou marketing.
La politique de confidentialité déclare la collecte de courriels et la conservation des informations de facturation par Lemon Squeezy, auxquelles AnyToSpeech dit ne pas pouvoir accéder directement. Elle décrit aussi des journaux contenant l'adresse IP, le type de navigateur, le fournisseur d'accès, les horodatages, les pages de provenance ou de sortie et, éventuellement, le nombre de clics. Ces déclarations générales sur les visiteurs et la facturation sont distinctes des engagements relatifs à des outils audio particuliers.
La FAQ du clonage indique que les données vocales sont chiffrées en transit et au repos, que les clones restent privés au compte et que les données vocales ne sont ni partagées avec des tiers ni utilisées pour entraîner des modèles. Il s'agit d'une déclaration de l'entreprise sur les données vocales du clonage, et non d'une garantie générale de non-entraînement pour chaque document, image, transcription ou épisode généré sur la plateforme.
English Accent Test affirme supprimer l'audio immédiatement après analyse et ne pas conserver les enregistrements vocaux. L'outil de chant indique séparément traiter les clips en temps réel puis les supprimer, sans inscription ni partage. Ces descriptions de suppression concernent les parcours d'évaluation, plutôt que les épisodes de podcast enregistrés, les clones vocaux du compte ou la Library générale.
Afficher un contenu accorde à AnyToSpeech une licence non exclusive, mondiale, irrévocable et susceptible de sous-licence pour l'utiliser, le reproduire, l'adapter, le publier, le traduire et le distribuer sur tout support. Les conditions définissent largement ce contenu : audio, vidéo, texte, images et autres éléments qu'un utilisateur choisit d'afficher sur le site. Cette licence est une condition importante concernant les droits sur le contenu, aux côtés des déclarations sur les sorties et la confidentialité.
Les utilisateurs doivent posséder le contenu affiché et ne pas porter atteinte aux droits de tiers ; AnyToSpeech se réserve le droit de le retirer sans préavis. La fonction de studio vocal MCP comprend la suppression des voix personnalisées appartenant à l'utilisateur. Cette possibilité de suppression n'indique pas, à elle seule, de durée de conservation ou de délai de retrait pour chaque fichier envoyé ou généré qui s'y rapporte.
Non. Podcast Studio permet aux utilisateurs Free de préécouter les voix, tandis que la génération d'un épisode exige un abonnement payant. Cette règle d'accès diffère des crédits gratuits décrits pour un dialogue à plusieurs voix écrit manuellement.
Le produit associe la conversion PDF en audio à une voix clonée réutilisable et présente explicitement cette combinaison pour les auteurs. Le clonage vocal utilise des échantillons enregistrés ; Voice Design crée plutôt une voix à partir d'une description écrite.
Non. MCP utilise les mêmes crédits de compte, minutes de transcription et limites d'abonnement que le site. Connecter un assistant change le point d'accès aux outils, sans ajouter un abonnement de génération distinct.
