Comment Toolso relie routes linguistiques, URL canonical, hreflang et sitemap, avec un examen du code source et une vérification de deux pages.
Un annuaire d’outils d’IA remplit deux fonctions liées : aider les internautes à découvrir des logiciels utiles et donner à chaque fiche une identité stable. L’ajout de langues élargit ces deux missions. Une interface traduite peut sembler complète alors que les pages sous-jacentes ne s’accordent toujours pas sur l’URL qui représente un outil, l’existence d’une traduction ou la version qu’un moteur de recherche doit prendre en compte.
Toolso est une plateforme multilingue de découverte et de lancement d’outils d’IA. Cet article explique comment les routes linguistiques, les URL canonical, les annotations de langues alternatives et les entrées du sitemap de Toolso s’articulent, à partir d’un examen du code source et d’une vérification limitée de pages en ligne effectués le 26 octobre 2026. Il ne mesure aucune amélioration du classement et ne suppose pas que chaque fiche possède un contenu dans toutes les langues configurées.
Un bon point de départ est une question simple : lorsqu’un même outil est présenté dans plusieurs langues, chaque partie de l’application peut-elle décrire ces versions de façon cohérente ? Cette question relie les opérations éditoriales au SEO technique. Une traduction ne se résume pas à une option de menu supplémentaire : son contenu, sa route et ses métadonnées doivent concorder.
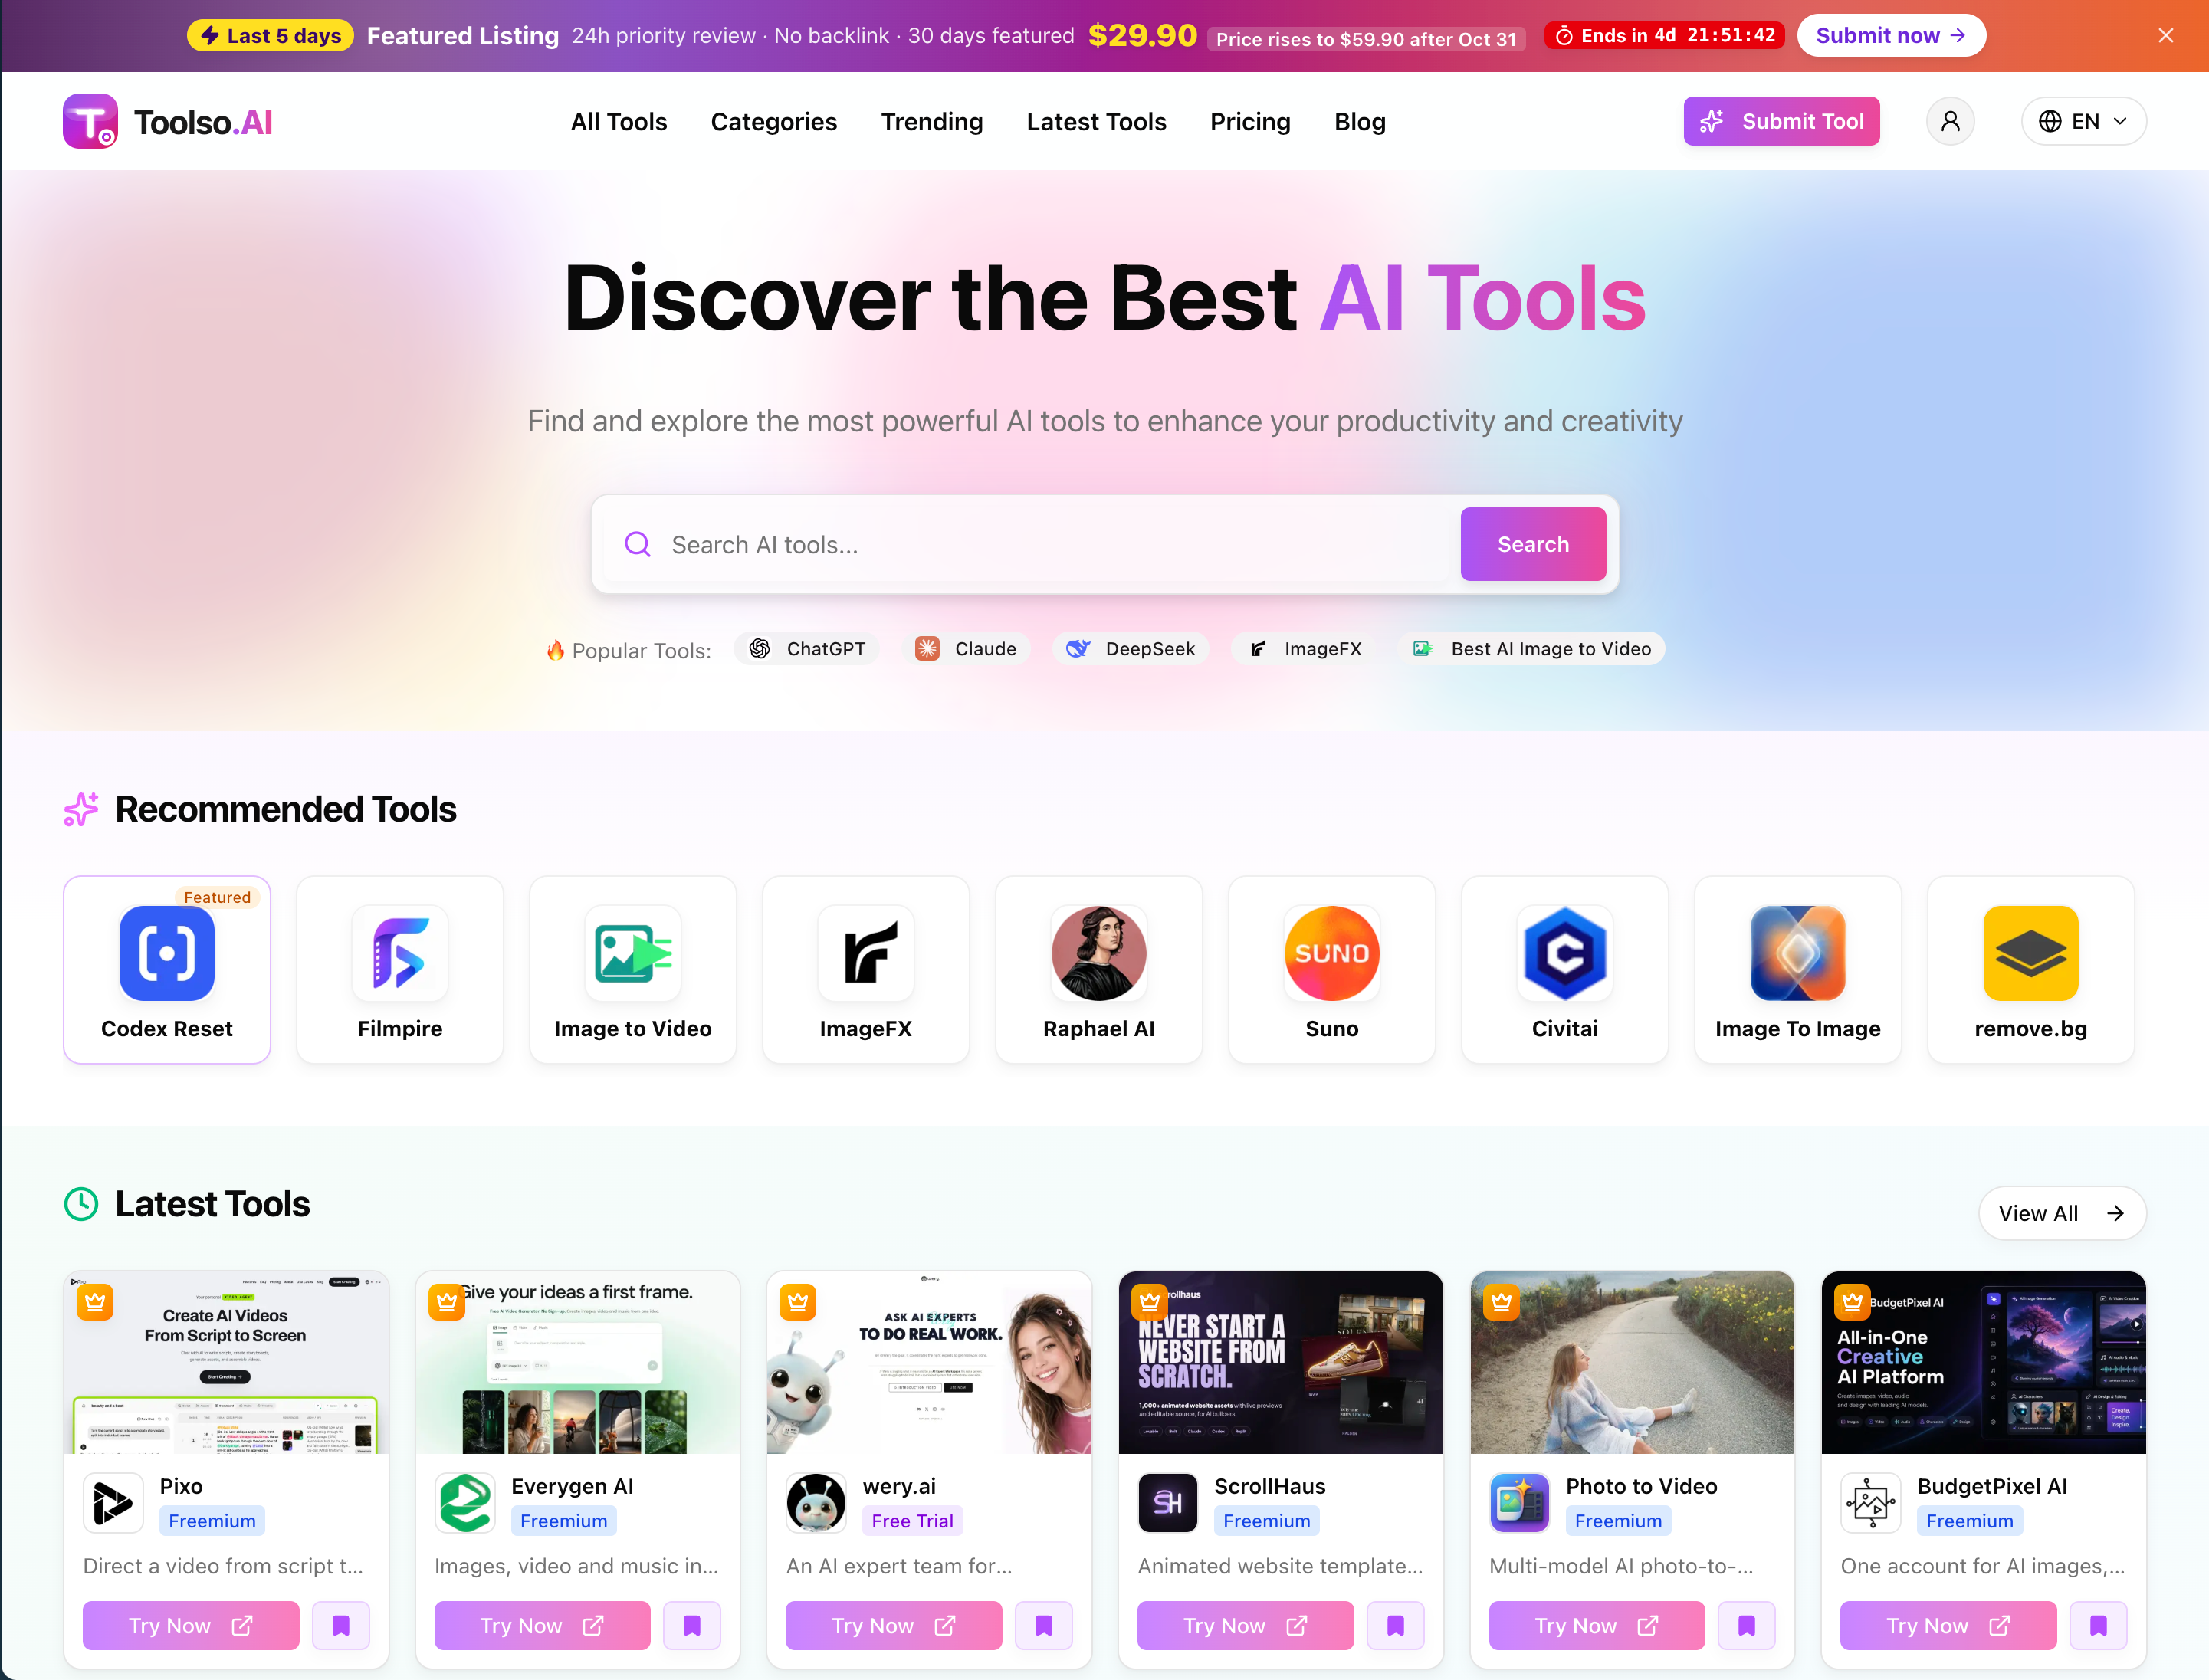
Figure 1. La page d’accueil en anglais. Capture fournie le 26 octobre 2026.
La configuration définit actuellement dix langues : l’anglais, le chinois simplifié, le chinois traditionnel, le coréen, le japonais, le français, l’allemand, le russe, l’espagnol et le portugais. L’anglais est la langue par défaut. La configuration de routage utilise les préfixes linguistiques lorsque c’est nécessaire : la langue par défaut n’a donc pas besoin d’un préfixe /en, tandis que les autres langues utilisent un préfixe.
Pour prendre un exemple réel, la fiche de Raphael AI utilise /tool/raphael en anglais et /zh/tool/raphael en chinois simplifié. Nous avons vérifié ces deux pages le 26 octobre 2026. Leurs URL canonical dans le rendu pointaient vers leurs versions linguistiques respectives.
Les clés de routage internes sont distinctes des identifiants de langue exposés aux moteurs de recherche. Dans la configuration actuelle, zh correspond à zh-CN, tw à zh-TW, es à es-ES et pt à pt-BR. Une clé interne courte est pratique pour le routage, mais elle ne doit pas devenir implicitement une annotation linguistique dont le sens serait différent.
Le routeur désactive également la détection automatique de la langue. La langue inscrite dans le chemin demandé est ainsi explicite. Cela ne signifie pas que la localisation est terminée : la traduction de la navigation, celle du contenu des fiches et l’exactitude des métadonnées restent des vérifications distinctes.
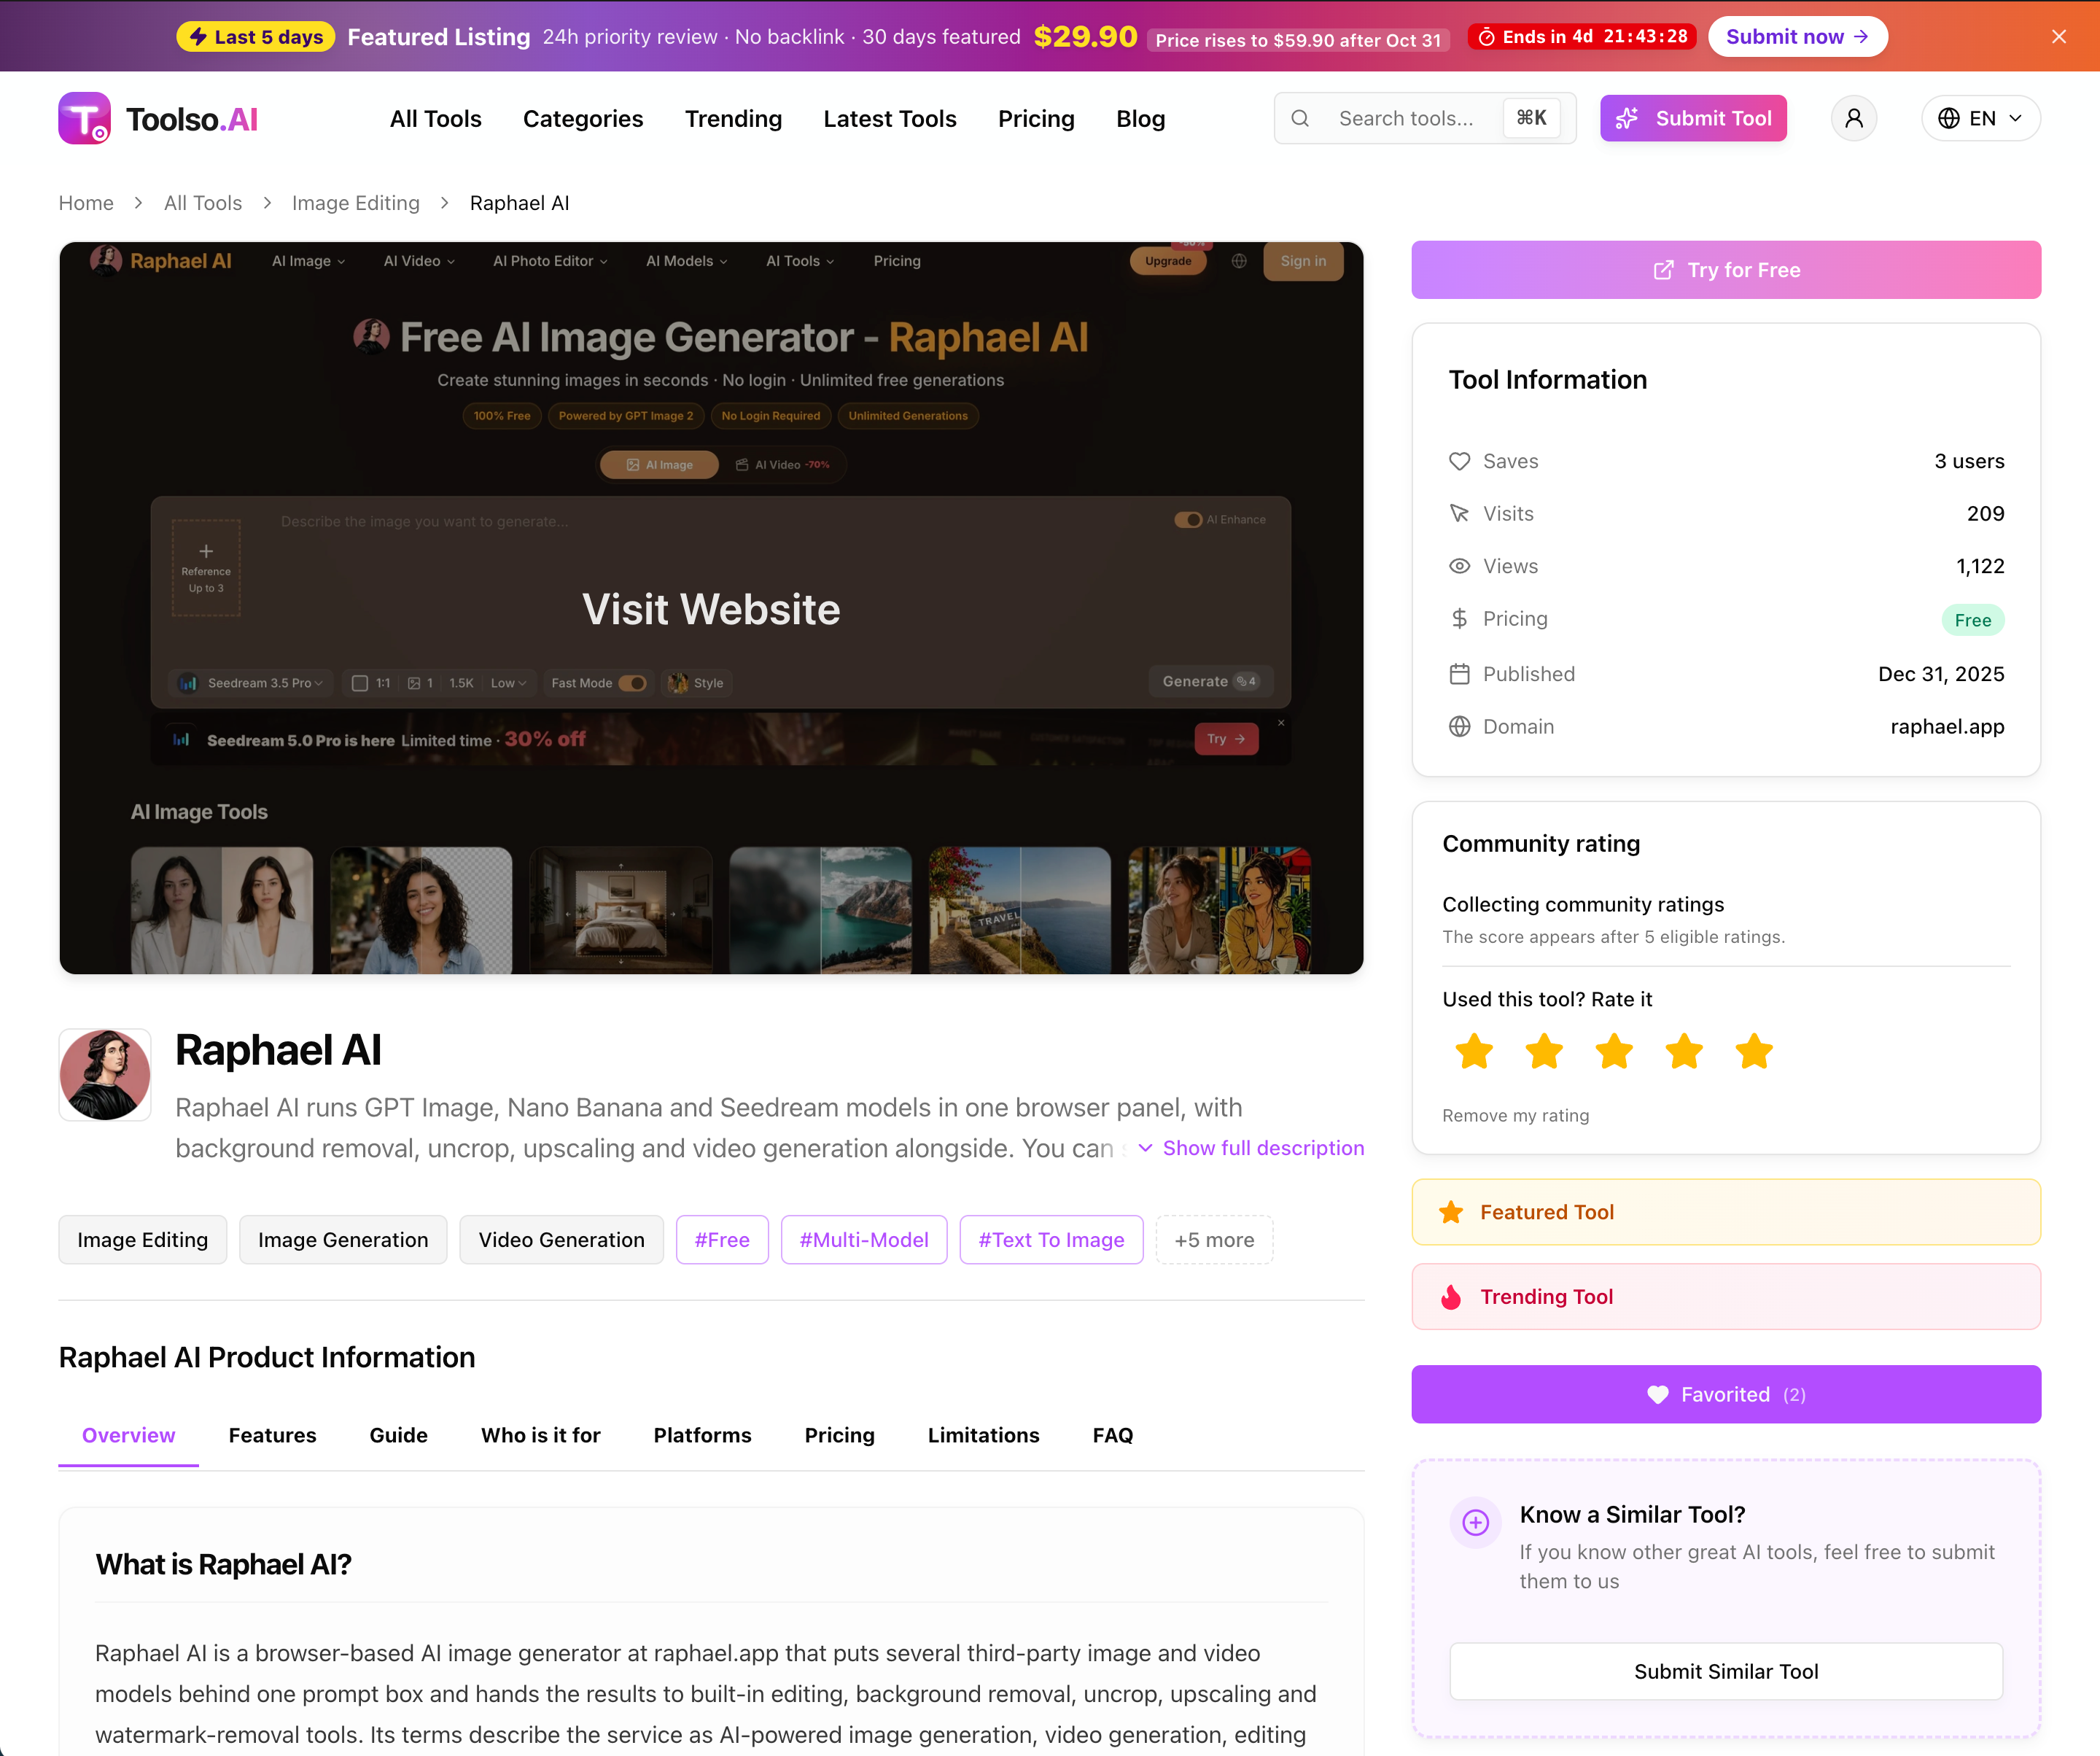
Figure 2. La fiche de Raphael AI sur Toolso. Capture fournie le 26 octobre 2026 ; elle illustre l’interface, sans valider les annotations linguistiques de la page.
De petites différences d’URL peuvent se propager lorsque les métadonnées des pages et la génération du sitemap construisent les adresses indépendamment. Un composant peut omettre la langue par défaut tandis qu’un autre l’ajoute. L’un peut conserver une barre oblique à la racine du domaine tandis qu’un autre la supprime. Pris isolément, chaque composant peut sembler raisonnable, alors que leur résultat combiné devient incohérent.
Les fonctions utilitaires de Toolso pour canonical, hreflang et sitemap partagent un même constructeur d’URL absolues. Celui-ci délègue la génération des chemins localisés à la même logique de routage et applique une règle unique de normalisation du chemin racine. Dans cette implémentation, l’URL de la page d’accueil par défaut est normalisée sans barre oblique finale. C’est notre convention de cohérence, et non l’affirmation que tous les sites doivent adopter cette écriture.
La fonction utilitaire de métadonnées prend aussi en charge une valeur de requête pour les URL paginées. Lorsque cette option est fournie, la même requête est ajoutée à l’URL canonical et aux variantes linguistiques. Les composants appelants peuvent ainsi associer la page deux à la page deux dans les autres langues, au lieu de la relier par inadvertance à la page un. Chaque appel doit néanmoins être examiné : les capacités d’une fonction utilitaire ne prouvent pas que toutes les routes l’utilisent correctement.
Les annotations canonical indiquent une URL préférée. Elles ne garantissent pas l’URL que Google sélectionnera. Cette distinction est expliquée dans les consignes de Google sur la canonicalisation.
La prise en charge de dix langues dans l’application ne signifie pas que chaque outil possède dix descriptions achevées. Assimiler ces deux faits produirait des annotations linguistiques qui promettent davantage que ce que le contenu offre réellement.
Notre fonction utilitaire de liens linguistiques accepte un ensemble de langues disponibles. Lorsque cet ensemble lui est fourni, elle ne génère de variantes que pour ces langues. Elle n’inclut une variante x-default pointant vers la version dans la langue par défaut que si cette version appartient à l’ensemble disponible. Sans cet ensemble, elle déclare toutes les langues configurées : il est donc essentiel de transmettre une disponibilité du contenu exacte au point d’appel.
La configuration de routage désactive la sortie automatique d’en-têtes HTTP Link pour les langues alternatives de next-intl. À la place, l’implémentation génère les annotations linguistiques avec les identifiants correspondants au moyen des métadonnées de page et des fonctions utilitaires du sitemap. Cela évite de maintenir, à côté de la correspondance linguistique explicite, un autre ensemble généré automatiquement à partir des clés de routage brutes.
Le résultat doit être vérifié après le déploiement. Dans notre échantillon Raphael, les pages en anglais et en chinois simplifié déclaraient chacune les dix mêmes variantes linguistiques ainsi que x-default, y compris un lien de retour vers l’autre page. Cela vérifie les annotations rendues pour cet échantillon, et non la qualité des traductions ou l’indexation dans les moteurs de recherche. La documentation de Google sur les pages localisées explique les codes de langue, les liens de retour et le rôle de repli de x-default.
Un générateur de sitemap peut facilement produire toutes les URL linguistiques possibles. Un inventaire plus utile reflète les contenus qui remplissent réellement les conditions pour y figurer.
La requête sur les données des outils dans le générateur de sitemap de Toolso sélectionne les outils publiés. Elle construit séparément l’ensemble des traductions disponibles à partir des enregistrements possédant un nom exploitable et un contenu descriptif valide. Ces enregistrements de traduction sont lus par lots avec pagination par curseur. Le générateur conserve les informations de langue nécessaires à l’assemblage des URL au lieu d’accumuler toutes les descriptions en mémoire.
Les entrées des fiches d’outils ne sont ensuite générées que pour les langues disponibles. De la même manière, les entrées des articles de blog sont filtrées selon l’ensemble de langues de chaque article. Les deux utilisent les fonctions utilitaires partagées pour les URL du sitemap et les variantes linguistiques. La seule présence d’un emplacement linguistique dans la base de données ne suffit donc pas à créer une entrée de page détaillée.
Les dates de modification demandent également de l’attention. Les entrées des fiches d’outils utilisent le champ seoUpdatedAt, lié au contenu, et les entrées du blog utilisent la date correspondante de mise à jour du contenu ou de publication. L’objectif est de décrire les changements significatifs du contenu plutôt que de faire passer chaque mise à jour du nombre de vues pour une nouvelle révision éditoriale.
Cela ne prouve pas que chaque entrée générée fonctionne actuellement correctement en production. L’envoi d’un sitemap n’est lui-même qu’une indication : les consignes de Google sur les sitemaps ne promettent ni exploration ni indexation.
Les traductions manquantes nécessitent une règle. Sans elle, une même description dans la langue d’origine peut apparaître sous de nombreuses URL linguistiques alors que le site les présente comme des traductions achevées.
Les métadonnées des fiches d’outils comportent une branche explicite de repli de traduction. Lorsqu’elle sert du contenu de repli, elle marque la page noindex, pointe l’URL canonical vers la version anglaise de l’outil et désactive le groupe de variantes linguistiques pour cette réponse. Les données de traduction temporairement indisponibles ou manquantes sont traitées séparément ; elles ne doivent pas être présentées comme une page traduite avec succès.
L’implémentation des articles de blog applique une règle proche : le repli pointe vers la langue d’origine de l’article, désactive les variantes linguistiques et utilise noindex. Le contenu de blog archivé est également marqué noindex. Il s’agit de décisions éditoriales et techniques propres au projet, et non d’une recommandation d’appliquer une règle identique à tous les sites multilingues.
La distinction pratique se situe entre une interface traduite et un contenu traduit. Un visiteur peut encore avoir besoin d’accéder à une version de repli, mais les métadonnées destinées aux moteurs de recherche ne doivent pas la présenter comme une édition linguistique indépendante et achevée. Le filtre de disponibilité du contenu dans le sitemap doit rester cohérent avec le comportement des pages détaillées.
Lire une fonction utilitaire est utile, mais c’est la réponse finale que reçoivent les visiteurs et les robots d’exploration. Les middlewares, le cache, la disponibilité des données et la version déployée peuvent modifier le résultat. Une revue de code ne peut donc pas remplacer la vérification d’une réponse.
Le dépôt contient un script d’audit du sitemap capable de vérifier le statut des réponses, les directives robots, les URL canonical et, en option, les relations entre langues. Nous avons examiné le script et inspecté les métadonnées rendues des deux pages Raphael ainsi que leurs entrées dans le sitemap. Ces entrées utilisaient les mêmes URL canonical et les mêmes variantes linguistiques que les pages de l’échantillon. Nous n’avons ni exécuté l’audit complet en production ni consulté Search Console.
Les trois captures d’écran montrent la page d’accueil, la fiche de Raphael AI et l’écran d’entrée du processus de soumission. Elles documentent l’interface au moment de la capture. Pour reproduire la vérification technique, comparez l’URL canonical et les liens linguistiques rendus d’une fiche dans deux langues disponibles, puis comparez ces URL à celles du sitemap. Consignez l’URL et la date. Testez séparément le comportement en cas de traduction manquante : une traduction achevée et un contenu de repli nécessitent des assertions différentes.
Les observations de Search Console doivent être consignées séparément : ce que Google a exploré, l’URL canonical qu’il a choisie et ce qui est indexé. Les données d’analyse et de conversion appartiennent à un autre relevé. Conserver ces relevés séparément évite de présenter une vérification locale de l’implémentation comme un résultat en matière de recherche ou de revenus.
L’idée la plus réutilisable consiste à laisser la disponibilité du contenu déterminer les déclarations d’URL. Distinguez les clés de routage des codes de langue, partagez la construction des URL entre les métadonnées et la génération du sitemap, et attribuez un état explicite aux traductions manquantes. Comparez ensuite ces intentions aux réponses réelles avant d’affirmer quoi que ce soit sur les performances dans les moteurs de recherche.
Pour une petite équipe, c’est aussi une discipline opérationnelle. Chaque nouvelle langue doit entrer dans le processus éditorial avec un état de contenu connu et une étape de vérification. Un petit échantillon peut révéler des incohérences, mais il ne permet pas d’établir la couverture de l’ensemble de l’annuaire. Vérifiez de nouveau le groupe d’URL lorsque les règles de routage ou la disponibilité des traductions changent.
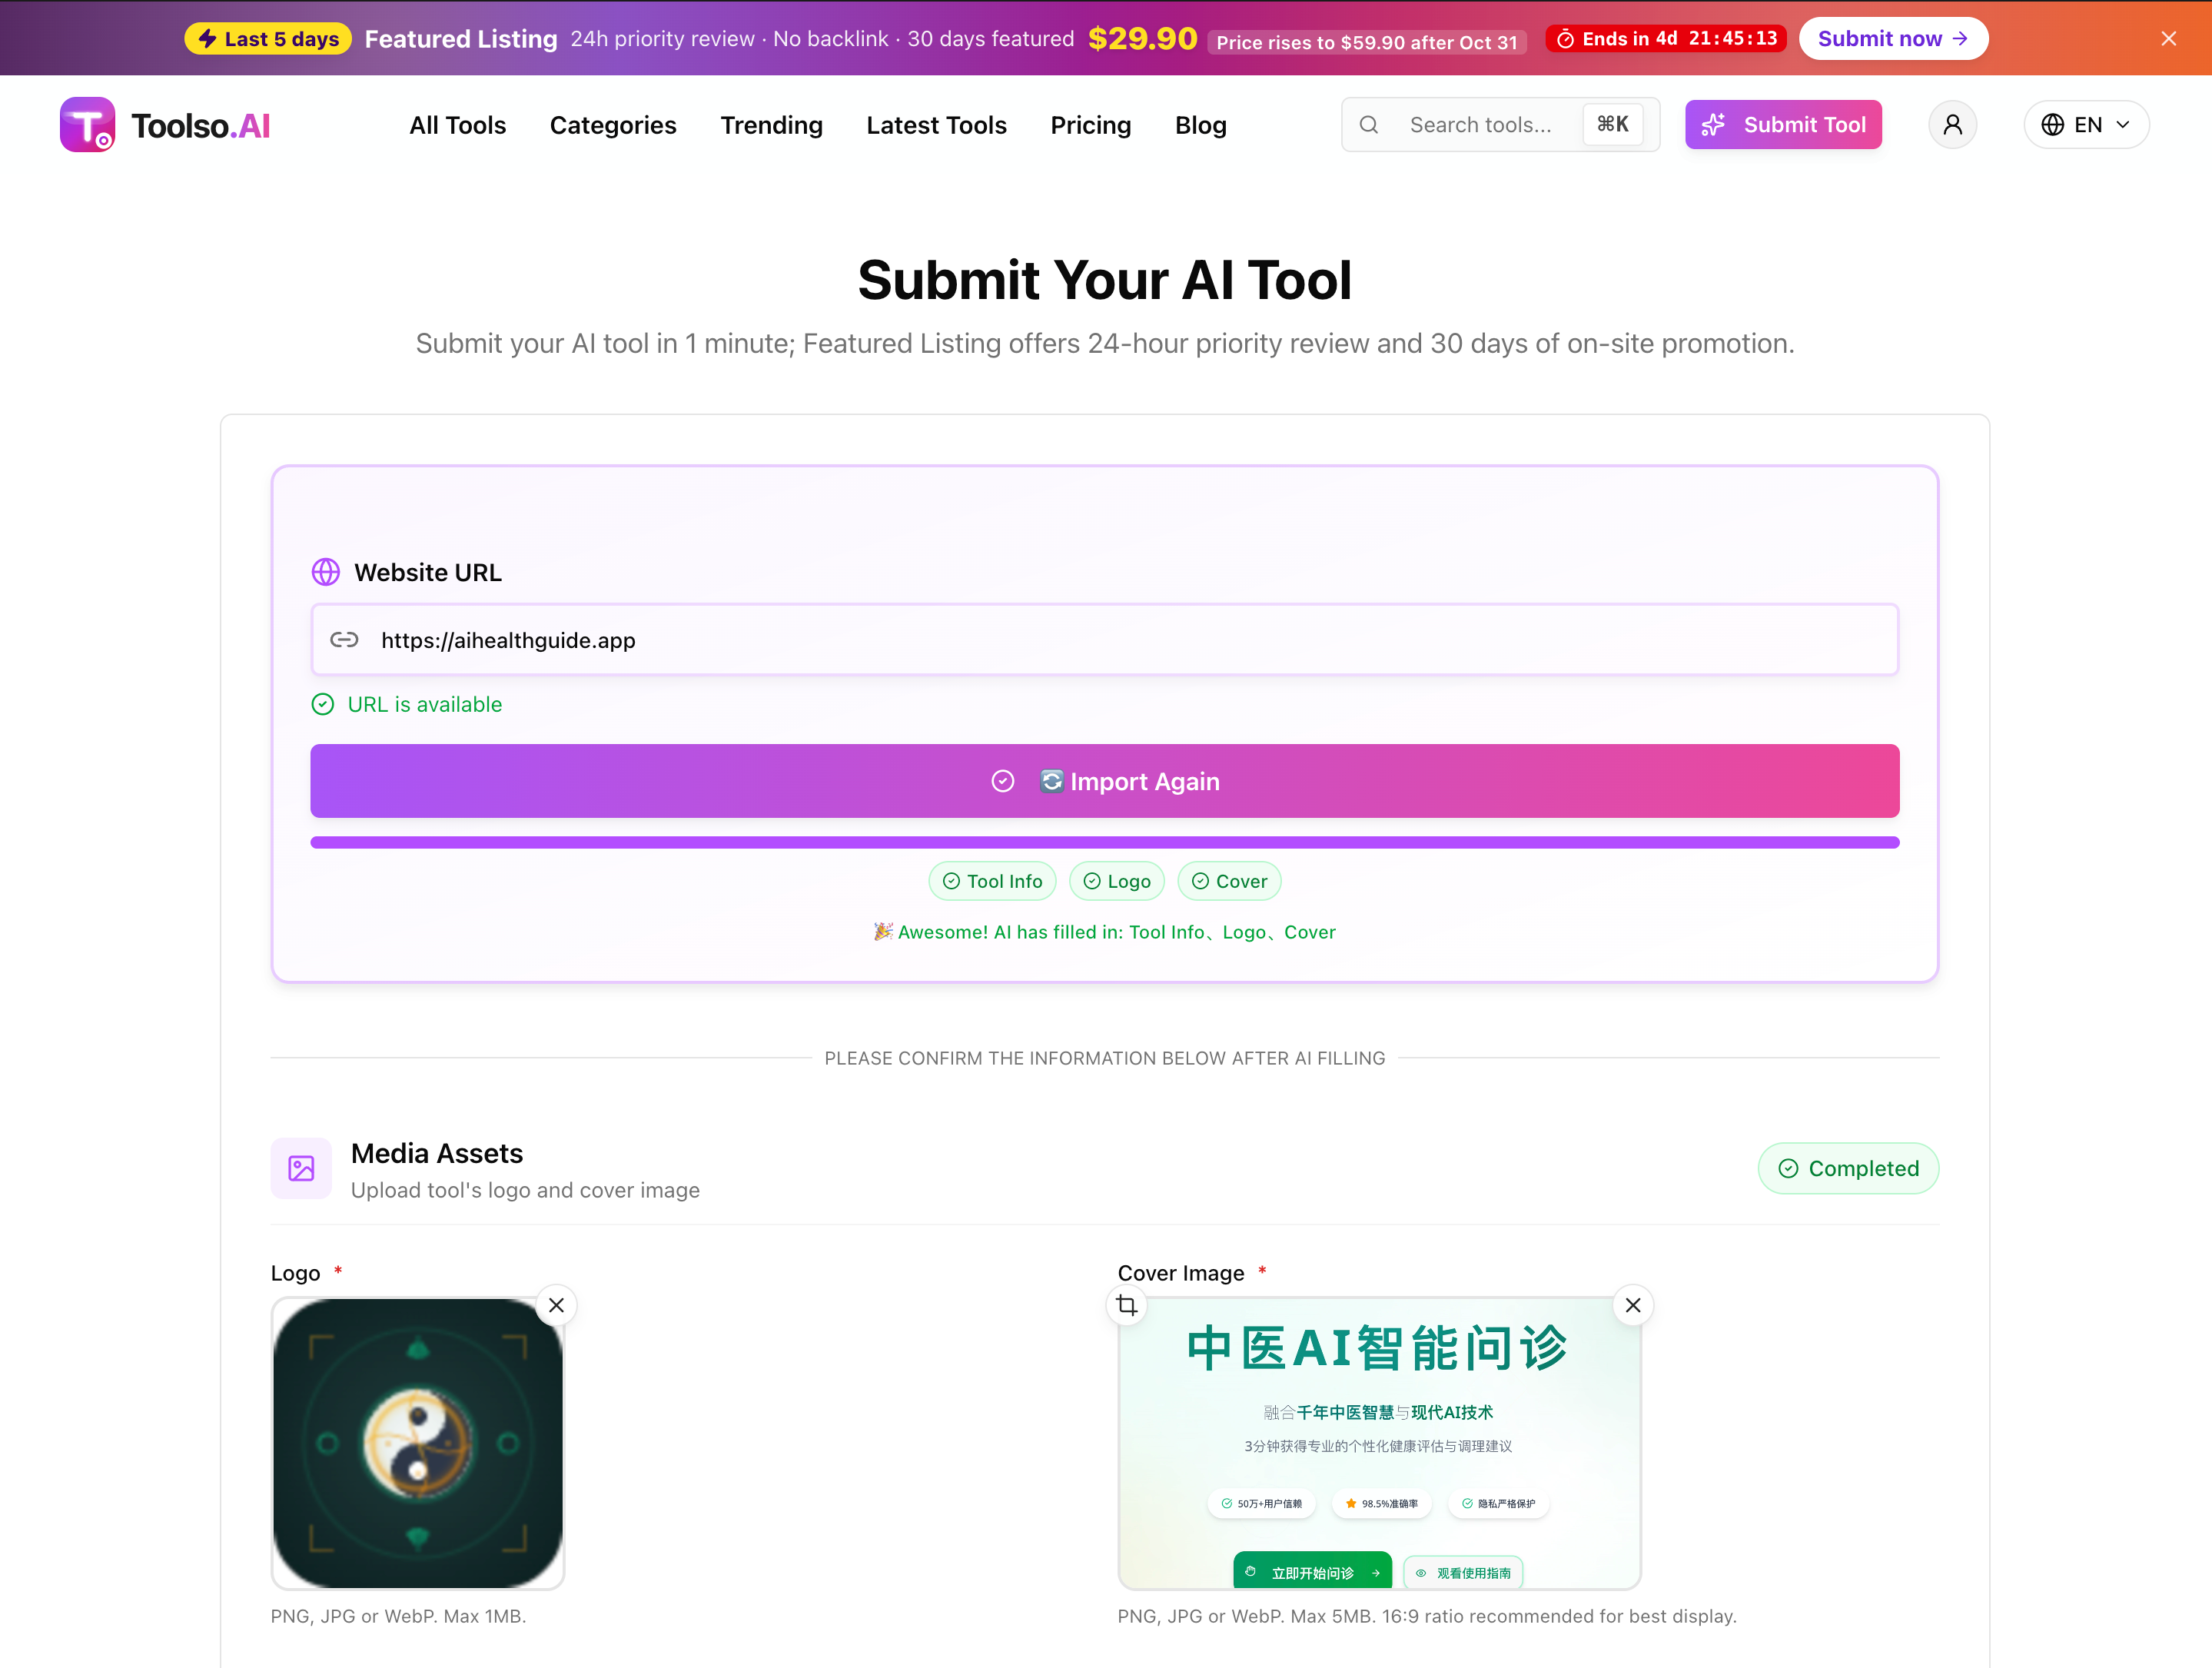
Figure 3. Le parcours de soumission après l’importation de l’URL d’un outil, avec les médias renseignés. Capture fournie le 26 octobre 2026 ; elle ne montre pas une soumission finale effectuée. Les prix et compteurs sont des éléments d’interface datés.
Si vous créez un annuaire multilingue, vous pouvez explorer Toolso en gardant ces questions à l’esprit : chaque page linguistique contient-elle un contenu utile, et ses signaux d’URL décrivent-ils ce contenu avec exactitude ?
Produire de la vidéo IA en 2026 : choisir le modèle par plan, prompter le mouvement, keyframes, coûts réels, correction des artefacts, migration Sora.

Trois plateformes, trois formes : Zapier le plus simple, Make le meilleur rapport prix, n8n le seul auto-hébergeable. Le coût dépend de la facturation.
Le prompt engineering en 2026 : pourquoi les prompts plus courts gagnent 10–15 %, ce que les modes de raisonnement ont rendu obsolète et cinq motifs.
La méthode 2026 pour coder avec Claude : CLAUDE.md légère, plan d'abord, sous-agents, worktrees parallèles, hooks garde-fous et boucles de vérification.
Copilot en 2026 : configurer Agent Mode, régler les auto-approbations, la revue agentique, la discipline de coût et les habitudes qui paient.
Le guide Midjourney à jour : structure des prompts, paramètres essentiels, entraînement de personnalisation, piège des 4× GPU, mode vidéo et boucle utile.
Le tutoriel V7 complet — paramètres, structures de prompt et workflows de la génération 2025, avec une table de migration complète vers V8.2.
Guide pratique de Notion AI : configurer des Custom Agents planifiés, écrire des Skills, gérer les crédits et l'hygiène d'espace de travail.
