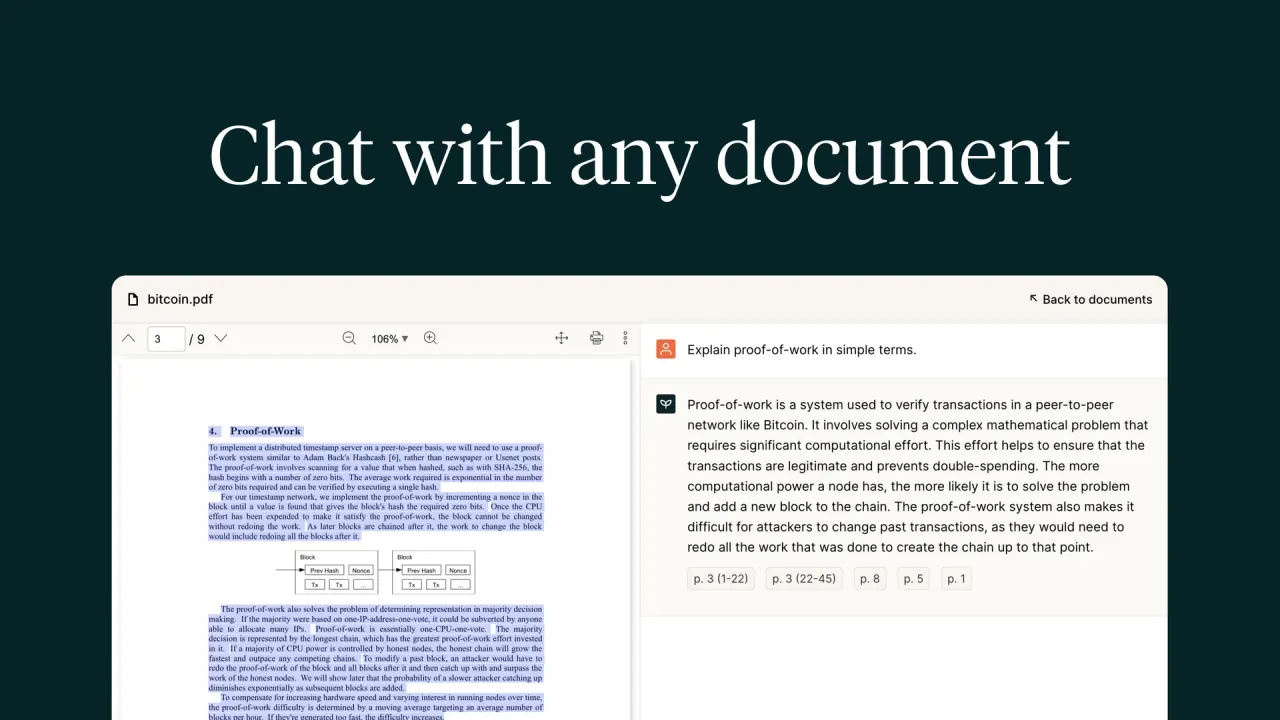
Задавайте вопросы по нескольким PDF, получайте краткие изложения или преобразуйте документы в структурированные данные. Отдельный API для разработчиков предлагает разбор, извлечение по схеме, поиск разделов и вопросы к документам.
Пользовались этим инструментом? Оцените его
Пользовались этим инструментом? Оцените его
PDF.ai — сервис для общения с документами и платформа для разработчиков: здесь можно задавать вопросы, получать краткие изложения и находить информацию в PDF. Веб-версия предлагает чат с PDF, а PDF API — разбор, структурированное извлечение, определение разделов и вопросы к обработанным файлам. У двух путей доступа отдельные тарифы и единицы учёта использования.
Предложение для разработчиков ориентировано на преобразование PDF в структурированные данные, извлечение заданных полей и интеллектуальное определение разделов. Поэтому продукт может быть полезен как читателю документа, так и разработчику, переносящему его содержимое в другое приложение.
Конечная точка v2 Parse преобразует PDF в Markdown или JSON, поддерживает OCR, форматирование таблиц и извлечение изображений.
Описаны два режима качества разбора. Standard выбран по умолчанию и позволяет выбирать язык OCR; значение по умолчанию для параметра списка языков — английский. Advanced использует визуально-языковые модели и, согласно описанию, потенциально повышает точность на сложных документах без выбора языка. Слово «потенциально» существенно: речь о варианте обработки, а не об измеренной гарантии точности для любой вёрстки или скана.
Извлечение данных из документов использует переданную схему JSON для определения возвращаемых полей. Конечная точка v2 Extract возвращает структурированные данные с цитатами, связывающими отдельные поля с исходными фрагментами документа.
Конечная точка v2 Split находит разделы по переданным описаниям и возвращает содержащие их страницы с уровнями уверенности. Описания разделов передаются массивом JSON; каждому объекту нужно имя, а описание можно добавить по желанию.
Конечная точка v2 Ask принимает вопросы по одному или нескольким уже разобранным документам. Компания описывает включение полного контекста документа; запрос передаёт массив идентификаторов документов. Для этого пути необходим предварительный разбор: идентификаторы в массиве должны указывать на уже обработанные документы.
Веб-продукт также поддерживает межъязыковой диалог. PDF может быть на одном языке, вопрос — на другом; по словам поставщика, ответ следует языку вопроса. Это разговорная функция: она не определяет полный список языков OCR и не доказывает одинаковое качество распознавания для разных языков.
Запросы API аутентифицируются ключом, созданным на странице Developer. Ключ показывается только один раз при создании; потерянный ключ можно создать заново на той же странице. Запросы без ключа возвращают ошибку.
Документированный способ повторного использования опирается на идентификатор документа и настройки разбора:
Результаты Parse кешируются для следующих вызовов с идентификатором документа и теми же настройками; ответы из кеша не расходуют кредиты разбора. В документации сказано, что такое использование также может экономить кредиты разбора в Extract и Split.
Parse позиционируется для извлечения содержимого, создания баз знаний и процессов генерации с дополнением из поиска. В таком процессе результатом разбора может служить Markdown или структурированное содержимое документа.
Библиотека сохранённых промптов поддерживает повторные вопросы: избранные промпты сохраняются для последующего вызова. Поставщик также описывает редактирование сохранённых промптов кнопкой с карандашом и удаление неиспользуемых промптов.
Веб-функция общения со всеми документами ищет подходящие ответы в загруженных PDF и показывает PDF, который считает наиболее релевантным ключевым словам вопроса. Это позволяет опрашивать существующую коллекцию, сохраняя связь с выбранным исходным документом. Описан поиск по релевантности в загруженных файлах, а не равный вклад каждого документа в каждый ответ.
PDF.ai решает разные задачи в зависимости от желаемого результата: скачиваемый файл с возможностью поиска, диалог с документом или ответ для обработки кодом. Браузерный OCR и API явно разграничивают эти варианты:
Доступ к размещённому интерфейсу документов PDF.ai осуществляется через сайт, а интеграции разработчиков используют запросы HTTP API. Документация Parse содержит примеры для cURL, Python, Node.js и PHP.
У доступных путей разные точки входа:
Веб-цены, зафиксированные 29 октября 2026 года, показывали годовое списание для платных уровней. Pro отображался по $10 в месяц с годовой оплатой, Ultimate — по $20 за пользователя в месяц с годовой оплатой, Enterprise — по $30 за пользователя в месяц с годовой оплатой. Hobby был указан как бесплатный навсегда. Это зафиксированные ставки при годовой оплате; они не устанавливают сумму при выборе ежемесячного списания.
| Веб-тариф | Зафиксированная цена | Загрузки PDF в месяц | Вопросы в месяц | OCR на файл | Максимальный размер файла |
|---|---|---|---|---|---|
| Hobby | $0, бесплатно навсегда | 1 | 100 | 2 страницы | 10MB |
| Pro | $10/месяц, оплата за год | 100 | 1,000 | 10 страниц | 50MB |
| Ultimate | $20/пользователь/месяц, оплата за год | Без ограничений | Без ограничений | 50 страниц | 50MB |
| Enterprise | $30/пользователь/месяц, оплата за год | Без ограничений | Без ограничений | 100 страниц | 100MB |
Месячные лимиты загрузок и вопросов учитываются отдельно.
OCR имеет постраничный лимит на файл, а максимальный размер файла выражен в MB. Поставщик явно отделяет эти ограничения OCR продукта от таблицы кредитов API. Поэтому лимит страниц OCR нельзя трактовать как количество кредитов API; соответствие файла пределу размера само по себе не доказывает, что все его отсканированные страницы укладываются в OCR-лимит тарифа.
Документация кредитов v2 указывает бесплатный API-тариф с 200 кредитами в месяц без необходимости кредитной карты. Платные месячные уровни предоставляют следующие объёмы кредитов и отделены от веб-тарифов выше.
| Месячная цена API | Кредиты в месяц |
|---|---|
| $0 | 200 |
| $49 | 3,000 |
| $99 | 10,000 |
| $249 | 30,000 |
| $599 | 100,000 |
Parse стоит 1 кредит за страницу в стандартном режиме и 2 кредита за страницу в расширенном. При включении необязательной обработки изображений с LLM документированная доплата — 1 кредит за каждые пять изображений с округлением вверх. Результаты разбора в кеше с теми же настройками не расходуют кредиты разбора, поэтому у повторной обработки и первичного разбора разные составляющие стоимости.
Extract рассчитывает плату по размеру схемы: до пяти полей включительно — 2 кредита за страницу, свыше пяти — 4 кредита за страницу. При отсутствии кешированного результата добавляется применимая плата за разбор. Примеры конечной точки отделяют стоимость извлечения от первичного разбора, а не считают извлечение единой фиксированной платой за запрос.
Краткий обзор кредитов, напротив, называет две ставки Extract «Standard» и «Advanced»: 2 и 4 кредита за страницу. Справочник конечной точки различает их по числу полей. Эти опубликованные описания не совпадают; здесь обе формулировки сохранены раздельно и не объединены в придуманное единое правило.
Split стоит 2 кредита за страницу плюс применимая плата за разбор. По документации, передача идентификатора документа позволяет избежать кредитов разбора, а файл или URL вызывает разбор во время запроса. Повторное использование разобранного содержимого меняет эту часть стоимости; плата за Split остаётся частью операции.
Ask списывает 3 кредита, умноженные на общее число страниц всех опрашиваемых документов. Документированный пример объединяет документ на 10 страниц и документ на 5 страниц: итого 45 кредитов. Плата связана с полным числом страниц запроса, а не описана как три кредита за любой вопрос независимо от количества охваченных документов.
Опубликованная политика отмены исключает как частичный, так и полный возврат средств. Она разрешает отменить подписку в любое время через Stripe Portal и утверждает, что после отмены дальнейших списаний не будет. Поэтому отмена и право на возврат — разные вопросы: возможность прекратить подписку не обещает возвратить уже списанную сумму.
Две альтернативы решают близкие задачи общения с документами, но с разными акцентами. Приведённые различия взяты из описаний самих конкурентов и не являются независимым подтверждением точности какой-либо из служб.
Специализированная документация API Legacy v1 указывает максимум 100MB для загрузки PDF по URL, 4.5MB для прямой загрузки файлов и 500 запросов в минуту. Она не ограничивает число страниц, но описывает тайм-аут загрузки в 60 секунд для PDF с очень большим числом страниц. Тот же справочник отмечает старый API-тариф Ultimate как больше не поддерживаемый. Это положения Legacy v1, а не универсальные лимиты веб-приложения или текущих конечных точек v2.
У названных моделей тоже есть версионная граница. Справочник чата Legacy v1 перечисляет gpt-4o и gpt-4-turbo с платой соответственно 2 и 4 кредита за сообщение и параметром языка ответа. Описание тарификации по сообщениям относится к v1; оно не заменяет постраничную формулу v2 Ask и не определяет модель веб-уровня Basic или Advanced.
Политика конфиденциальности описывает добровольно предоставленные контакты, cookie и сведения об устройстве, а также разумные меры защиты персональных данных. Она утверждает, что персональные сведения не продаются и не передаются третьим лицам, кроме случаев, когда это требуется законом или необходимо для выполнения запросов. Исключения остаются частью утверждения; это не безусловное обещание, что третьи лица никогда не получают никаких сведений.
Проверенная политика конфиденциальности не указывает срок хранения загруженных документов и не сообщает, используются ли загруженные материалы для обучения моделей ИИ. Эта граница раскрытия важна для чувствительных файлов: общие формулировки о персональных данных сами по себе не описывают, сколько времени доступны PDF, извлечённый текст или содержимое беседы.
Отдельное руководство поставщика описывает режим приватного документа. По нему приватный PDF-файл не загружается в системы компании, просмотр документа становится недоступен, а чат остаётся возможным. Опцию нужно задать до начала загрузки. Это утверждение о режиме приватного файла; оно не доказывает полностью локальную архитектуру или отказ от обучения на всей информации, участвующей в разговоре.
Маркетинговый раздел для разработчиков утверждает, что файлы удаляются после обработки. Справочник удаления v2 отдельно описывает хранящийся PDF, запись документа и кеш результатов разбора, которые можно удалить навсегда. Эти описания не определяют срок автоматического хранения; маркетинговая фраза не заменяет конкретные правила хранения и удаления конечной точки.
Конечная точка v2 Delete применима только к документам, созданным через v2 Parse, Extract или Split. Она навсегда удаляет связанную запись документа, загруженный файл в хранилище и кеш результатов разбора; удаление необратимо и не требует кредитов API. Её область действия не доказывает такой же механизм удаления для всех прочих путей продукта или старых конечных точек.
Удаление веб-документов описано отдельно: откройте Documents на панели, выберите значок корзины рядом с файлом и ответьте во всплывающем окне, спрашивающем о безвозвратном удалении из аккаунта. Эта инструкция на уровне аккаунта описывает пользовательский контроль. Она не задаёт фиксированный срок хранения и не решает отдельный вопрос использования для обучения ИИ.
Нет. Hobby указывает одну загрузку PDF и 100 вопросов в месяц. Бесплатный API-тариф вместо этого предлагает 200 кредитов в месяц, расход которых зависит от конечной точки и числа страниц.
Да. Поставщик описывает загрузку PDF на одном языке и вопросы на другом, с ответами на языке вопроса. Выбор языка OCR — отдельная настройка разбора.
Опубликованная политика разрешает отмену через Stripe Portal, но исключает частичный и полный возврат. Прекращение будущих списаний и возврат уже списанной суммы регулируются разными положениями.
