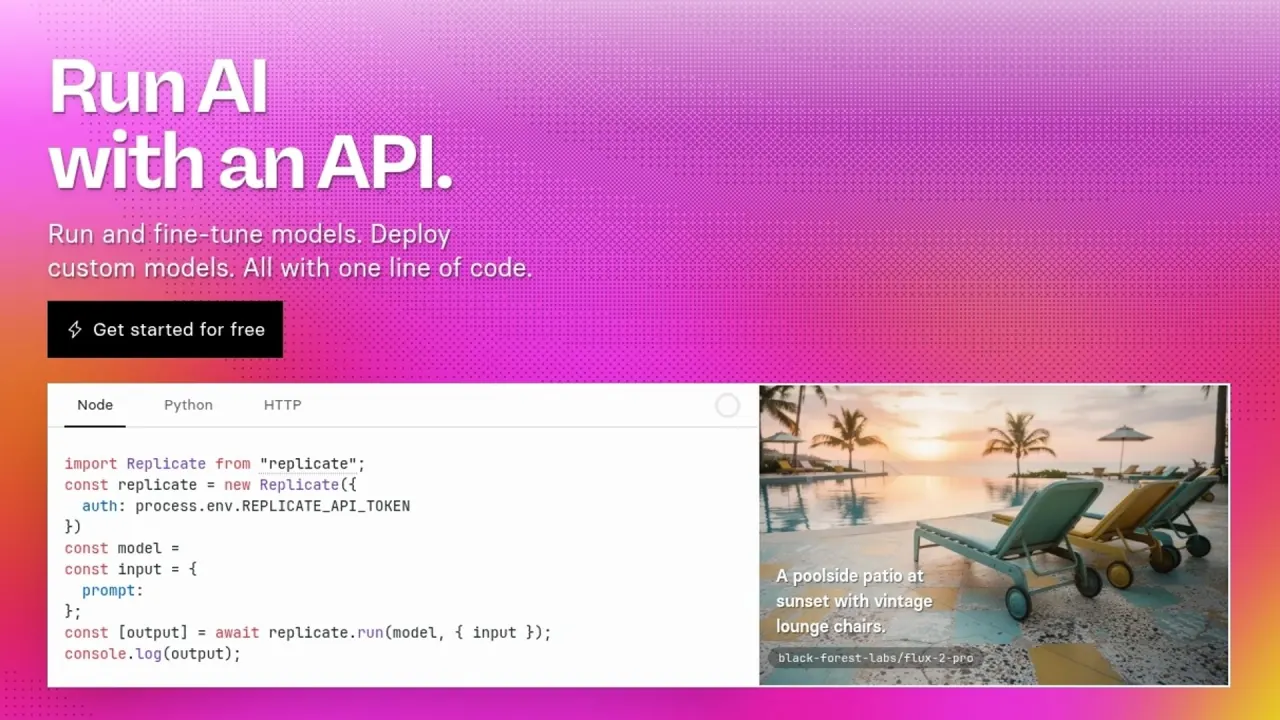
Replicate é uma plataforma em nuvem que executa, faz fine-tuning e hospeda modelos de IA atrás de uma única API HTTP. A maioria é cobrada por segundo de GPU, os modelos oficiais por saída gerada, e o crédito é comprado antecipadamente.
Replicate permite executar modelos de IA com uma API na nuvem, sem entender machine learning nem gerir infraestrutura própria. Um pedido HTTP envia uma entrada para um modelo de imagem, vídeo, áudio ou linguagem e devolve o resultado: nenhuma GPU para alugar, nenhum contentor para construir. No fundo, é uma API de modelos de IA.
Por trás dessa interface há três trabalhos: executar um modelo publicado por outra pessoa, afinar um com os seus próprios dados e implantar código que você mesmo empacotou. Cada um chega a uma linha de código.
O operador é Replicate, LLC., com morada em 101 Townsend Street, São Francisco. A 17 de novembro de 2025 a propriedade mudou: «a principal plataforma para executar modelos de IA» anunciou a entrada para a Cloudflare. A superfície do produto ficou expressamente de fora dessa mudança: o fornecedor afirma que a API não muda e que os modelos usados hoje continuarão a funcionar, e o comprador assumiu o mesmo compromisso, as API e os fluxos de trabalho dos utilizadores existentes continuarão a funcionar sem interrupção. O desenvolvimento também não parou: a entrada mais recente do registo de alterações acrescenta ficheiros de instruções Markdown que dão aos assistentes de código conhecimento especializado sobre o uso de modelos de IA nesta plataforma.
O tamanho do catálogo é um número do fornecedor: o anúncio da aquisição fala de mais de 50.000 modelos de código aberto e modelos afinados, e nenhuma contagem independente surgiu nos canais verificados nesta ronda.
Por trás de uma única API estão quatro objetos que se comportam de forma diferente em latência e em custo:
Por isso «um modelo na plataforma» não é um perfil de desempenho único: os modelos oficiais estão sempre quentes e prontos a responder, logo executam-se sem preocupação com arranques a frio, enquanto um modelo da comunidade pouco usado é primeiro carregado de raiz.
A capacidade move-se nos dois sentidos sem configuração: com muito tráfego a plataforma escala automaticamente, e desce a zero quando está inativa. Quando esse comportamento por omissão é demasiado solto, a funcionalidade de implantação (deployment) permite, entre outras coisas, controlar o hardware e os parâmetros de escalonamento de qualquer modelo. Para equipas, as organizações (organization) partilham o acesso a modelos, tokens de API, faturação e painéis.
O filtro de segurança por omissão cobre um âmbito mais estreito do que o nome sugere: nas previsões lançadas a partir da web, o verificador de segurança só é ativado no modelo base SDXL, no modelo base Flux e em todas as afinações derivadas de ambos. Há também uma saída: pode desativar o verificador de segurança ao executar o modelo através da API, o que deixa o caminho da API sem filtro garantido.
A primeira integração é curta, mas dois destes passos saem baratos agora e caros mais tarde.
As capacidades documentadas correspondem a um conjunto de tarefas estreito.
Os mesmos factos marcam o limite: tempo de resposta garantido, execução acima de trinta minutos ou saídas guardadas na plataforma para recolha posterior ficam fora do que está documentado para uma conta padrão.
Encaixa em equipas de software que querem inferência GPU sem servidor sem possuir a pilha de machine learning e que aguentam uma fatura variável em vez de operar clusters. Encaixa também em autores de modelos: publicar e afinar são aqui operações de primeira classe.
Quatro situações encaixam mal, e cada uma remete para uma cláusula publicada:
Tudo é alcançável por HTTP. Os clientes próprios cobrem Node.js, Python, Swift e Go, mais um cliente MCP alojado; outros ecossistemas como Elixir são mantidos por contribuidores e não pelo fornecedor, o que muda o apoio que pode esperar.
Existe também o caminho do navegador, a forma mais rápida de inspecionar as entradas de um modelo antes de escrever código.
Os preços do Replicate não têm escalões de plano. Só paga o que consome: alguns modelos são faturados por hardware e tempo, outros por entrada e saída. Qual o contador aplicável é uma propriedade do modelo, não da sua conta. No contador de tempo, a tarifa segue o hardware:
| Hardware | Por segundo | Por hora |
|---|---|---|
| Nvidia T4 | $0.000225 | $0.81 |
| Nvidia L40S | $0.000975 | $3.51 |
| Nvidia A100 (80 GB) | $0.001400 | $5.04 |
| Nvidia H100 | $0.001525 | $5.49 |
São preços por segundo de execução, não por pedido: a maioria dos modelos é faturada pelo tempo que demora a correr, e o preço por segundo varia consoante o hardware em uso, pelo que o mesmo prompt custa mais num modelo mais pesado. O contador de saída funciona ao contrário: os modelos oficiais são tarifados por métricas previsíveis como imagens geradas, segundos de vídeo de saída ou tokens de entrada e saída, com exemplos publicados de $0.04 por imagem gerada a $3.75 por milhão de tokens de entrada. Só desse lado se calcula antecipadamente um orçamento por pedido, e os escalões mais altos nem sequer são de autosserviço: capacidade adicional multi-GPU H100 está disponível com contratos de compromisso de gasto.
O arranque a frio é um problema de latência na capacidade partilhada e de faturação na dedicada. No lado partilhado, ao usar um modelo público só paga o tempo em que ele processa ativamente os seus pedidos; o tempo de arranque e o tempo inativo do modelo são gratuitos. A espera continua real: em certos casos o processo demora vários minutos. Também não depende inteiramente de si, porque por omissão partilha um conjunto de hardware com outros clientes e os seus pedidos entram numa fila comum.
Eliminar a espera muda o contador. Na capacidade dedicada paga todo o tempo em que as instâncias do modelo estão online: o tempo a arrancar, o tempo inativo à espera de pedidos e o tempo a processá-los ativamente. As afinações de arranque rápido são a exceção e só são cobradas pelo tempo de processamento ativo, sejam públicas ou privadas.
O acesso gratuito existe, mas é limitado e sem números. Pode executar gratuitamente uma seleção de modelos até lhe ser pedido que configure a faturação, sem montante, lista de modelos ou duração associados. As contas sem fundos são ainda limitadas: se lhe foi concedido crédito sem método de pagamento registado, fica limitado a 1 pedido por segundo e a um máximo de 6 pedidos por minuto.
O acesso pago é pré-pago e caduca. O crédito comprado é válido 1 ano a contar da data de compra e não é reembolsável fora do que a lei exigir; o contrato repete a regra de caducidade: cada pagamento que alimenta o saldo pré-pago caduca no fim do décimo segundo mês após a data de pagamento se não tiver sido totalmente consumido. O recarregamento automático tem mínimos — limite mínimo de $5 e saldo mínimo de recarga de $15 — e assim que o saldo chega a zero, novo trabalho é bloqueado e a infraestrutura em execução é desligada.
As condições empresariais são negociadas, não publicadas: gestor de conta dedicado, apoio prioritário, limites de GPU mais altos e SLA de desempenho, com descontos por volume ligados a um compromisso de gasto.
Dois factos fazem a maior parte da comparação. O primeiro é a amplitude: os utilizadores empresariais acedem a mais de 50.000 modelos com uma só API e um só contrato, o que não é a proposta de um serviço afinado para uma única modalidade. O segundo é que a configuração mais barata é a partilhada, e aí encontrará por vezes arranques a frio ou limites de escalonamento consoante a forma como os outros clientes usam esse modelo.
As fontes independentes nomeiam o terreno em vez de o ordenar. Um artigo técnico assinado, publicado quando a empresa se revelou em fevereiro de 2023, descrevia um mercado cheio: a startup concorre com fornecedores como Hugging Face e OctoML e, em certa medida, Runway ML, que em conjunto angariaram centenas de milhões de dólares. Uma discussão pública entre programadores produziu depois uma lista mais longa vinda da prática: quantos atores existem neste espaço? Replicate, RunPod, Modal, Northflank, FAL.
Três perguntas separam-nos na prática: o fornecedor publica uma tarifa de hardware por segundo ou apenas um preço por saída; cobra o tempo inativo depois de fixadas as instâncias; e guarda as suas saídas ou apaga-as com um temporizador. Nenhum teste comparativo independente atingiu o limiar de fonte nesta ronda: as páginas de comparação encontradas vinham de plataformas concorrentes ou de agregadores movidos por ligações de referência.
A documentação e o contrato dizem coisas diferentes sobre trabalho que falha. A documentação de faturação indica que uma execução falhada não é cobrada em nenhum modelo, ao passo que cancelar uma execução de um modelo oficial pode ainda assim ser faturado. Os termos dizem o contrário: execuções parciais e tentativas falhadas são faturáveis consoante o ponto exato de falha registado nos registos do fornecedor. Uma terceira regra cobre modelos encadeados: se o modelo falhar, é faturada a duração da execução mais o custo dos modelos a jusante chamados antes da falha. Estas páginas não são coerentes entre si, e são esses mesmos registos que servem para resolver litígios de faturação, pelo que uma carga com muitas falhas precisa da regra aplicável por escrito.
Num plano de autosserviço nada está fixado por contrato. O fornecedor reserva-se o direito, ao seu exclusivo critério, de introduzir alterações no serviço a qualquer momento, incluindo limitar ou descontinuar certas funcionalidades, de forma temporária ou permanente e sem aviso prévio. Sem compromisso de disponibilidade, um modelo de que o seu produto dependa pode desaparecer sem aviso: fixe versões e guarde uma alternativa. A resolução de litígios também está limitada: aplica-se a lei do Estado da Califórnia e não são permitidos processos de arbitragem coletiva.
Uma interface uniforme esconde licenças que não o são: não pode usar modelos de machine learning em violação das restrições de licença de código aberto do respetivo proprietário. Licenças permissivas, uso apenas para investigação e condições proprietárias convivem por trás da mesma chamada.
A retenção é assimétrica. As previsões feitas por API são apagadas por um temporizador de uma hora, enquanto os dados das previsões criadas na interface web são conservados indefinidamente, pelo que é o caminho do navegador que acumula histórico. A monitorização é explícita: o fornecedor reserva-se o direito de monitorizar o seu uso do serviço para verificar o cumprimento da política, incluindo análises automáticas e manuais de conteúdos e atividades. A política de privacidade avisa ainda que os dados de treino carregados podem conter qualquer tipo de informação, parte da qual poderá ser considerada «sensível» ao abrigo de várias leis de privacidade.
Os direitos sobre a saída são amplos mas condicionados. O fornecedor concede-lhe todos os direitos, títulos e interesses que existam sobre a saída, incluindo o uso comercial como a venda ou a publicação, sujeito aos termos de terceiros aplicáveis — essa condição é a licença do modelo que a produziu. Em troca, concede sobre as suas entradas uma licença limitada ao necessário para fornecer a saída, treinar e gerar modelos derivados do cliente, prestar o serviço nos termos do contrato e criar e compilar os Resultant Data. Sobre se essas entradas treinam os modelos próprios do fornecedor, as políticas publicadas não dizem que sim nem que não.
A plataforma declara que não «vende» nem «partilha» informação pessoal no sentido das leis de privacidade dos estados dos EUA, e a política indica que não recolhe intencionalmente informação pessoal de crianças com menos de 16 anos.
Existe uma dotação gratuita limitada, não um plano gratuito: alguns modelos correm de graça até lhe ser pedido que configure a faturação, e não são publicados nem quota, nem duração, nem lista de modelos. Enquanto não houver método de pagamento registado, o débito fica limitado a um pedido por segundo.
Nos modelos públicos não: aí o tempo de arranque e o tempo inativo são gratuitos. Muda assim que fixa capacidade: instâncias dedicadas e implantações cobram também arranque e inatividade.
Sim. O crédito é válido um ano a contar da data de compra e o contrato indica que cada pagamento caduca no fim do décimo segundo mês seguinte se não tiver sido totalmente consumido. Os saldos pré-pagos não são reembolsáveis, salvo quando a lei o exigir ou o acordo o previr expressamente.
Por omissão não na API: entradas, saídas, ficheiros e registos são removidos ao fim de uma hora, pelo que o que precisar tem de ser copiado para fora. Só as previsões criadas no navegador ficam até as apagar.
