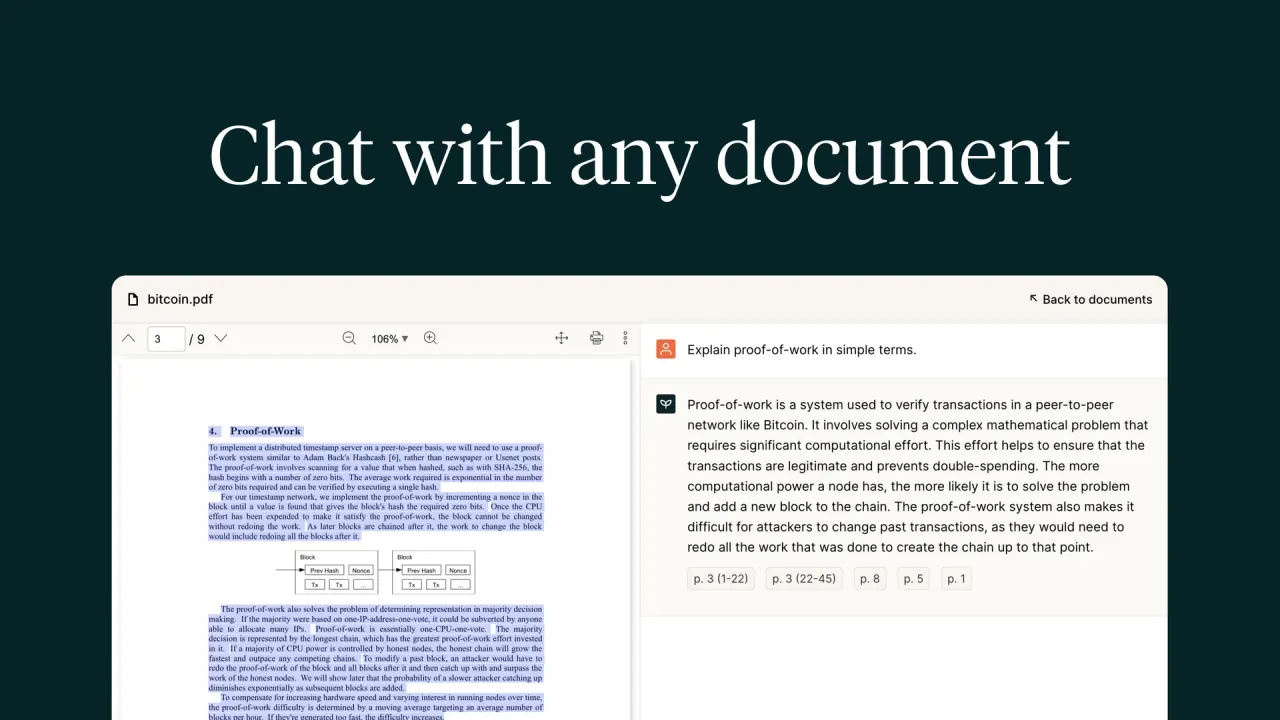
Faça perguntas sobre vários PDFs, obtenha resumos ou transforme documentos em dados estruturados. Uma API separada oferece análise, extração por esquema, detecção de seções e perguntas sobre documentos.
Já usou esta ferramenta? Avalie-a
Já usou esta ferramenta? Avalie-a
PDF.ai é um serviço de chat com PDF e uma plataforma para desenvolvedores que permite fazer perguntas, resumir documentos e extrair informações de arquivos PDF. A experiência web se concentra em conversas com documentos; sua API PDF oferece análise, extração estruturada, identificação de seções e perguntas sobre arquivos processados. As duas formas de acesso têm preços e medidas de uso separados.
A oferta para desenvolvedores é voltada à transformação de PDFs em dados estruturados, à extração de campos personalizados e à identificação inteligente de seções. Isso torna o produto relevante tanto para quem lê um documento quanto para o desenvolvedor que leva seu conteúdo a outro aplicativo.
O endpoint v2 Parse converte um PDF em Markdown ou JSON e oferece suporte a OCR, formatação de tabelas e extração de imagens.
São descritos dois modos de qualidade de análise. Standard é o padrão e permite selecionar o idioma do OCR; o parâmetro de lista de idiomas usa inglês por padrão. Advanced utiliza modelos de visão e linguagem e é descrito como uma opção que pode oferecer maior precisão em documentos complexos sem seleção de idioma. Esse «pode» importa: a documentação descreve uma opção de processamento, não uma garantia de precisão medida para qualquer layout ou digitalização.
A extração de documentos usa um esquema JSON fornecido para definir os campos a retornar. O endpoint v2 Extract retorna dados estruturados com citações que vinculam cada campo aos trechos de origem no documento.
O endpoint v2 Split identifica seções a partir das descrições fornecidas e retorna as páginas que as contêm, com níveis de confiança. A entrada de descrições é um array JSON; cada objeto exige um nome e também pode incluir uma descrição.
O endpoint v2 Ask aceita perguntas sobre um ou mais documentos já analisados. A empresa o descreve como incluindo o contexto completo dos documentos, e a solicitação fornece um array de identificadores de documentos. A análise é um pré-requisito dessa via: os identificadores no array devem apontar para documentos já processados.
A conversa entre idiomas também faz parte do produto web. Um PDF pode estar em um idioma e a pergunta em outro; segundo o fornecedor, a resposta segue o idioma da pergunta. É uma função de conversa: não define a lista completa de idiomas OCR nem demonstra qualidade de reconhecimento idêntica entre idiomas.
As solicitações à API são autenticadas com uma chave gerada na página Developer. A chave aparece apenas uma vez, na geração; se for perdida, pode ser gerada novamente na mesma página. Solicitações sem chave retornam um erro.
O padrão documentado de reutilização se baseia no identificador do documento e nas configurações de análise:
Os resultados de Parse são armazenados em cache para chamadas posteriores com um identificador de documento e as mesmas configurações; respostas em cache usam zero créditos de análise. A documentação também diz que essa reutilização pode economizar créditos de análise em Extract e Split.
O endpoint Parse é apresentado para extração de conteúdo, criação de bases de conhecimento e fluxos de geração aumentada por recuperação. Nesse fluxo, Markdown ou conteúdo documental estruturado podem servir como saída da análise.
Uma biblioteca de prompts salvos permite guardar perguntas favoritas para recuperá-las depois, apoiando consultas recorrentes. O fornecedor também documenta como editar prompts salvos com um controle em forma de lápis e remover os que não são mais usados.
A função web de conversa com todos os documentos busca respostas relevantes nos PDFs enviados e exibe o PDF que considera mais pertinente às palavras-chave da pergunta. Ela permite consultar uma coleção existente mantendo a ligação com o documento fonte selecionado. O comportamento descrito é a recuperação por relevância nos arquivos enviados, não a afirmação de que todo documento contribui igualmente para cada resposta.
PDF.ai atende a necessidades diferentes conforme o resultado desejado: um arquivo pesquisável para download, uma conversa documental ou uma resposta consumida por código. As vias de OCR no navegador e API explicitam essa distinção:
A interface documental hospedada do PDF.ai é acessada pelo site, e as integrações para desenvolvedores usam solicitações HTTP API. A documentação de Parse fornece exemplos em cURL, Python, Node.js e PHP.
As vias disponíveis têm pontos de entrada distintos:
Os preços web capturados em 29 de outubro de 2026 mostravam cobrança anual para os níveis pagos. Pro aparecia a $10 por mês, cobrado anualmente; Ultimate a $20 por usuário por mês, cobrado anualmente; Enterprise a $30 por usuário por mês, cobrado anualmente. Hobby aparecia como gratuito para sempre. São as tarifas capturadas com cobrança anual; elas não estabelecem o valor ao selecionar cobrança mensal.
| Plano web | Preço capturado | Envios de PDF por mês | Perguntas por mês | OCR por arquivo | Tamanho máximo do arquivo |
|---|---|---|---|---|---|
| Hobby | $0, gratuito para sempre | 1 | 100 | 2 páginas | 10MB |
| Pro | $10/mês, cobrado anualmente | 100 | 1,000 | 10 páginas | 50MB |
| Ultimate | $20/usuário/mês, cobrado anualmente | Ilimitados | Ilimitadas | 50 páginas | 50MB |
| Enterprise | $30/usuário/mês, cobrado anualmente | Ilimitados | Ilimitadas | 100 páginas | 100MB |
As cotas mensais de envios e de perguntas são contadores separados.
O OCR tem uma cota de páginas por arquivo, enquanto o tamanho máximo é expresso em MB. O fornecedor distingue explicitamente esses limites OCR do produto da tabela de créditos API. Portanto, o limite de páginas OCR não pode ser interpretado como uma cota de créditos API; um arquivo dentro do limite de tamanho não prova, por si só, que todas as suas páginas digitalizadas cabem na cota OCR do plano.
A documentação de créditos v2 lista um plano API gratuito com 200 créditos por mês, sem exigir cartão de crédito. Os níveis mensais pagos usam as cotas abaixo e são separados dos planos web acima.
| Preço mensal API | Créditos por mês |
|---|---|
| $0 | 200 |
| $49 | 3,000 |
| $99 | 10,000 |
| $249 | 30,000 |
| $599 | 100,000 |
Parse custa 1 crédito por página no modo padrão e 2 créditos por página no modo avançado. Quando o processamento opcional de imagens por LLM é ativado, o custo adicional documentado é de 1 crédito a cada cinco imagens, arredondado para cima. Resultados de análise em cache com as mesmas configurações usam zero créditos de análise; por isso, o processamento repetido e a primeira análise têm componentes de custo distintos.
Extract calcula os custos de extração pelo tamanho do esquema: até cinco campos custam 2 créditos por página, enquanto mais de cinco campos custam 4 créditos por página. As cobranças de análise aplicáveis são somadas quando não há resultado analisado em cache disponível. Os exemplos do endpoint separam o custo de extração da análise inicial, em vez de tratar a extração como uma tarifa única por solicitação.
Já o breve resumo de créditos rotula as duas tarifas de Extract como «Standard» e «Advanced», a 2 e 4 créditos por página. A referência do endpoint usa a quantidade de campos para essa distinção. Essas descrições publicadas não são idênticas; as duas formulações permanecem separadas aqui, sem serem combinadas em uma regra única inventada.
Split cobra 2 créditos por página além da análise aplicável. Sua documentação diz que passar um identificador de documento evita créditos de análise, enquanto fornecer um arquivo ou URL gera análise durante a chamada. Reutilizar o conteúdo analisado muda esse componente de análise; a cobrança de Split continua fazendo parte da operação.
Ask cobra 3 créditos multiplicados pelo total de páginas de todos os documentos consultados. O exemplo documentado combina um documento de 10 páginas com outro de 5 páginas, por 45 créditos. A cobrança está ligada à contagem integral de páginas da solicitação, não é descrita como três créditos por qualquer pergunta independentemente do número de documentos abrangidos.
A política de cancelamento publicada informa que não há reembolsos parciais ou integrais. Ela permite cancelar a assinatura a qualquer momento pelo Stripe Portal e diz que não haverá cobranças posteriores após o cancelamento. Assim, cancelamento e elegibilidade para reembolso são assuntos distintos: poder interromper uma assinatura não promete devolver uma cobrança já realizada.
Duas alternativas atendem a necessidades próximas de conversa documental, com ênfases diferentes. As distinções abaixo vêm das descrições dos próprios concorrentes e não constituem validação independente da precisão de nenhum dos serviços.
A documentação API dedicada de Legacy v1 lista o máximo de 100MB para enviar PDFs por URL e 4.5MB para envio direto de arquivos, além de 500 solicitações por minuto. Ela informa que não há limite de páginas, mas descreve um tempo limite de upload de 60 segundos para PDFs com muitas páginas. A mesma referência marca o antigo plano API Ultimate como não mais suportado. São afirmações de Legacy v1, não limites universais atribuídos ao aplicativo web ou aos endpoints v2 atuais.
Os modelos nomeados também têm uma fronteira de versão. A referência de chat Legacy v1 lista gpt-4o e gpt-4-turbo, com cobranças respectivas de 2 e 4 créditos por mensagem, e um parâmetro de idioma da resposta. Essa descrição por mensagem pertence à v1; não substitui a fórmula por páginas de v2 Ask nem identifica o modelo por trás de um nível web chamado Basic ou Advanced.
A política de privacidade descreve informações de contato fornecidas voluntariamente, cookies e dados de dispositivos, além de medidas razoáveis para proteger informações pessoais. Ela diz que informações pessoais não são vendidas nem compartilhadas com terceiros, exceto conforme exigido por lei ou necessário para atender solicitações. As exceções continuam fazendo parte dessa declaração; não é uma promessa incondicional de que nenhum terceiro jamais receba informações.
A política de privacidade examinada não informa o prazo de retenção de documentos enviados nem se o material enviado é usado para treinar modelos de IA. Esse limite de divulgação importa para arquivos sensíveis: o texto geral sobre dados pessoais não documenta, por si só, por quanto tempo um PDF, seu texto extraído ou o conteúdo de suas conversas permanecem disponíveis.
Um guia do fornecedor descreve separadamente uma opção de documento privado. Diz que o PDF privado não será enviado aos sistemas da empresa, que a visualização do documento ficará indisponível e que o chat continuará possível. A opção precisa ser definida antes do início do upload. É uma declaração sobre o modo de arquivo privado; não estabelece uma arquitetura inteiramente local nem um compromisso de não treinar com todas as informações envolvidas em uma conversa.
A seção de marketing para desenvolvedores afirma que os arquivos são excluídos após o processamento. A referência de exclusão v2 descreve separadamente um PDF armazenado, um registro documental e resultados de análise em cache que podem ser removidos permanentemente. Essas descrições deixam indefinido o cronograma de retenção automática; a frase de marketing não substitui o comportamento específico de armazenamento e exclusão do endpoint.
O endpoint v2 Delete se aplica apenas a documentos criados por v2 Parse, Extract ou Split. Ele remove permanentemente o registro documental associado, o arquivo enviado no armazenamento e os resultados de análise em cache; a exclusão é irreversível e não custa créditos API. Seu escopo não estabelece o mesmo mecanismo de exclusão para todas as outras vias do produto ou endpoints antigos.
A remoção de documentos na web tem um fluxo documentado separado: abrir Documents no painel, selecionar o ícone de lixeira ao lado de um arquivo e responder à janela que pergunta se ele deve ser removido permanentemente da conta. Essa instrução no nível da conta descreve um controle do usuário. Ela não fornece um prazo fixo de retenção nem resolve a questão separada do uso para treinamento de IA.
Não. Hobby lista um envio de PDF e 100 perguntas mensais. Já o plano API gratuito lista 200 créditos por mês, cujo uso depende do endpoint e da quantidade de páginas.
Sim. O fornecedor documenta o envio de um PDF em um idioma e perguntas em outro, com respostas no idioma da pergunta. A seleção do idioma OCR é uma configuração de análise separada.
A política publicada permite cancelar pelo Stripe Portal, mas informa que não há reembolsos parciais ou integrais. Interromper cobranças futuras e reembolsar uma cobrança existente são políticas diferentes.
