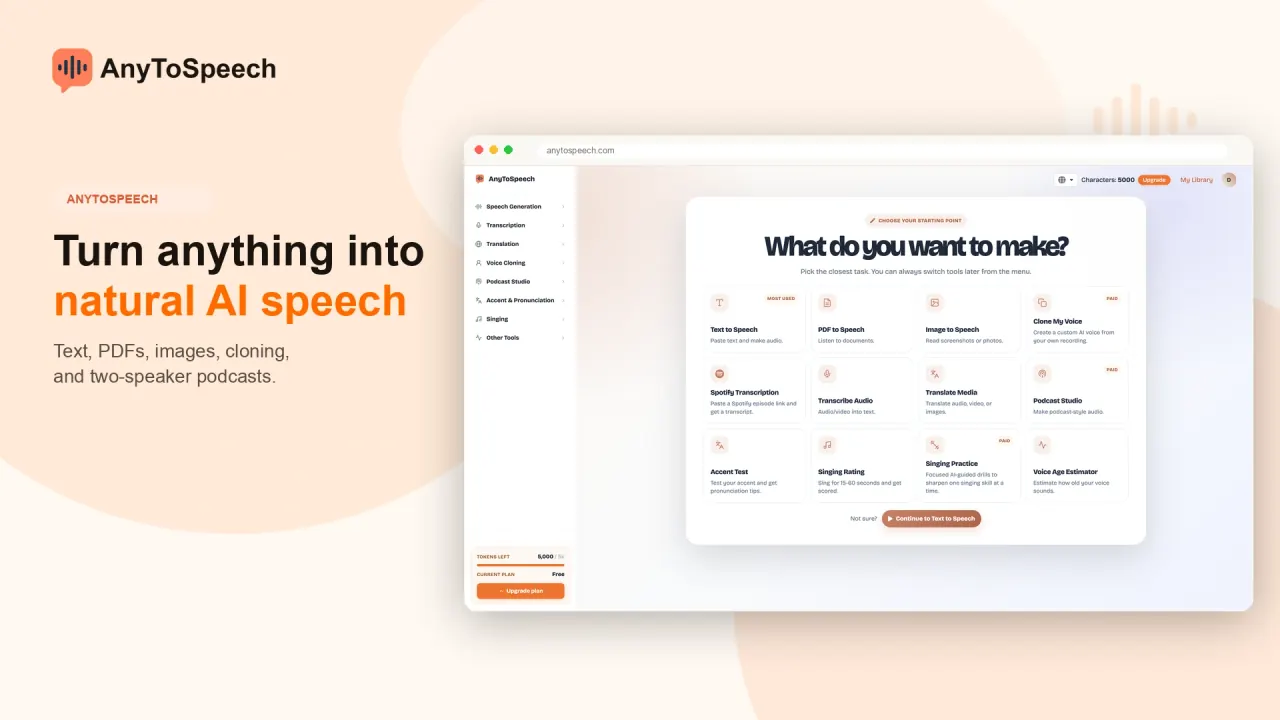
Converta textos e documentos em fala, transcreva gravações, crie diálogos e podcasts e analise seu sotaque ou canto. Navegador, celular e MCP compartilham a conta AnyToSpeech.
Já usou esta ferramenta? Avalie-a
Já usou esta ferramenta? Avalie-a
AnyToSpeech combina geração de fala, transcrição, tradução e análise de voz em um só serviço. Escuta de documentos, conversas com roteiro, vozes personalizadas e breves avaliações vocais complementam essas tarefas centrais.
A conversão de texto em fala transforma texto simples, documentos ou PDFs em áudio, com escolha de vozes e download em MP3. O serviço tem caminhos de criação separados para ler documentos, interpretar um roteiro escrito e compor uma conversa a partir de um tema.
O acesso varia conforme a função: prévia gratuita, cota mensal e geração paga são ofertas distintas.
As transcrições concluídas podem ser recuperadas em My Library sem manter a página de processamento aberta. A função também anuncia tradução e downloads nos formatos TXT ou DOCX.
A biblioteca inclui amostras e filtros por idioma, gênero, tom e sotaque. O filtro de gênero oferece opções feminina, masculina e neutra.
A clonagem de voz começa com três gravações guiadas, cada uma de 10–15 segundos. São aceitas gravações no navegador e o envio de arquivos WAV, MP3 ou M4A existentes. O clone resultante passa a ser uma voz reutilizável dentro do serviço.
O FAQ de clonagem lista 27 idiomas, incluindo inglês, francês, espanhol, alemão, português brasileiro, japonês, coreano, chinês e árabe. Esse número se refere à clonagem, e não a um total único de idiomas para todas as ferramentas. Voice Design lista separadamente inglês, francês, espanhol, alemão, português, italiano, japonês, coreano e chinês.
Voice Design aceita 13 atributos estruturados ou uma descrição livre de 30–250 caracteres. Os atributos abrangem dialeto, gênero, idade, emoção, tom, altura, volume, velocidade, clareza, fluência, personalidade, textura e ambiente. Nenhuma gravação é necessária nesse caminho baseado em descrição.
Cada solicitação de Voice Design produz três prévias de voz para comparação. O resultado salvo passa a ser uma opção de voz personalizada nas ferramentas AnyToSpeech compatíveis. A redação sobre acesso exige cuidado: Voice Design é chamado de recurso Pro, mas também é descrito como incluído junto com a clonagem nos planos pagos. Isso não o restringe claramente ao nível do site chamado Pro.
Multi-Speaker Text to Speech aceita de dois a seis falantes, pausas e indicações emocionais, misturando a conversa em um único MP3. O usuário escreve o diálogo e controla quem diz cada fala.
Podcast Studio gera um MP3 com dois falantes a partir de um tema, incluindo música de abertura e um título de episódio falado. Também aceita um roteiro preparado. A introdução faz parte do episódio gerado.
Episódios por tema têm durações faladas desejadas de 2, 5, 10 ou 20 minutos; roteiros colados podem ter até 12,000 caracteres. São durações-alvo e um limite separado para a entrada do roteiro.
English Accent Test analisa um trecho lido para estimar o idioma nativo, dar uma pontuação de proximidade com um falante nativo e examinar características de vogais, consoantes e entonação. Essas são categorias de análise declaradas pela empresa, não uma certificação independente de fluência.
A análise de canto informa altura, ritmo, timbre, extensão, expressão, controle da respiração e clareza da letra, junto com um rótulo de tipo de voz. Ela avalia a apresentação vocal enviada.
O editor com vários falantes permite controlar cada fala, os falantes e as pausas.
Antes de gravar um podcast com IA, é possível revisar e reescrever o roteiro, redistribuir falas entre os participantes e adicionar notas de interpretação. A página diz que a cobrança ocorre ao pressionar Record.
A linha do tempo do podcast permite arrastar e cortar clipes, regravar uma fala, alterar o volume de cada falante e desfazer mudanças. Frases individuais podem ser revistas sem substituir o episódio inteiro.
Salvar atualiza o episódio na biblioteca e a versão reproduzida pelo link de compartilhamento. O download entrega a edição mais recente, com a arte da capa dentro do MP3.
A distinção útil é se a saída pretendida preserva falas escritas, explica o material de origem em uma discussão gerada ou lê um documento em voz alta.
As prévias gratuitas, os requisitos de geração paga e as condições abaixo para usar as saídas e o site são limites importantes para a produção.
AnyToSpeech tem aplicativos para iPhone e Android. Os pontos de acesso em várias plataformas não comprovam catálogos ou limites idênticos em todas as interfaces.
A configuração MCP usa o login da conta para ChatGPT, Claude, Cursor ou VS Code; Perplexity e Meta Muse usam uma chave de integração.
O uso de MCP consome os créditos, minutos de transcrição e limites de plano já existentes na conta. A criação via assistente tem o mesmo orçamento de uso do acesso pelo site.
O site tem os níveis Free, Hobby, Standard e Pro. A tabela lista os preços Monthly exibidos e os benefícios registrados em 29 de outubro de 2026. O sinal $ é o símbolo exibido; não há código de moeda ISO especificado.
| Nível do site | Preço mensal exibido | Caracteres de fala por mês | Minutos de transcrição por mês | Cota de clones de voz |
|---|---|---|---|---|
| Free | $0 | 5,000 | 50 | Não incluído |
| Hobby | $7 | 50,000 | 200 | 1 |
| Standard | $14 | 100,000 | 1,000 | 3 |
| Pro | $69 | 1,000,000 | 5,000 | 10 |
A página de preços descreve as conversões de fala Free como de aproximadamente 30 segundos cada e exclui vozes premium desse nível. O cartão Free da página inicial mostra, em vez disso, cerca de 15 segundos de áudio. A interface separada de transcrição informa uma cota Free de 50 minutos por mês. Caracteres de fala e minutos de transcrição são medidores mensais separados.
A fala com vários participantes usa um crédito por caractere, e contas novas incluem créditos gratuitos. O uso de caracteres e os minutos de transcrição são medidos separadamente.
A interface de preços oferece Monthly e Yearly com a indicação “Save 40%+”. Seu FAQ de cobrança, porém, ainda descreve todos os planos como assinaturas mensais, diz que as cotas de caracteres são renovadas a cada mês e que caracteres não usados passam para o mês seguinte. O seletor anual e o FAQ apenas mensal coexistem; não fornecem uma explicação totalmente consistente dos intervalos de cobrança.
As assinaturas podem ser canceladas, pausadas, ampliadas ou reduzidas a qualquer momento. Reembolsos são permitidos em até sete dias após a compra somente se o produto não tiver sido usado, por solicitação via e-mail. A condição de não uso faz parte da política; a janela não é um teste incondicional de sete dias depois do uso em produção.
Luvvoice oferece conversão de texto em fala com escuta no navegador e downloads MP3. É uma comparação pertinente para trabalhos de conversão direta de texto em áudio.
Luvvoice também aceita documentos PDF e TXT para convertê-los em fala. Há sobreposição com a escuta de documentos e a conversão de roteiros colados, sem comprovar a mesma qualidade de voz, condições ou limites de produção.
Narakeet oferece conversão de documentos em áudio e fluxos de PowerPoint ou Markdown para vídeo. Seu caminho de vídeo de slides merece consideração separada quando a entrega inclui uma apresentação visual, e não apenas narração ou um arquivo de conversa em áudio.
Narakeet também converte legendas SRT ou WebVTT em áudio sincronizado com suas marcações de tempo. Isso é relevante quando as marcações existentes definem a saída.
A geração no Podcast Studio exige plano pago; contas Free podem ouvir prévias das vozes na página. Assim, uma entrada visível para “experimentar” não significa que uma conta gratuita possa produzir um episódio concluído.
O avaliador de canto espera uma apresentação de 15–60 segundos, e cantarolar sem palavras recebe uma pontuação menor de clareza da letra. Essa regra importa ao interpretar o resultado geral: um exercício vocal sem palavras não é avaliado exatamente como uma apresentação com letra compreensível.
Os termos do site excluem menores de idade e pessoas abaixo de 18 anos. Essa restrição se aplica mesmo que usos educacionais e escuta por estudantes façam parte do posicionamento do produto; esses públicos não significam que todos os usuários em idade escolar estejam aptos a usar o serviço.
O site descreve as vozes de pessoas identificadas como recriações por IA para entretenimento, sem afiliação, verificação ou endosso por essas pessoas. Há um gerador no estilo de Donald Trump. A saída efetivamente gerada e a permissão das pessoas identificadas não foram verificadas de forma independente.
Visitantes e contas gratuitas no gerador de vozes de pessoas identificadas têm limite de cinco gerações por mês civil, com até 500 caracteres cada. É uma cota específica da ferramenta e não deve ser lida como a cota geral de caracteres de fala do plano.
A página de marketing da clonagem usa o chamado “Start Cloning -- It's Free”. Em contraste, a comparação de preços exclui clonagem de Free e lista cotas de clones nos níveis pagos. A redação pública cria impressões diferentes sobre a inclusão da criação de um clone no acesso gratuito.
O cartão Free da página inicial risca o uso comercial de todas as saídas. A página de preços dedicada também lista uso comercial entre as funções não incluídas em Free.
O FAQ de texto em fala permite publicações sociais monetizadas, anúncios pagos, sistemas IVR e mensagens de voz de pequenas empresas, com uma ressalva separada para uso comercial em grande volume. Os termos do site restringem separadamente o uso do próprio site para publicidade ou marketing.
A política de privacidade informa a coleta de e-mail e os dados de cobrança mantidos pela Lemon Squeezy, aos quais diz que AnyToSpeech não tem acesso direto. Também descreve registros com endereço IP, tipo de navegador, provedor de internet, marcações de tempo, páginas de referência ou saída e, possivelmente, contagens de cliques. Essas informações gerais sobre visitantes e cobrança são distintas das promessas sobre ferramentas de áudio específicas.
O FAQ de clonagem diz que os dados de voz são criptografados em trânsito e em repouso, que os clones são privados da conta e que os dados de voz não são compartilhados com terceiros nem usados para treinar modelos. É uma declaração da empresa sobre os dados de voz da clonagem, não uma garantia de não treinamento para todos os documentos, imagens, transcrições ou episódios gerados na plataforma.
English Accent Test afirma que o áudio é excluído imediatamente após a análise e que as gravações de voz não são armazenadas. A ferramenta de canto diz separadamente que os clipes são processados em tempo real e descartados, sem cadastro nem compartilhamento. Essas descrições de exclusão valem para os fluxos de avaliação, e não para episódios de podcast salvos, clones de voz da conta ou a Library geral.
Exibir conteúdo concede à AnyToSpeech uma licença não exclusiva, mundial, irrevogável e sublicenciável para usá-lo, reproduzi-lo, adaptá-lo, publicá-lo, traduzi-lo e distribuí-lo em qualquer mídia. Os termos definem esse conteúdo de forma ampla: áudio, vídeo, texto, imagens e outros materiais que o usuário escolhe exibir no site. Essa licença é uma condição importante de direitos sobre conteúdo, junto às declarações sobre saídas e privacidade.
Os usuários devem ser donos do conteúdo exibido e evitar violar direitos de terceiros; AnyToSpeech reserva o direito de removê-lo sem aviso. A capacidade de estúdio de voz MCP inclui excluir vozes personalizadas que pertencem ao usuário. Essa capacidade não informa, por si só, um período de retenção nem um prazo para remover todos os arquivos relacionados, enviados ou gerados.
Não. Podcast Studio permite que usuários Free ouçam prévias das vozes, mas gerar um episódio exige plano pago. Essa regra de acesso difere dos créditos gratuitos descritos para um diálogo com vários falantes escrito manualmente.
O produto combina a conversão de PDF em áudio com uma voz clonada reutilizável e apresenta explicitamente essa combinação para autores. A clonagem de voz usa amostras gravadas; Voice Design cria uma voz a partir de uma descrição escrita.
Não. MCP usa os mesmos créditos de conta, minutos de transcrição e limites de plano do site. Conectar um assistente muda a entrada para as ferramentas, sem acrescentar uma assinatura separada de geração.
