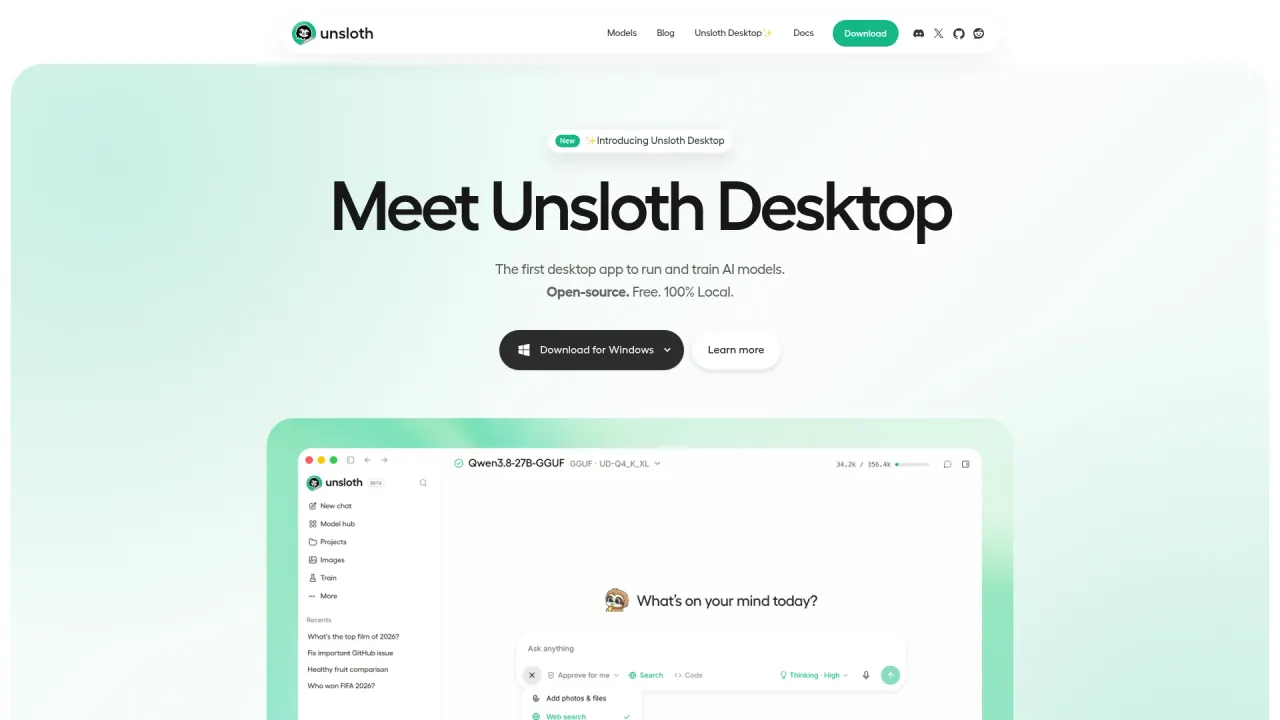
Unsloth는 자신의 하드웨어에서 LLM, 확산, 오디오, 임베딩 모델을 파인튜닝하고 실행하는 오픈소스 프레임워크이자 데스크톱 앱, 웹 UI입니다. 노코드 학습, LoRA, QLoRA, RL 방법, 데이터셋 구축, GGUF 내보내기를 다룹니다.
이 도구를 사용해 보셨나요? 평점을 남겨 주세요
Unsloth는 LLM을 실행하고 학습하기 위한 오픈소스 프레임워크로, 오픈소스 UI를 통해 자신의 로컬 하드웨어에서 AI 모델을 실행하고 학습할 수 있게 해 줍니다. 텍스트, 비전, 확산 이미지와 동영상, 오디오, 임베딩 모델을 다루며 로컬 추론과 LLM 파인튜닝을 모두 지원합니다.
Unsloth는 세 가지 방식으로 설치할 수 있습니다. 네이티브 앱인 Unsloth Desktop, 브라우저 기반 웹 UI인 Unsloth Studio, 그리고 원래의 코드 기반 Python 패키지인 Unsloth Core입니다. Desktop과 Studio는 노코드 인터페이스이고, Core는 개발자가 자신의 학습 스크립트와 노트북에서 호출하는 라이브러리입니다.
Unsloth Desktop은 Beta로 표시되어 있으며, 자신의 하드웨어에서 AI 모델을 실행하고 학습하는 무료 오픈소스 앱으로 설명되고 macOS, Windows, Linux용으로 제공됩니다. Unsloth Studio 역시 Beta이며, 하나의 로컬 인터페이스에서 오픈 모델을 학습·실행·내보내기 하는 오픈소스 노코드 웹 UI로 자리매김합니다. 홈페이지는 Unsloth Desktop을 오픈소스, 무료, 100% 로컬이라는 세 단어로 소개합니다. 2024년의 한 비즈니스 매체 인물 기사는 회사 공동 창업자가 Michael과 Daniel Han 형제이며, 당시 Y Combinator에 참여하고 있었다고 보도했습니다.
Unsloth의 대표 주장은 LLM, 확산, TTS, 임베딩 모델을 정확도 손실 없이 2× 빠르게, VRAM은 70% 적게 써서 학습한다는 것입니다. 이는 업체 자체 수치이며, 그 뒤의 테스트 조건은 아래에 정리했습니다.
공개된 학습 벤치마크는 H100과 Blackwell GPU에서 Alpaca 데이터셋, 배치 크기 2, 그래디언트 누적 단계 4, rank 32, 모든 선형 레이어에 QLoRA를 적용해 실행했습니다. Hugging Face + FA2 기준선과 비교해 표에는 Llama 3.3(70B)이 속도 2x, VRAM 75% 초과 절감, 13x 긴 컨텍스트로, Llama 3.1(8B)이 속도 2x, VRAM 70% 초과 절감, 12x 긴 컨텍스트로 나오며, 둘 다 80GB GPU 기준입니다.
Unsloth는 긴 컨텍스트 결과를 자체 그래디언트 체크포인팅 알고리즘과 Apple의 CCE 알고리즘 덕분으로 돌리고, 데이터가 많을수록 VRAM을 덜 쓴다고 말합니다. 이는 업체 벤치마크이며 독립적인 측정이 아닙니다.
Unsloth Studio는 파인튜닝한 모델을 포함해 모델을 safetensors 또는 GGUF로 내보내 llama.cpp, vLLM, Ollama, LM Studio 등 다른 런타임에서 쓸 수 있게 합니다. Unsloth에서 학습한 모델을 다른 소프트웨어로 옮기는 것이 바로 이 내보내기 단계입니다.
반대 방향으로 Unsloth는 OpenAI 호환 API로 로컬 모델을 서빙하며, ChatGPT/Codex 구독과 클라우드 제공업체도 연결할 수 있습니다. unsloth run 명령은 모델을 서빙하고 컨텍스트 크기, GPU 레이어, 스레딩, 샘플링, 네트워킹, 도구 구성 같은 설정을 바꿉니다.
Studio는 프리셋에서 시작하는 대신 YAML 학습 구성을 가져와 관련 설정을 미리 채울 수도 있습니다.
기본적으로 unsloth studio는 127.0.0.1에 바인딩되므로 로컬 머신에서만 접근할 수 있습니다. --secure 옵션은 무료 Cloudflare HTTPS 링크로만 서비스하며, 터널을 열 수 없으면 아예 시작되지 않으므로 원시 포트가 노출되지 않습니다.
unsloth start 명령으로 Claude Code, Codex 등 에이전트를 로컬 모델에 연결해, 에이전트 워크플로가 자신의 GPU에 있는 모델로 실행되게 합니다.| 플랜 | 표시 가격 | 속도 향상 | VRAM 절감 | GPU 지원 |
|---|---|---|---|---|
| Free | 무료 | 2x | 60% | 단일 |
| Unsloth Pro | 미표시(Contact us) | 2.5x GPU 수 | 80% | 멀티 |
| Unsloth Enterprise | 미표시(Contact us) | 32x GPU 수 | 90% | 멀티 + 노드 |
Unsloth Pro는 2.5x 빠른 학습, 20% 적은 VRAM, 최대 8개 GPU 지원을, Unsloth Enterprise는 30x 빠른 학습, 멀티 노드 지원, 30% 정확도를 내세우지만, 둘 다 Contact us 버튼만 보여 공개 가격이 표시되지 않습니다. Enterprise는 여기에 최대 +30% 정확도, 5x 빠른 추론, 전체 학습, 모든 Pro 기능, 멀티 노드 지원, 고객 지원을 추가로 나열합니다.
플랜 카드는 문서와 다르게 적혀 있습니다. Free 카드는 스스로를 Unsloth 표준 버전의 프리웨어로 설명하고 오픈소스로 표시하며, Mistral, Gemma, Llama 1, 2, 3 지원을 명시하고 MultiGPU는 여전히 출시 예정(coming soon)으로 둡니다. 플랜 비교표는 Free 등급을 속도 향상 2x, VRAM 절감 60%로 평가하는데, 이는 문서 전반에서 쓰는 2× 빠르고 VRAM 70% 절감이라는 수치와 다릅니다.
라이선스도 여기서 말하는 '무료'의 일부입니다. Unsloth는 이중 라이선스 모델을 써서 핵심 Unsloth 패키지는 Apache 2.0으로 유지하고, Unsloth Studio UI 같은 일부 선택형 구성 요소는 AGPL-3.0으로 둡니다. 회사는 이 구조가 프로젝트를 오픈소스로 유지하면서 지속적인 개발을 뒷받침하는 데 도움이 된다고 말합니다.
2026년 오픈소스 파인튜닝 프레임워크를 비교한 한 독립 분석은 Unsloth를 다른 세 프로젝트와 견주며 각각에 다른 역할을 부여합니다.
이 선택지들은 서로 배타적이지 않습니다. LLaMA-Factory는 Unsloth를 백엔드로 실행할 수 있고, TRL은 Unsloth 통합을 제공하며, Axolotl은 내부적으로 TRL 트레이너를 호출합니다. 따라서 LLaMA-Factory나 TRL을 골라도 그 아래에서는 여전히 Unsloth가 돌아갈 수 있습니다.
--disable-tools 플래그와 함께 다룹니다.studio/* 및 unsloth_cli/*)로 둡니다.Unsloth Desktop은 무료 오픈소스 앱으로 설명되며, Free 플랜이 표준 버전입니다. Unsloth Pro와 Unsloth Enterprise도 있지만 가격 페이지에는 가격 대신 Contact us가 표시됩니다.
모든 작업에 필요한 것은 아닙니다. Chat과 Data Recipes는 CPU에서 작동하고, Studio 학습은 NVIDIA, AMD, MLX, Intel 기기를 지원합니다. Windows에서의 학습은 NVIDIA GPU를 요건으로 명시합니다.
네. 이미 내려받은 모델은 자동으로 찾아지며, 감지되지 않으면 사용자 지정 폴더를 지정할 수 있습니다.
네. Unsloth는 GGUF 또는 safetensors로 내보내 llama.cpp, Ollama, vLLM, LM Studio 등의 런타임에서 쓸 수 있게 하며, 단 채팅 템플릿이 학습에 쓴 것과 일치해야 합니다.
핵심 패키지는 Apache 2.0이고, Unsloth Studio UI 같은 선택형 구성 요소는 AGPL-3.0입니다.
