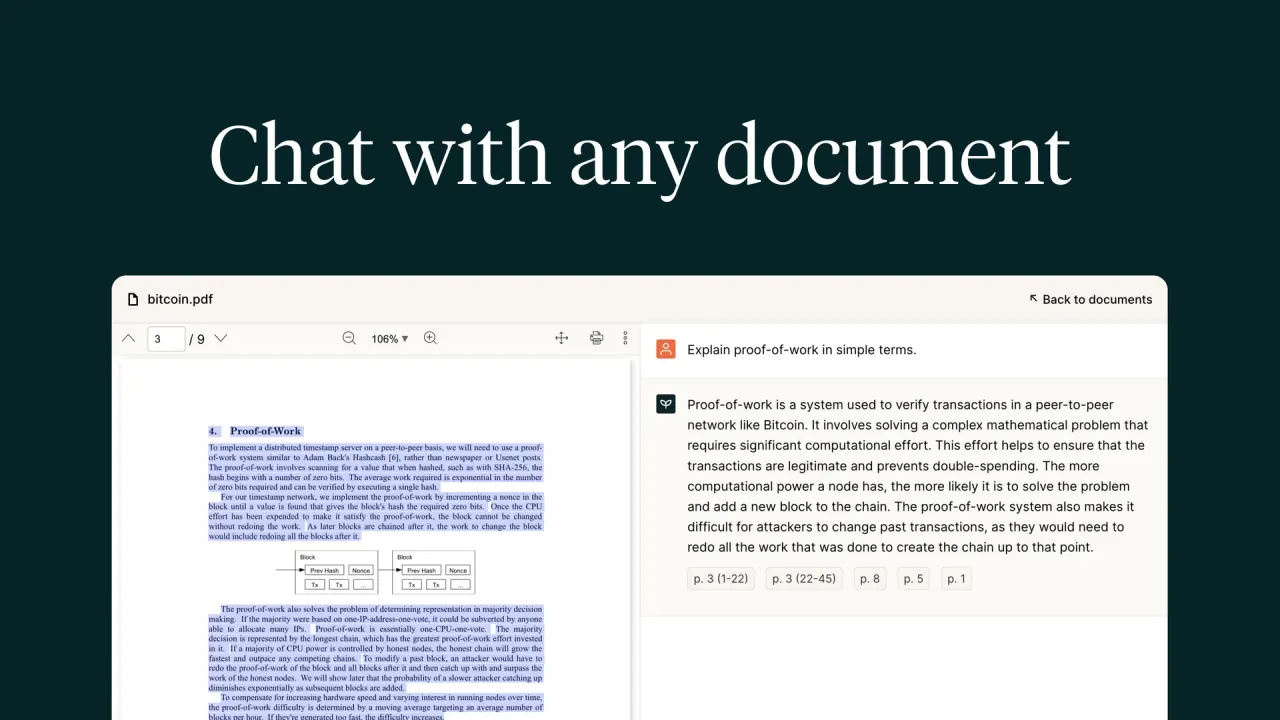
PDF.aiは、PDFファイルへの質問、文書の要約、情報の検索に使うPDFチャットサービス兼開発者プラットフォームです。ウェブ版は文書との会話が中心で、PDF APIは解析、構造化抽出、セクション識別、処理済みファイルへの質問を提供します。両経路の料金と使用量の尺度は別々です。
開発者向け製品は、PDFの構造化データへの変換、独自フィールドの抽出、セクションのインテリジェントな識別に重点を置いています。そのため、文書を読む人にも、その内容を別のアプリケーションに取り込む開発者にも関係する製品です。
v2 ParseエンドポイントはPDFをMarkdownまたはJSONに変換し、OCR、表の書式整形、画像抽出に対応します。
解析品質には2種類のモードが説明されています。既定のStandardではOCR言語を選択でき、言語リストのパラメーターは英語が既定値です。Advancedは視覚言語モデルを使い、言語を選ばずに複雑な文書で精度が向上する可能性があると説明されています。「可能性」という限定は重要です。これは処理方式の説明であり、あらゆるレイアウトやスキャンに対する実測精度の保証ではありません。
文書抽出では、渡したJSONスキーマで返すフィールドを定義します。v2 Extractエンドポイントは構造化データとともに、個々のフィールドを文書中の出典箇所に結び付ける引用を返します。
v2 Splitエンドポイントは入力された説明からセクションを識別し、そのセクションを含むページと信頼度を返します。セクション説明の入力はJSON配列で、各オブジェクトには名前が必須、説明は任意です。
v2 Askエンドポイントは、解析済みの1つ以上の文書について質問を受け付けます。同社は文書の全コンテキストを含むと説明しており、リクエストには文書IDの配列を渡します。この経路では解析が前提で、配列内のIDは処理済み文書を指す必要があります。
ウェブ製品には言語をまたぐ会話機能もあります。PDFと質問の言語は異なっていてもよく、回答は質問に使った言語に従うとベンダーは述べています。これは会話機能であり、OCRの全対応言語を定義したり、言語間で認識品質が等しいと示したりするものではありません。
APIリクエストはDeveloperページで生成したキーで認証します。キーの表示は生成時の一度だけで、紛失時は同じページで再生成できます。キーなしのリクエストはエラーを返します。
文書にある再利用パターンでは、文書IDと解析設定が中心になります。
文書IDと同じ設定による後続呼び出しではParse結果がキャッシュされ、キャッシュ応答の解析クレジットはゼロです。文書では、この再利用によりExtractとSplitの解析クレジットも節約できるとしています。
Parseエンドポイントは、コンテンツ抽出、ナレッジベース作成、検索拡張生成のワークフロー向けに位置付けられています。その流れでは、Markdownや構造化された文書内容を解析出力として使えます。
保存済みプロンプトのライブラリーは、よく使う質問を保存して後から呼び出すことで、繰り返しの質問を支援します。ベンダーは鉛筆の操作部で保存済みプロンプトを編集し、使わないものを削除する方法も説明しています。
ウェブの全体チャット機能は、アップロード済みPDFから関連する回答を検索し、質問のキーワードに最も関連すると判断したPDFを表示します。既存の文書群に質問しつつ、選択された出典文書とのつながりを保つ方法です。説明されている動作は、アップロードしたファイルからの関連性に基づく検索であり、すべての文書が各回答に等しく寄与するという主張ではありません。
PDF.aiは、求める結果がダウンロード可能な検索可能ファイルか、文書との会話か、コードから利用する応答かによって異なるニーズを満たします。ブラウザーOCRとAPIの経路は、その違いを明示しています。
PDF.aiのホスト型文書インターフェースにはウェブサイトからアクセスし、開発者による統合にはHTTP APIリクエストを使います。Parse文書にはcURL、Python、Node.js、PHPの例があります。
利用経路ごとに入口が異なります。
2026年10月29日に取得したウェブ価格では、有料プランは年払いの表示でした。Proは月額$10で年払い、Ultimateはユーザー当たり月額$20で年払い、Enterpriseはユーザー当たり月額$30で年払いです。Hobbyは永久無料と表示されていました。これは取得時の年払い料金であり、月払いを選んだ場合の金額を示すものではありません。
| ウェブプラン | 取得した価格 | 月間PDFアップロード | 月間質問数 | ファイル当たりOCR | 最大ファイルサイズ |
|---|---|---|---|---|---|
| Hobby | $0、永久無料 | 1 | 100 | 2ページ | 10MB |
| Pro | 月額$10、年払い | 100 | 1,000 | 10ページ | 50MB |
| Ultimate | ユーザー当たり月額$20、年払い | 無制限 | 無制限 | 50ページ | 50MB |
| Enterprise | ユーザー当たり月額$30、年払い | 無制限 | 無制限 | 100ページ | 100MB |
月間アップロード枠と質問枠は別々に数えます。
OCRにはファイル当たりのページ枠があり、最大ファイルサイズはMBで表します。ベンダーは、この製品OCR上限とAPIクレジット表を明確に区別しています。OCRのページ上限をAPIクレジット枠と読むことはできず、サイズ上限内のファイルであるだけでは、その全スキャンページがプランのOCR枠内に収まる根拠にもなりません。
v2のクレジット文書には、月200クレジットでクレジットカード不要の無料APIプランが記載されています。有料の月間プランのクレジット枠は次のとおりで、上記のウェブプランとは別です。
| API月額料金 | 月間クレジット |
|---|---|
| $0 | 200 |
| $49 | 3,000 |
| $99 | 10,000 |
| $249 | 30,000 |
| $599 | 100,000 |
Parseは標準モードで1ページ当たり1クレジット、高度モードで1ページ当たり2クレジットです。任意のLLM画像処理を有効にすると、文書上の追加費用は画像5枚ごとに1クレジットで、端数は切り上げます。同じ設定のキャッシュ済み解析結果は解析クレジットがゼロなので、繰り返し処理と初回解析では費用の内訳が異なります。
Extractエンドポイントはスキーマの大きさで抽出料金を計算します。フィールド数が5以下なら1ページ当たり2クレジット、5を超えると1ページ当たり4クレジットです。利用可能なキャッシュ済み解析結果がなければ、該当する解析料金を加えます。エンドポイントの例は、抽出をリクエスト当たりの一律料金とせず、抽出料金と初回解析を区別しています。
一方、短いクレジット概要ではExtractの2料金を「Standard」と「Advanced」とし、1ページ当たり2、4クレジットと表記しています。エンドポイントのリファレンスではフィールド数で区別します。公表された説明は同一ではなく、ここでは独自の1規則にまとめず、両方の表現を分けて保持しています。
Splitは1ページ当たり2クレジットに、該当する解析費用が加わります。文書によると文書IDを渡せば解析クレジットを避けられ、ファイルやURLを渡すと呼び出し中に解析が行われます。解析済み内容の再利用で変わるのは解析部分であり、Splitの料金は引き続き操作の一部です。
Askは、質問対象の全文書の総ページ数に3クレジットを掛けて課金します。文書の例では10ページの文書と5ページの文書を組み合わせ、45クレジットとなります。料金はリクエスト内の全ページ数に結び付いており、対象文書数を問わず質問1回が3クレジットという説明ではありません。
公表された解約方針では、一部返金も全額返金も提供しないとしています。Stripe Portalからいつでも解約でき、解約後は追加料金が発生しないと説明しています。そのため、解約と返金対象かどうかは別問題です。契約を止められることは、既存の請求額を返す約束ではありません。
2つの代替製品は近い文書チャットのニーズを扱いますが、重点は異なります。以下の違いは各競合の自社製品説明に基づき、どちらのサービスの精度についても独立した検証にはなりません。
Legacy v1専用API文書は、URL経由のPDFアップロードが最大100MB、直接ファイルアップロードが4.5MB、毎分500リクエストと記載しています。ページ数上限はない一方、非常にページ数の多いPDFには60秒のアップロードタイムアウトを説明しています。同じリファレンスでは旧Ultimate APIプランをサポート終了としています。これらはLegacy v1の記述で、ウェブアプリや現行v2エンドポイントの共通制限ではありません。
モデル名にもバージョンの境界があります。Legacy v1チャットのリファレンスはgpt-4o、gpt-4-turboを挙げ、メッセージ当たりそれぞれ2、4クレジットと応答言語パラメーターを記載しています。このメッセージ単位の説明はv1に属します。v2 Askのページ単位の式を置き換えず、ウェブのBasicやAdvancedの基盤モデルを特定するものでもありません。
プライバシーポリシーは、自発的に提供する連絡先情報、Cookieと端末情報、個人情報を守る合理的措置を説明しています。法律上必要な場合や依頼を遂行するために必要な場合を除き、個人情報を販売したり第三者に共有したりしないとしています。この例外も声明の一部であり、いかなる第三者も情報を一切受け取らないという無条件の約束ではありません。
確認したプライバシーポリシーは、アップロード文書の保存期間や、その資料をAIモデルの学習に使うかを明記していません。この開示範囲は機密ファイルに関係します。一般的な個人データの説明だけでは、PDF、抽出テキスト、会話内容がどれだけの期間利用可能なまま残るかは分かりません。
別のベンダーガイドには非公開文書のオプションがあります。非公開PDFファイルは同社のシステムにアップロードされず、文書閲覧はできなくなる一方、チャットは可能としています。設定はアップロード開始前に行う必要があります。これは非公開ファイルモードの説明であり、完全なローカル専用構成や、会話中の全情報について学習に使わないという約束を立証しません。
開発者向けマーケティング部分は処理後にファイルを削除すると述べています。v2削除リファレンスは別途、永久に除去できる保存済みPDFファイル、文書レコード、キャッシュ済み解析結果を説明します。これらの記述では自動保存の期間は未解決のままです。宣伝上の一文は、エンドポイントの具体的な保存・削除動作に代わる説明ではありません。
v2 Deleteエンドポイントは、v2 Parse、Extract、Splitで作成した文書だけに適用されます。関連文書レコード、ストレージ内のアップロードファイル、キャッシュ済み解析結果を永久に削除します。元に戻せず、APIクレジットはかかりません。その範囲から、他の全製品経路や旧版エンドポイントでも削除機構が同じとは言えません。
ウェブ上の文書削除には別の手順があります。ダッシュボードでDocumentsを開き、ファイル横のごみ箱アイコンを選び、アカウントから永久に除去するかを尋ねるポップアップに応答します。これはアカウント単位のユーザー操作の説明で、固定保存期間を示したり、AI学習への利用という別の問題を解決したりするものではありません。
異なります。Hobbyは月間PDFアップロード1件と月間質問100件です。無料APIプランは月200クレジットで、使用量はエンドポイントとページ数によって変わります。
はい。ベンダーは、ある言語のPDFをアップロードし、別言語で質問すると質問の言語で回答すると説明しています。OCR言語の選択は別の解析設定です。
公表方針はStripe Portalからの解約を認めますが、一部返金と全額返金はできないとしています。将来の料金を止めることと、既存の請求を返金することは別の方針です。