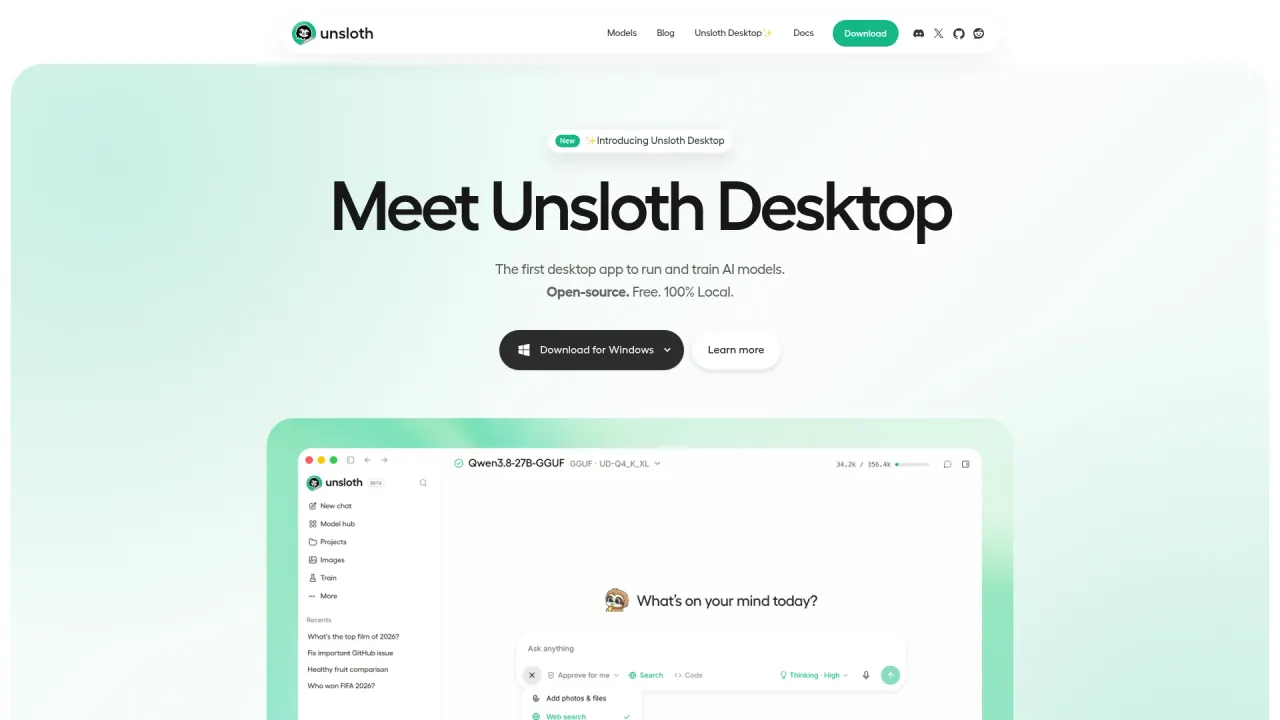
Unsloth es un framework, una app de escritorio y una interfaz web de código abierto para hacer ajuste fino y ejecutar LLM y modelos de difusión, audio y embeddings en tu propio hardware. Incluye entrenamiento sin código, LoRA, QLoRA y métodos RL, creación de conjuntos de datos y exportación a GGUF.
¿Has usado esta herramienta? Valórala
¿Has usado esta herramienta? Valórala
Unsloth es un framework de código abierto para ejecutar y entrenar LLM que permite ejecutar y entrenar modelos de IA en tu propio hardware local mediante una interfaz de código abierto. Abarca modelos de texto, visión, difusión de imagen y vídeo, audio y embeddings, tanto para la inferencia local como para el ajuste fino de LLM.
Unsloth se puede instalar de tres formas distintas: Unsloth Desktop como app nativa, Unsloth Studio como interfaz web en el navegador o Unsloth Core como el paquete de Python original basado en código. Desktop y Studio son las interfaces sin código; Core es la biblioteca que los desarrolladores llaman desde sus propios scripts de entrenamiento y notebooks.
Unsloth Desktop está marcado como Beta y se describe como una app gratuita y de código abierto para ejecutar y entrenar modelos de IA en tu propio hardware, disponible para macOS, Windows y Linux. Unsloth Studio también está en Beta y se presenta como una interfaz web sin código y de código abierto para entrenar, ejecutar y exportar modelos abiertos en una única interfaz local. La página de inicio resume Unsloth Desktop en tres palabras: código abierto, gratis y 100 % local. Un perfil de 2024 en la prensa económica informó de que los cofundadores de la empresa son los hermanos Michael y Daniel Han, que entonces participaban en Y Combinator.
La afirmación principal de Unsloth es que entrena modelos LLM, de difusión, TTS y de embeddings 2× más rápido, con un 70 % menos de VRAM y sin pérdida de precisión. Es la cifra del propio fabricante; las condiciones de prueba que la respaldan se detallan más abajo.
Los benchmarks de entrenamiento publicados se ejecutaron en GPU H100 y Blackwell con el conjunto de datos Alpaca, un tamaño de batch de 2, 4 pasos de acumulación de gradiente, rank 32 y QLoRA en todas las capas lineales. Frente a una línea base de Hugging Face + FA2, la tabla indica para Llama 3.3 (70B) velocidad 2x, más de un 75 % de reducción de VRAM y un contexto 13x más largo, y para Llama 3.1 (8B) velocidad 2x, más de un 70 % de reducción de VRAM y un contexto 12x más largo, ambos en GPU de 80 GB.
Unsloth atribuye sus resultados de contexto largo a su algoritmo de gradient checkpointing junto con el algoritmo CCE de Apple, y afirma que cuantos más datos hay, menos VRAM usa. Son benchmarks del fabricante, no mediciones independientes.
Unsloth Studio exporta modelos, incluidos los ajustados, a safetensors o GGUF para llama.cpp, vLLM, Ollama, LM Studio y otros entornos de ejecución. Ese paso de exportación es lo que lleva un modelo entrenado en Unsloth a otro software.
En la dirección opuesta, Unsloth sirve modelos locales mediante una API compatible con OpenAI y también puede conectar una suscripción de ChatGPT/Codex y proveedores en la nube. El comando unsloth run sirve un modelo y cambia ajustes como el tamaño de contexto, las capas de GPU, los hilos, el muestreo, la red y la configuración de herramientas.
Studio también puede importar una configuración de entrenamiento en YAML y rellenar de antemano los ajustes pertinentes en lugar de partir de los predefinidos.
Por defecto, unsloth studio se vincula a 127.0.0.1, de modo que solo la máquina local puede acceder. La opción --secure lo sirve solo a través de un enlace HTTPS gratuito de Cloudflare y no se inicia en absoluto si el túnel no puede establecerse, así que el puerto sin procesar nunca queda expuesto.
unsloth start, para que un flujo de agentes funcione con un modelo en tu propia GPU.| Plan | Precio indicado | Aumento de velocidad | Reducción de VRAM | Soporte de GPU |
|---|---|---|---|---|
| Free | Gratis | 2x | 60 % | Una |
| Unsloth Pro | No mostrado (Contact us) | 2,5x n.º de GPU | 80 % | Varias |
| Unsloth Enterprise | No mostrado (Contact us) | 32x n.º de GPU | 90 % | Varias + nodo |
Unsloth Pro se promociona con entrenamiento 2,5x más rápido, un 20 % menos de VRAM y soporte para hasta 8 GPU, y Unsloth Enterprise con entrenamiento 30x más rápido, soporte multinodo y un 30 % de precisión, pero ambos muestran solo un botón Contact us, así que ninguno tiene precio público. Enterprise enumera además hasta un +30 % de precisión, inferencia 5x más rápida, entrenamiento completo, todas las funciones de Pro, soporte multinodo y atención al cliente.
Las tarjetas de los planes no dicen lo mismo que la documentación. La tarjeta Free se describe como freeware de la versión estándar de Unsloth, la marca como de código abierto, cita compatibilidad con Mistral, Gemma y Llama 1, 2, 3, y sigue mostrando MultiGPU como próximamente (coming soon). La tabla de diferencias entre planes asigna al nivel Free un aumento de velocidad de 2x y una reducción de VRAM del 60 %, lo que difiere de la cifra de 2× más rápido y 70 % menos de VRAM que se usa en toda la documentación.
La licencia forma parte de lo que aquí significa «gratis». Unsloth usa un modelo de doble licencia: el paquete principal de Unsloth sigue bajo Apache 2.0, mientras que ciertos componentes opcionales, como la Unsloth Studio UI, están bajo AGPL-3.0. La empresa afirma que esta estructura ayuda a sostener el desarrollo continuo manteniendo el proyecto como código abierto.
Una comparación independiente de 2026 de frameworks de ajuste fino de código abierto enfrenta a Unsloth con otros tres proyectos y asigna a cada uno una función distinta:
Estas opciones no son excluyentes: LLaMA-Factory puede ejecutar Unsloth como backend, TRL incluye una integración con Unsloth y Axolotl llama internamente a los trainers de TRL. Por tanto, elegir LLaMA-Factory o TRL puede seguir implicando ejecutar Unsloth por debajo.
--disable-tools.studio/* y unsloth_cli/*).Unsloth Desktop se describe como una app gratuita y de código abierto, y el plan Free es la versión estándar. Unsloth Pro y Unsloth Enterprise existen, pero la página de precios muestra Contact us en lugar de un precio.
No para todas las tareas. Chat y Data Recipes funcionan en CPU, y el entrenamiento en Studio admite dispositivos NVIDIA, AMD, MLX e Intel. Para entrenar en Windows figura como requisito una GPU NVIDIA.
Sí. Los modelos ya descargados se detectan automáticamente, y puedes indicar carpetas personalizadas si los tuyos no se detectan.
Sí. Unsloth exporta a GGUF o safetensors para entornos de ejecución como llama.cpp, Ollama, vLLM y LM Studio, siempre que la plantilla de chat coincida con la usada en el entrenamiento.
El paquete principal está bajo Apache 2.0, mientras que componentes opcionales como la Unsloth Studio UI están bajo AGPL-3.0.
