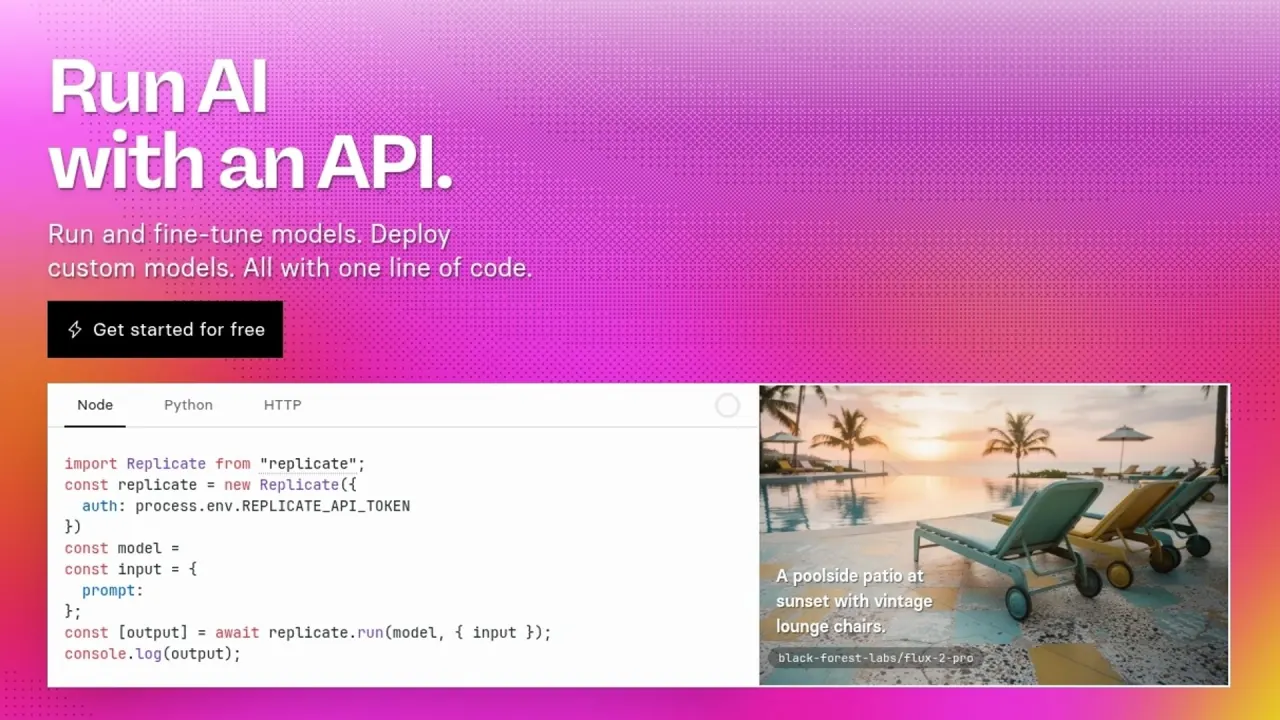
Replicate es una plataforma en la nube que ejecuta, ajusta y aloja modelos de IA detrás de una sola API HTTP. La mayoría se factura por segundo de GPU, los modelos oficiales por salida generada, y el crédito se compra por adelantado.
Replicate permite ejecutar modelos de IA con una API en la nube, sin entender machine learning ni gestionar infraestructura propia. Una petición HTTP envía una entrada a un modelo de imagen, vídeo, audio o lenguaje y devuelve el resultado: ninguna GPU que alquilar, ningún contenedor que construir. En el fondo es una API de modelos de IA.
Detrás de esa interfaz hay tres trabajos: ejecutar un modelo publicado por otra persona, ajustar uno con tus datos y desplegar código que tú mismo has empaquetado. Cada uno se alcanza con una línea de código.
El operador es Replicate, LLC., en 101 Townsend Street, San Francisco. El 17 de noviembre de 2025 cambió la propiedad: «la principal plataforma para ejecutar modelos de IA» anunció su paso a Cloudflare. La superficie de producto quedó expresamente fuera: el proveedor afirma que la API no cambia y que los modelos que usas hoy seguirán funcionando, y el comprador asumió el mismo compromiso, las API y los flujos de trabajo de los usuarios existentes seguirán funcionando sin interrupción. El desarrollo tampoco se detuvo: la entrada más reciente del registro de cambios añade archivos de instrucciones Markdown que dan a los asistentes de código conocimiento experto sobre el uso de modelos de IA en esta plataforma.
El tamaño del catálogo es una cifra del proveedor: el anuncio de la compra habla de más de 50.000 modelos de código abierto y modelos ajustados, y ningún recuento independiente apareció en los canales revisados.
Detrás de una sola API hay cuatro objetos que se comportan distinto en latencia y coste:
«Un modelo en la plataforma» no es, por tanto, un único perfil de rendimiento: los modelos oficiales están siempre calientes y listos para responder, así que se ejecutan sin preocuparse por los arranques en frío, mientras que un modelo comunitario poco usado se carga primero desde cero.
La capacidad se mueve en ambos sentidos sin configuración: si llega mucho tráfico, la plataforma escala automáticamente, y baja a cero cuando está inactiva. Cuando ese valor por defecto resulta laxo, la función de despliegue (deployment) permite, entre otras cosas, controlar el hardware y los parámetros de escalado de cualquier modelo. Para equipos, las organizaciones (organization) comparten el acceso a modelos, tokens de API, facturación y paneles.
El filtro de seguridad por defecto cubre un ámbito más estrecho de lo que sugiere su nombre: en predicciones lanzadas desde la web, el verificador solo se activa en el modelo base SDXL, el modelo base Flux y todos los ajustes derivados de ambos. Hay además una vía de escape: puedes desactivar el verificador de seguridad al ejecutar el modelo con la API, lo que deja la ruta de la API sin filtro garantizado.
La primera integración es corta, pero dos de estos pasos salen baratos ahora y caros después.
Las capacidades documentadas cubren un conjunto de tareas estrecho.
Los mismos hechos marcan el límite: tiempo de respuesta garantizado, ejecución de más de treinta minutos o salidas almacenadas para recuperarlas más tarde quedan fuera de lo documentado para una cuenta estándar.
Encaja con equipos de software que quieren inferencia GPU sin servidor sin poseer la pila de machine learning y pueden absorber una factura variable en vez de operar clústeres. Encaja también con autores de modelos: publicar y ajustar son aquí operaciones de primer nivel.
Cuatro situaciones encajan mal, y cada una se remonta a una cláusula publicada:
Todo es accesible por HTTP. Los clientes propios cubren Node.js, Python, Swift y Go, además de un cliente MCP alojado; otros ecosistemas como Elixir los mantienen colaboradores y no el proveedor, lo que cambia el soporte que puedes esperar.
También existe la vía del navegador, lo más rápido para ver las entradas de un modelo antes de escribir código.
Los precios de Replicate no tienen niveles de plan. Solo pagas lo que consumes: unos modelos se facturan por hardware y tiempo, otros por entrada y salida. Qué contador aplica es una propiedad del modelo, no de tu cuenta. En el contador de tiempo, la tarifa sigue al hardware:
| Hardware | Por segundo | Por hora |
|---|---|---|
| Nvidia T4 | $0.000225 | $0.81 |
| Nvidia L40S | $0.000975 | $3.51 |
| Nvidia A100 (80 GB) | $0.001400 | $5.04 |
| Nvidia H100 | $0.001525 | $5.49 |
Son precios por segundo de ejecución, no por petición: la mayoría se factura por el tiempo que tarda en ejecutarse, y el precio por segundo varía según el hardware en uso, de modo que un mismo prompt cuesta más en un modelo más pesado. El contador de salida funciona al revés: los modelos oficiales se tarifan con métricas previsibles como imágenes generadas, segundos de vídeo de salida o tokens de entrada y salida, con ejemplos publicados de $0.04 por imagen generada a $3.75 por millón de tokens de entrada. Solo ahí se calcula por adelantado un presupuesto por petición, y los niveles más altos ni siquiera son de autoservicio: la capacidad adicional multi-GPU H100 está disponible con contratos de gasto comprometido.
El arranque en frío es un problema de latencia en la capacidad compartida y de facturación en la dedicada. En el lado compartido, cuando usas un modelo público solo pagas el tiempo en que está procesando activamente tus peticiones; la puesta en marcha y el tiempo inactivo del modelo son gratuitos. La espera sigue siendo real: en algunos casos el proceso lleva varios minutos. Tampoco depende del todo de ti, porque por defecto compartes un grupo de hardware con otros clientes y tus peticiones entran en una cola común.
Eliminar la espera cambia el contador. En la capacidad dedicada pagas todo el tiempo en que las instancias del modelo están en línea: el que pasan arrancando, el que pasan inactivas esperando peticiones y el que pasan procesándolas activamente. Los ajustes de arranque rápido son la excepción y solo se cobran por el tiempo de procesamiento activo, sean públicos o privados.
El acceso gratuito existe, acotado y sin cifras. Puedes ejecutar gratis una selección de modelos hasta que se te pida configurar la facturación, sin importe, lista de modelos ni duración asociados. Las cuentas sin fondos además se limitan: si te han concedido crédito y no tienes un método de pago registrado, quedas limitado a 1 petición por segundo y un máximo de 6 peticiones por minuto.
El acceso de pago es prepago y caduca. El crédito comprado es válido 1 año desde la fecha de compra y no es reembolsable salvo cuando la ley lo exija; el contrato repite la regla de caducidad: cada pago destinado a cargar el saldo prepago caduca al final del duodécimo mes siguiente a la fecha de pago si no se ha consumido por completo. La recarga automática tiene mínimos — umbral mínimo de $5 y saldo mínimo de recarga de $15 — y en cuanto el saldo llega a cero se bloquea el trabajo nuevo y se apaga la infraestructura en marcha.
Las condiciones empresariales se negocian: gestor de cuenta dedicado, soporte prioritario, límites de GPU más altos y SLA de rendimiento, con descuentos por volumen ligados a un compromiso de gasto.
Dos hechos hacen casi toda la comparación. El primero es la amplitud: los usuarios de empresa acceden a más de 50.000 modelos con una sola API y un solo contrato, algo distinto de un servicio afinado para una única modalidad. El segundo es que la configuración más barata es la compartida, y ahí te encontrarás a veces con arranques en frío o límites de escalado según cómo usen ese modelo los demás clientes.
Las fuentes independientes nombran el terreno en vez de ordenarlo. Un artículo técnico firmado, publicado cuando la empresa salió a la luz en febrero de 2023, describía un mercado abarrotado: la startup compite con proveedores como Hugging Face y OctoML, y en cierta medida Runway ML, que en conjunto han levantado cientos de millones de dólares. Una discusión pública entre desarrolladores produjo después una lista más larga desde la práctica: ¿cuántos actores hay en este espacio? Replicate, RunPod, Modal, Northflank, FAL.
Tres preguntas los separan: ¿publica el proveedor una tarifa de hardware por segundo o solo un precio por salida?; ¿cobra el tiempo inactivo una vez fijadas las instancias?; ¿conserva tus salidas o las borra con un temporizador? Ninguna prueba comparativa independiente alcanzó el umbral de fuente en esta ronda: las páginas de comparación encontradas procedían de plataformas competidoras o de agregadores movidos por enlaces de referencia.
La documentación y el contrato dicen cosas distintas sobre el trabajo que falla. La documentación de facturación indica que una ejecución fallida no se cobra en ningún modelo, mientras que cancelar una ejecución de un modelo oficial sí puede facturarse. Los términos dicen lo contrario: las ejecuciones parciales y los intentos fallidos son facturables según el punto exacto de fallo registrado en los registros del proveedor. Una tercera regla cubre los modelos encadenados: si el modelo falla, se factura la duración de la ejecución más el coste de los modelos posteriores llamados antes del fallo. Estas páginas no son coherentes entre sí, y esos mismos registros son el documento con el que se resuelven las disputas de facturación, de modo que una carga con muchos fallos necesita la regla aplicable por escrito.
En un plan de autoservicio no hay nada fijado por contrato. El proveedor se reserva el derecho, a su sola discreción, de introducir cambios en el servicio en cualquier momento, incluida la limitación o retirada de funciones concretas, de forma temporal o permanente y sin previo aviso. Sin compromiso de disponibilidad, un modelo del que dependa tu producto puede desaparecer sin aviso: fija versiones y guarda una alternativa. La resolución de disputas también está acotada: se aplica la ley del Estado de California y no se permiten procedimientos de arbitraje colectivo.
Una interfaz uniforme oculta licencias que no lo son: no debes usar modelos de machine learning incumpliendo las restricciones de licencia de código abierto de su propietario. Licencias permisivas, uso solo para investigación y condiciones propietarias conviven tras la misma llamada.
La retención es asimétrica. Las predicciones hechas por API se borran con un temporizador de una hora, mientras que los datos de las predicciones creadas desde la interfaz web se conservan indefinidamente, así que es la vía del navegador la que acumula historial. La supervisión es explícita: el proveedor se reserva el derecho de supervisar tu uso del servicio para comprobar el cumplimiento de la política, lo que incluye revisiones automáticas y manuales de contenidos y actividades. La política de privacidad advierte además de que los datos de entrenamiento subidos pueden contener cualquier tipo de información, parte de la cual podría considerarse «sensible» según diversas leyes de privacidad.
Los derechos sobre la salida son amplios pero condicionados. El proveedor te concede todos los derechos, títulos e intereses que pueda haber sobre la salida, incluido su uso comercial como la venta o la publicación, sujeto a los términos de terceros aplicables, condición que no es otra que la licencia del modelo que la generó. A cambio, concedes sobre tus entradas una licencia limitada a lo necesario para proporcionar la salida, entrenar y generar modelos derivados del cliente, prestar el servicio conforme a los términos y crear y compilar los Resultant Data. Sobre si esas entradas entrenan los modelos propios del proveedor, las políticas publicadas no dicen ni que sí ni que no.
La plataforma declara que no «vende» ni «comparte» información personal en el sentido de las leyes de privacidad de los estados de EE. UU., y la política indica que no se recopila intencionadamente información personal de menores de 16 años.
Hay una asignación gratuita acotada, no un plan gratuito: algunos modelos se ejecutan gratis hasta que se te pide configurar la facturación, y no se publica ni cuota, ni duración, ni lista de modelos. Mientras no haya un método de pago registrado, el rendimiento está limitado a una petición por segundo.
En los modelos públicos no: allí el tiempo de puesta en marcha y el tiempo inactivo son gratuitos. Cambia en cuanto fijas capacidad: las instancias dedicadas y los despliegues también cobran puesta en marcha e inactividad.
Sí. El crédito vale un año desde la fecha de compra y el contrato indica que cada pago caduca al final del duodécimo mes posterior si no se ha consumido por completo. Los saldos prepago no son reembolsables, salvo cuando la ley lo exija o el acuerdo lo prevea expresamente.
Por defecto no en la API: entradas, salidas, archivos y registros se eliminan al cabo de una hora, así que lo que necesites hay que copiarlo fuera. Solo las predicciones creadas en el navegador se conservan hasta que las borres.
