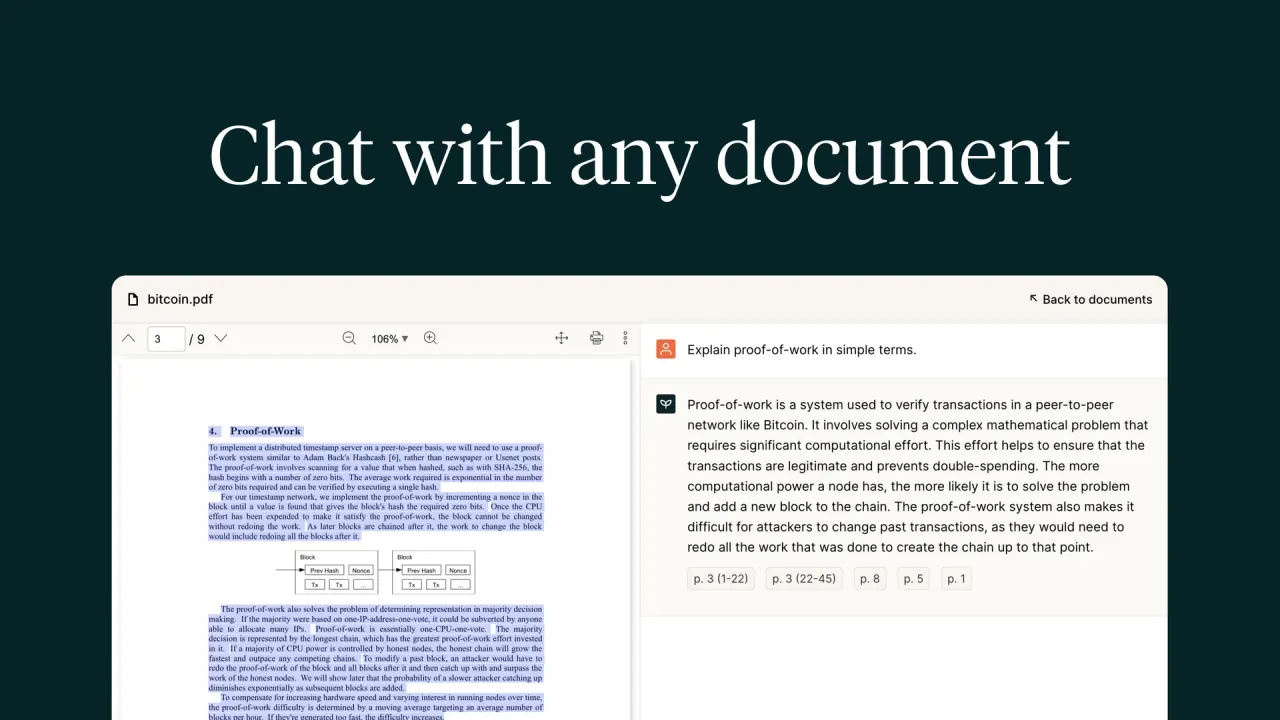
Haz preguntas sobre varios PDF, obtén resúmenes o convierte documentos en datos estructurados. Una API independiente ofrece análisis, extracción por esquema, detección de secciones y preguntas documentales.
¿Has usado esta herramienta? Valórala
¿Has usado esta herramienta? Valórala
PDF.ai es un servicio de chat con PDF y una plataforma para desarrolladores que permite hacer preguntas, resumir documentos y extraer información de archivos PDF. La experiencia web se centra en conversar con documentos; su API PDF ofrece análisis, extracción estructurada, identificación de secciones y preguntas sobre archivos procesados. Las dos vías de acceso tienen precios y medidas de uso independientes.
La oferta para desarrolladores se orienta a convertir PDF en datos estructurados, extraer campos personalizados e identificar secciones de forma inteligente. Por eso, el producto resulta relevante tanto para quien lee un documento como para un desarrollador que traslada su contenido a otra aplicación.
El endpoint v2 Parse convierte un PDF a Markdown o JSON y admite OCR, formato de tablas y extracción de imágenes.
Se describen dos modos de calidad de análisis. Standard es el predeterminado y permite seleccionar el idioma del OCR; su parámetro de lista de idiomas usa inglés por defecto. Advanced utiliza modelos de visión y lenguaje y se presenta como una opción que podría mejorar la precisión en documentos complejos sin seleccionar un idioma. Ese «podría» importa: la documentación describe una opción de procesamiento, no una garantía de precisión medida para cualquier diseño o escaneo.
La extracción de documentos utiliza un esquema JSON proporcionado para definir los campos que se devolverán. El endpoint v2 Extract devuelve datos estructurados junto con citas que vinculan cada campo con fragmentos de origen del documento.
El endpoint v2 Split identifica secciones a partir de las descripciones facilitadas y devuelve las páginas que las contienen, junto con niveles de confianza. La entrada de descripciones de secciones es una matriz JSON; cada objeto necesita un nombre y también puede incluir una descripción.
El endpoint v2 Ask acepta preguntas sobre uno o varios documentos ya analizados. La empresa lo describe como una función que incluye todo el contexto documental, y la solicitud aporta una matriz de identificadores de documentos. El análisis es un requisito previo de esta vía: los identificadores de la matriz deben corresponder a documentos ya procesados.
La conversación entre idiomas también forma parte del producto web. Un PDF puede estar en un idioma y la pregunta en otro; según el proveedor, la respuesta sigue el idioma de la pregunta. Es una función conversacional: no define una lista completa de idiomas OCR ni demuestra una calidad de reconocimiento idéntica entre idiomas.
Las solicitudes API se autentican con una clave generada desde la página Developer. La clave solo se muestra una vez al generarla; si se pierde, puede regenerarse desde la misma página. Las solicitudes sin clave devuelven un error.
El patrón de reutilización documentado se basa en el identificador del documento y los ajustes de análisis:
Los resultados de Parse se almacenan en caché para llamadas posteriores con un identificador de documento y los mismos ajustes; las respuestas en caché consumen cero créditos de análisis. La documentación también indica que esta reutilización puede ahorrar créditos de análisis en Extract y Split.
Parse se presenta para la extracción de contenido, la creación de bases de conocimiento y los flujos de generación aumentada por recuperación. En estos flujos, Markdown o el contenido documental estructurado pueden servir como salida del análisis.
Una biblioteca de instrucciones guardadas permite conservar las preguntas favoritas y recuperarlas más adelante para consultas recurrentes. El proveedor también describe cómo editar las instrucciones guardadas mediante un control con forma de lápiz y eliminar las que ya no se utilizan.
La función web de conversación con todos los documentos busca respuestas pertinentes en los PDF cargados y muestra el PDF que considera más relevante para las palabras clave de la pregunta. Permite consultar una colección existente y mantener la conexión con el documento fuente seleccionado. El comportamiento descrito es una recuperación basada en la relevancia dentro de los archivos cargados, no la afirmación de que todos los documentos contribuyen por igual a cada respuesta.
PDF.ai atiende necesidades distintas según se busque un archivo descargable con capacidad de búsqueda, una conversación documental o una respuesta consumida por código. Sus vías de OCR en el navegador y API hacen explícita esa distinción:
La interfaz documental alojada de PDF.ai se utiliza a través del sitio web, y las integraciones para desarrolladores usan solicitudes HTTP API. La documentación de Parse incluye ejemplos en cURL, Python, Node.js y PHP.
Las vías disponibles tienen distintos puntos de entrada:
Los precios web capturados el 29 de octubre de 2026 mostraban facturación anual en los niveles de pago. Pro figuraba a $10 al mes con facturación anual, Ultimate a $20 por usuario al mes con facturación anual y Enterprise a $30 por usuario al mes con facturación anual. Hobby aparecía como gratuito para siempre. Son las tarifas capturadas con facturación anual; no establecen el importe al seleccionar facturación mensual.
| Plan web | Precio capturado | Cargas PDF mensuales | Preguntas mensuales | OCR por archivo | Tamaño máximo de archivo |
|---|---|---|---|---|---|
| Hobby | $0, gratuito para siempre | 1 | 100 | 2 páginas | 10MB |
| Pro | $10/mes, facturación anual | 100 | 1,000 | 10 páginas | 50MB |
| Ultimate | $20/usuario/mes, facturación anual | Ilimitadas | Ilimitadas | 50 páginas | 50MB |
| Enterprise | $30/usuario/mes, facturación anual | Ilimitadas | Ilimitadas | 100 páginas | 100MB |
Las cuotas mensuales de cargas y preguntas son contadores independientes.
El OCR tiene una cuota de páginas por archivo, mientras que el tamaño máximo se expresa en MB. El proveedor distingue expresamente estos límites OCR del producto de la tabla de créditos API. Por tanto, el límite de páginas OCR no puede interpretarse como una cuota de créditos API; que un archivo cumpla el tamaño máximo no demuestra por sí solo que todas sus páginas escaneadas entren en la cuota OCR del plan.
La documentación de créditos v2 indica un plan API gratuito con 200 créditos al mes y sin necesidad de tarjeta de crédito. Sus niveles mensuales de pago utilizan las siguientes cuotas, independientes de los planes web anteriores.
| Precio mensual API | Créditos al mes |
|---|---|
| $0 | 200 |
| $49 | 3,000 |
| $99 | 10,000 |
| $249 | 30,000 |
| $599 | 100,000 |
Parse cuesta 1 crédito por página en modo estándar y 2 créditos por página en modo avanzado. Al activar el procesamiento opcional de imágenes mediante LLM, el coste adicional documentado es de 1 crédito por cada cinco imágenes, redondeando hacia arriba. Los resultados de análisis en caché con los mismos ajustes consumen cero créditos de análisis, de modo que un procesamiento repetido y un primer análisis tienen componentes de coste distintos.
Extract calcula los cargos de extracción según el tamaño del esquema: hasta cinco campos cuesta 2 créditos por página, y más de cinco campos cuesta 4 créditos por página. Se añaden los cargos de análisis aplicables si no hay un resultado analizado en caché. Los ejemplos del endpoint distinguen el cargo de extracción del análisis inicial en lugar de tratar la extracción como una tarifa única por solicitud.
El breve resumen de créditos, en cambio, etiqueta las dos tarifas de Extract como «Standard» y «Advanced», a 2 y 4 créditos por página. La referencia del endpoint utiliza el número de campos para esa distinción. Estas descripciones publicadas no son idénticas; aquí se mantienen separadas las dos formulaciones, sin combinarlas en una única regla inventada.
Split cobra 2 créditos por página además del análisis aplicable. Su documentación dice que pasar un identificador de documento evita los créditos de análisis, mientras que proporcionar un archivo o una URL provoca un análisis durante la llamada. Reutilizar el contenido analizado cambia ese componente de análisis; el cargo de Split sigue formando parte de la operación.
Ask cobra 3 créditos multiplicados por el número total de páginas de todos los documentos consultados. El ejemplo documentado combina un documento de 10 páginas y otro de 5 páginas, con un coste de 45 créditos. El cargo depende del total íntegro de páginas de la solicitud, no se describe como tres créditos por cualquier pregunta independientemente de cuántos documentos abarque.
La política de cancelación publicada dice que no se ofrecen reembolsos parciales ni completos. Permite cancelar la suscripción en cualquier momento mediante Stripe Portal y afirma que no habrá cargos posteriores una vez cancelada. Por tanto, la cancelación y el derecho a reembolso son cuestiones diferentes: poder detener una suscripción no promete devolver un cargo ya realizado.
Dos alternativas atienden necesidades próximas de conversación documental, con énfasis diferentes. Las distinciones siguientes proceden de las descripciones de cada competidor y no constituyen una validación independiente de la precisión de ninguno de los servicios.
La documentación API específica de Legacy v1 indica un máximo de 100MB para cargar PDF por URL y de 4.5MB para cargar archivos directamente, junto con 500 solicitudes por minuto. No establece un límite de páginas, pero describe un tiempo de espera de 60 segundos para cargar PDF con muchas páginas. La misma referencia marca el antiguo plan API Ultimate como ya no compatible. Son afirmaciones de Legacy v1, no límites universales asignados a la aplicación web ni a los endpoints v2 actuales.
Los modelos nombrados también tienen una frontera de versión. La referencia de chat Legacy v1 enumera gpt-4o y gpt-4-turbo con cargos de 2 y 4 créditos por mensaje, respectivamente, y un parámetro de idioma de respuesta. Esa descripción por mensaje pertenece a v1; no sustituye la fórmula por páginas de v2 Ask ni identifica el modelo detrás de un nivel web llamado Basic o Advanced.
La política de privacidad describe información de contacto proporcionada voluntariamente, cookies y datos del dispositivo, así como medidas razonables para proteger la información personal. Dice que no se vende ni comparte información personal con terceros salvo cuando lo exige la ley o es necesario para atender solicitudes. Las excepciones forman parte de esa afirmación; no es una promesa incondicional de que ningún tercero reciba jamás información.
La política de privacidad revisada no indica un plazo de conservación de documentos cargados ni si el material cargado se utiliza para entrenar modelos de IA. Este límite de divulgación es relevante para archivos sensibles: el texto general sobre datos personales no documenta por sí mismo cuánto tiempo siguen disponibles un PDF, su texto extraído o su contenido conversacional.
Una guía del proveedor describe por separado una opción de documento privado. Dice que el archivo PDF privado no se cargará en los sistemas de la empresa, que la visualización documental deja de estar disponible y que el chat sigue siendo posible. La opción debe configurarse antes de iniciar la carga. Es una afirmación sobre el modo de archivo privado; no demuestra una arquitectura totalmente local ni un compromiso de no entrenar con toda la información implicada en una conversación.
La sección comercial para desarrolladores afirma que los archivos se eliminan después del procesamiento. La referencia de eliminación v2 describe por separado un PDF almacenado, un registro documental y resultados de análisis en caché que pueden borrarse permanentemente. Estas descripciones dejan sin resolver el calendario de conservación automática; la frase comercial no sustituye el comportamiento específico de almacenamiento y eliminación del endpoint.
El endpoint v2 Delete solo se aplica a documentos creados mediante v2 Parse, Extract o Split. Elimina permanentemente el registro documental asociado, el archivo cargado en el almacenamiento y los resultados de análisis en caché; la eliminación no se puede deshacer y no consume créditos API. Su alcance no establece el mismo mecanismo de eliminación para todas las demás vías del producto ni para endpoints antiguos.
La eliminación web de documentos tiene un flujo documentado distinto: abrir Documents en el panel, seleccionar el icono de papelera junto a un archivo y responder a la ventana que pregunta si se desea retirarlo permanentemente de la cuenta. Esta instrucción a nivel de cuenta describe un control del usuario. No aporta un plazo fijo de conservación ni resuelve la cuestión independiente del uso para entrenar IA.
No. Hobby indica una carga de PDF y 100 preguntas mensuales. El plan API gratuito, en cambio, indica 200 créditos al mes, cuyo uso depende del endpoint y del número de páginas.
Sí. El proveedor documenta cargar un PDF en un idioma y preguntar en otro, con respuestas en el idioma de la pregunta. La selección de idioma OCR es un ajuste de análisis independiente.
La política publicada permite cancelar mediante Stripe Portal, pero dice que no hay reembolsos parciales ni completos. Detener cargos futuros y reembolsar un cargo existente son políticas diferentes.
