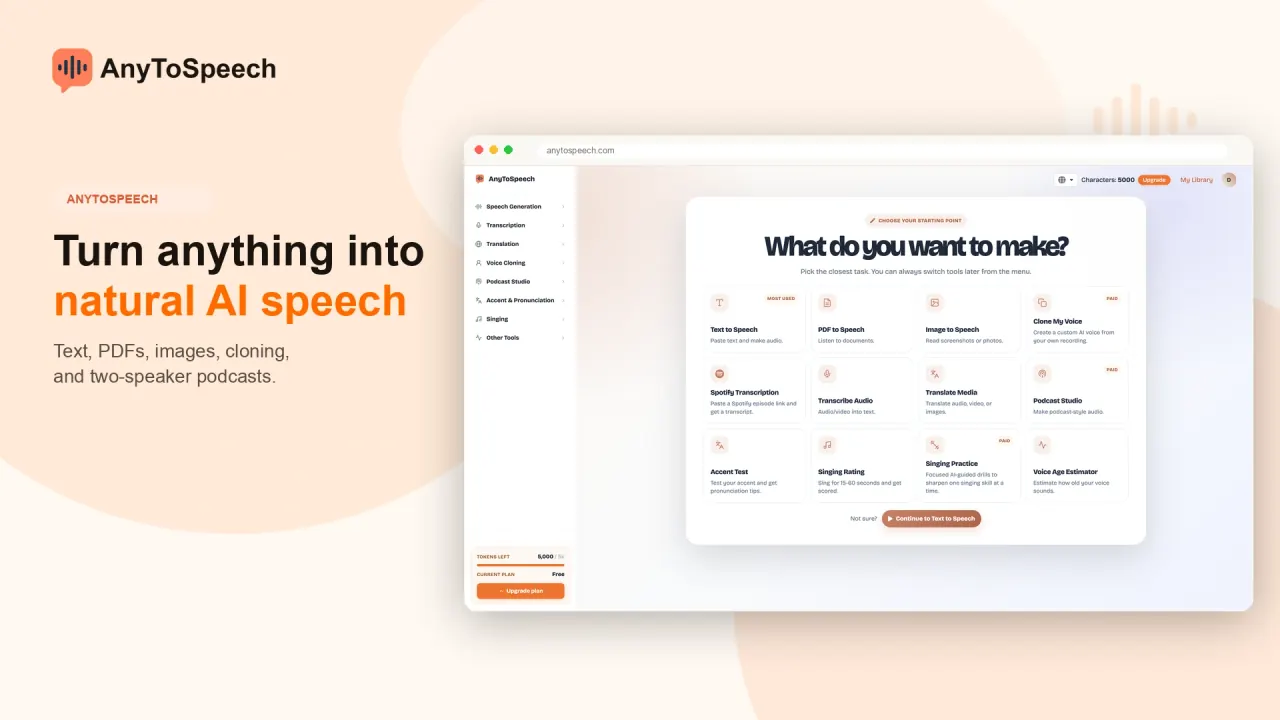
Convierte textos y documentos en voz, transcribe grabaciones, crea diálogos y pódcast, y analiza tu acento o canto. El navegador, el móvil y MCP comparten la cuenta de AnyToSpeech.
¿Has usado esta herramienta? Valórala
¿Has usado esta herramienta? Valórala
AnyToSpeech combina generación de voz, transcripción, traducción y análisis de voz en un mismo servicio. La escucha de documentos, las conversaciones con guion, las voces personalizadas y las evaluaciones vocales breves complementan esas tareas principales.
La conversión de texto a voz transforma texto sin formato, documentos o PDF en audio, con selección de voces y descarga MP3. El servicio tiene vías de creación separadas para leer documentos, interpretar un guion escrito y componer una conversación a partir de un tema.
El acceso varía según la función: la muestra gratuita, la cuota mensual y la generación de pago son ofertas distintas.
Las transcripciones terminadas se pueden recuperar desde My Library sin mantener abierta la página de procesamiento. La función de transcripción también anuncia traducción y descargas en formato TXT o DOCX.
La biblioteca incluye muestras y filtros por idioma, género, tono y acento. El filtro de género ofrece opciones femenina, masculina y neutra.
La clonación de voz comienza con tres grabaciones guiadas, cada una de 10–15 segundos. Se admite la grabación en el navegador y la carga de archivos WAV, MP3 o M4A existentes. El clon resultante pasa a ser una voz reutilizable dentro del servicio.
Las preguntas frecuentes de clonación enumeran 27 idiomas, entre ellos inglés, francés, español, alemán, portugués de Brasil, japonés, coreano, chino y árabe. Esa cifra corresponde a la clonación y no es un total único de idiomas para todas las herramientas. Voice Design enumera por separado inglés, francés, español, alemán, portugués, italiano, japonés, coreano y chino.
Voice Design acepta 13 atributos estructurados o una descripción libre de 30–250 caracteres. Los atributos abarcan dialecto, género, edad, emoción, tono, altura, volumen, velocidad, claridad, fluidez, personalidad, textura y entorno. Esta vía basada en una descripción no necesita grabaciones.
Cada solicitud de Voice Design produce tres muestras de voz para comparar. Una vez guardado, el resultado se convierte en una voz personalizada disponible en las herramientas compatibles de AnyToSpeech. Hay que leer con cuidado las condiciones de acceso: se denomina función Pro, pero también se describe como incluida junto con la clonación en los planes de pago. Esa redacción no la limita claramente al nivel del sitio llamado Pro.
Multi-Speaker Text to Speech admite entre dos y seis hablantes, pausas e indicaciones emocionales, y mezcla la conversación en un solo MP3. El usuario escribe el diálogo y controla quién dice cada frase.
Podcast Studio genera, a partir de un tema, un MP3 con dos hablantes, música de introducción y un título de episodio pronunciado. También acepta un guion preparado. La introducción forma parte del episodio generado.
Los episodios por tema tienen duraciones habladas objetivo de 2, 5, 10 o 20 minutos; los guiones pegados pueden contener hasta 12,000 caracteres. Son duraciones objetivo y un límite de entrada de guion independiente.
English Accent Test analiza un pasaje leído para estimar la lengua materna, dar una puntuación de proximidad a un nativo y examinar rasgos de vocales, consonantes y entonación. Son las categorías de análisis declaradas por la empresa, no una certificación independiente de fluidez.
El análisis del canto informa sobre altura, ritmo, timbre, rango vocal, expresión, control de la respiración y claridad de la letra, junto con una etiqueta de tipo de voz. Evalúa la interpretación vocal enviada.
El editor de varios hablantes permite controlar frases individuales, hablantes y pausas.
Antes de grabar un pódcast con IA, se puede revisar y reescribir el guion, reasignar frases entre hablantes y añadir notas de interpretación. La página indica que el cobro se produce al pulsar Record.
La línea de tiempo del pódcast permite arrastrar y recortar clips, volver a grabar una frase, cambiar el volumen de cada hablante y deshacer cambios. Se pueden revisar oraciones individuales sin sustituir todo el episodio.
Guardar actualiza el episodio en la biblioteca y la versión reproducida desde su enlace compartido. La descarga devuelve la última edición, con la portada incluida dentro del MP3.
La distinción útil es si el resultado debe conservar frases escritas, explicar material de origen en una discusión generada o leer un documento en voz alta.
Las muestras gratuitas, los requisitos de generación de pago y las condiciones siguientes sobre el uso de los resultados y del sitio son límites importantes para la producción.
AnyToSpeech tiene aplicaciones para iPhone y Android. Las entradas desde distintas plataformas no demuestran que los catálogos o los límites sean idénticos en todas las interfaces.
La configuración de MCP utiliza el inicio de sesión de la cuenta para ChatGPT, Claude, Cursor o VS Code; Perplexity y Meta Muse utilizan una clave de integración.
El uso de MCP consume los créditos, minutos de transcripción y límites del plan que ya tiene la cuenta. La creación mediante asistentes comparte el mismo presupuesto de uso que el acceso al sitio.
El sitio ofrece los niveles Free, Hobby, Standard y Pro. La tabla muestra los precios Monthly y las prestaciones registradas el 29 de octubre de 2026. El signo $ es el símbolo mostrado; no se especifica un código de moneda ISO.
| Nivel del sitio | Precio mensual mostrado | Caracteres de voz al mes | Minutos de transcripción al mes | Cuota de clones de voz |
|---|---|---|---|---|
| Free | $0 | 5,000 | 50 | No incluido |
| Hobby | $7 | 50,000 | 200 | 1 |
| Standard | $14 | 100,000 | 1,000 | 3 |
| Pro | $69 | 1,000,000 | 5,000 | 10 |
La página de precios describe las conversiones de voz de Free como de unos 30 segundos cada una y excluye las voces prémium de ese nivel. La tarjeta Free de inicio muestra, en cambio, unos 15 segundos de audio. La interfaz independiente de transcripción fija la cuota Free en 50 minutos al mes. Los caracteres de voz y los minutos de transcripción son contadores mensuales separados.
La voz con varios hablantes usa un crédito por carácter y las cuentas nuevas incluyen créditos gratuitos. El uso de caracteres y los minutos de transcripción se miden por separado.
La interfaz de precios ofrece opciones Monthly y Yearly con la etiqueta «Save 40%+». Sin embargo, sus preguntas frecuentes de facturación siguen describiendo todos los planes como suscripciones mensuales, dicen que la asignación de caracteres se renueva cada mes y que los caracteres no usados pasan al mes siguiente. El selector anual y la redacción solo mensual coexisten; no proporcionan una explicación plenamente coherente de los intervalos de cobro.
Las suscripciones se pueden cancelar, pausar, mejorar o reducir en cualquier momento. Solo se permiten reembolsos en los siete días posteriores a la compra si no se ha utilizado el producto, mediante solicitud por correo electrónico. La condición de no uso forma parte de la política; no es una prueba incondicional de siete días después de usarlo para producir contenido.
Luvvoice ofrece conversión de texto a voz con escucha en el navegador y descargas MP3. Es una comparación pertinente para trabajos directos de texto a audio.
Luvvoice también acepta documentos PDF y TXT para convertirlos en voz. Esto se solapa con la escucha de documentos y la conversión de guiones pegados, sin demostrar igualdad de calidad vocal, condiciones o límites de producción.
Narakeet ofrece conversión de documentos a audio y flujos de PowerPoint o Markdown a vídeo. Su vía de vídeo con diapositivas merece una consideración distinta cuando el entregable incluye una presentación visual, además de una narración o un archivo de conversación sonora.
Narakeet también convierte subtítulos SRT o WebVTT en audio sincronizado con sus marcas de tiempo. Es relevante cuando las marcas temporales existentes definen el resultado.
La generación de Podcast Studio requiere un plan de pago; las cuentas Free pueden preescuchar voces en la página. Por tanto, una entrada visible de «probar» no significa que una cuenta gratuita pueda producir un episodio terminado.
El evaluador de canto espera una interpretación de 15–60 segundos y da al tarareo sin palabras una puntuación de claridad de letra menor. Esa regla importa al interpretar el resultado global: un ejercicio vocal sin palabras no se evalúa exactamente igual que una interpretación con letra inteligible.
Las condiciones del sitio excluyen a menores y personas de menos de 18 años. La restricción se aplica aunque los usos educativos y la escucha por estudiantes formen parte del posicionamiento del producto; esos públicos no indican que todos los usuarios en edad escolar puedan utilizarlo.
El sitio describe las voces de personas identificadas como recreaciones de IA para entretenimiento, sin vinculación, verificación ni respaldo de dichas personas. Incluye un generador de estilo Donald Trump. No se han verificado de forma independiente el resultado generado ni el permiso de las personas identificadas.
En el generador de voces de personas identificadas, los invitados y las cuentas gratuitas tienen un máximo de cinco generaciones por mes natural, de hasta 500 caracteres cada una. Es una cuota específica de la herramienta y no debe interpretarse como la asignación general de caracteres de voz del plan.
La página comercial de clonación utiliza el reclamo «Start Cloning -- It's Free». En cambio, la comparación de precios excluye la clonación de Free y enumera cuotas de clones en los niveles de pago. La redacción pública da, por tanto, impresiones distintas sobre si crear un clon está incluido en el acceso gratuito.
La tarjeta Free de inicio tacha el uso comercial de todos los resultados. La página de precios dedicada también incluye el uso comercial entre las funciones no incluidas en Free.
Las preguntas frecuentes de texto a voz permiten publicaciones sociales monetizadas, anuncios de pago, sistemas IVR y mensajes de voz para pequeñas empresas, con una salvedad aparte para el uso comercial de gran volumen. Las condiciones del sitio restringen por separado el uso del sitio web para publicidad o marketing.
La política de privacidad declara la recogida de correos electrónicos y los datos de facturación custodiados por Lemon Squeezy, a los que dice que AnyToSpeech no tiene acceso directo. También describe registros con dirección IP, tipo de navegador, proveedor de internet, marcas temporales, páginas de procedencia o salida y, posiblemente, recuentos de clics. Estas declaraciones generales sobre visitantes y facturación son distintas de las promesas de herramientas de audio concretas.
Las preguntas frecuentes de clonación dicen que los datos de voz se cifran en tránsito y en reposo, que los clones son privados de la cuenta y que los datos de voz no se comparten con terceros ni se usan para entrenar modelos. Es una declaración de la empresa sobre los datos de voz de la función de clonación, no una garantía de no entrenamiento en toda la plataforma para cada documento, imagen, transcripción o episodio generado.
English Accent Test afirma que el audio se elimina inmediatamente después del análisis y que no se guardan las grabaciones de voz. La herramienta de canto dice por separado que los clips se procesan en tiempo real y se descartan, sin registro ni intercambio. Estas descripciones de eliminación se aplican a esos flujos de evaluación, no a los episodios de pódcast guardados, clones de la cuenta o la Library general.
Mostrar contenido concede a AnyToSpeech una licencia no exclusiva, mundial, irrevocable y sublicenciable para usarlo, reproducirlo, adaptarlo, publicarlo, traducirlo y distribuirlo en cualquier medio. Las condiciones definen ampliamente ese contenido como audio, vídeo, texto, imágenes y otros materiales que el usuario elige mostrar en el sitio. La licencia es una condición importante sobre derechos de contenido junto con las declaraciones de resultados y privacidad.
Los usuarios deben ser propietarios del contenido mostrado y evitar vulnerar derechos de terceros; AnyToSpeech se reserva el derecho a retirarlo sin aviso. La capacidad de estudio de voz de MCP incluye eliminar voces personalizadas que pertenezcan al usuario. Esa capacidad no fija por sí misma un periodo de conservación ni un plazo para eliminar todos los archivos relacionados, subidos o generados.
No. Podcast Studio permite a los usuarios Free preescuchar voces, mientras que generar un episodio requiere un plan de pago. Esta regla de acceso difiere de los créditos gratuitos descritos para un diálogo de varios hablantes escrito manualmente.
El producto combina la conversión de PDF a audio con una voz clonada reutilizable y presenta expresamente esa combinación para autores. La clonación de voz utiliza muestras grabadas; Voice Design crea una voz a partir de una descripción escrita.
No. MCP usa los mismos créditos de la cuenta, minutos de transcripción y límites del plan que el sitio web. Conectar un asistente cambia la entrada a las herramientas, sin añadir una suscripción de generación independiente.
