Toolso.AI
Toolso.AI
Alle ToolsKategorienIm TrendNeueste ToolsPreiseBlog
Toolso.AI
Toolso.AI

💌Abonnieren Sie AI Tools Weekly

Wöchentlich kuratierte Auswahl der neuesten und angesagtesten KI-Tools und Trends, direkt in Ihrem Posteingang Abonnieren

Toolso.AI
Toolso.AI

Entdecken Sie die besten KI-Tools, um Ihre Produktivität zu steigern

GitHubGitHubTwitterX (Twitter)YouTubeYouTubeTikTokEmail

Beliebte Kategorien

  • KI-Schreiben
  • KI-Bild
  • KI-Video
  • KI-Programmierung
  • Weitere Kategorien

Entdecken

  • Neueste Tools
  • Beliebte Tools
  • Mehr Tools
  • Tool einreichen
  • Preise

Über

  • Über uns
  • Kontakt
  • Blog
  • Änderungsprotokoll

Rechtliches

  • Cookie-Richtlinie
  • Datenschutzrichtlinie
  • Nutzungsbedingungen
  • Rückerstattungsrichtlinie
© 2026 Toolso.AI Alle Rechte vorbehalten
BefristetZeitlich begrenztHervorgehobener EintragPrüfung in 24 Std. · Kein Backlink · 30 Tage hervorgehoben$29.90danach $59.90Nach dem 31. Okt. steigt der Preis auf $59.90Endet in--:--:--Jetzt einreichen
  1. Startseite
  2. Alle Tools
  3. Open Source KI
  4. Unsloth
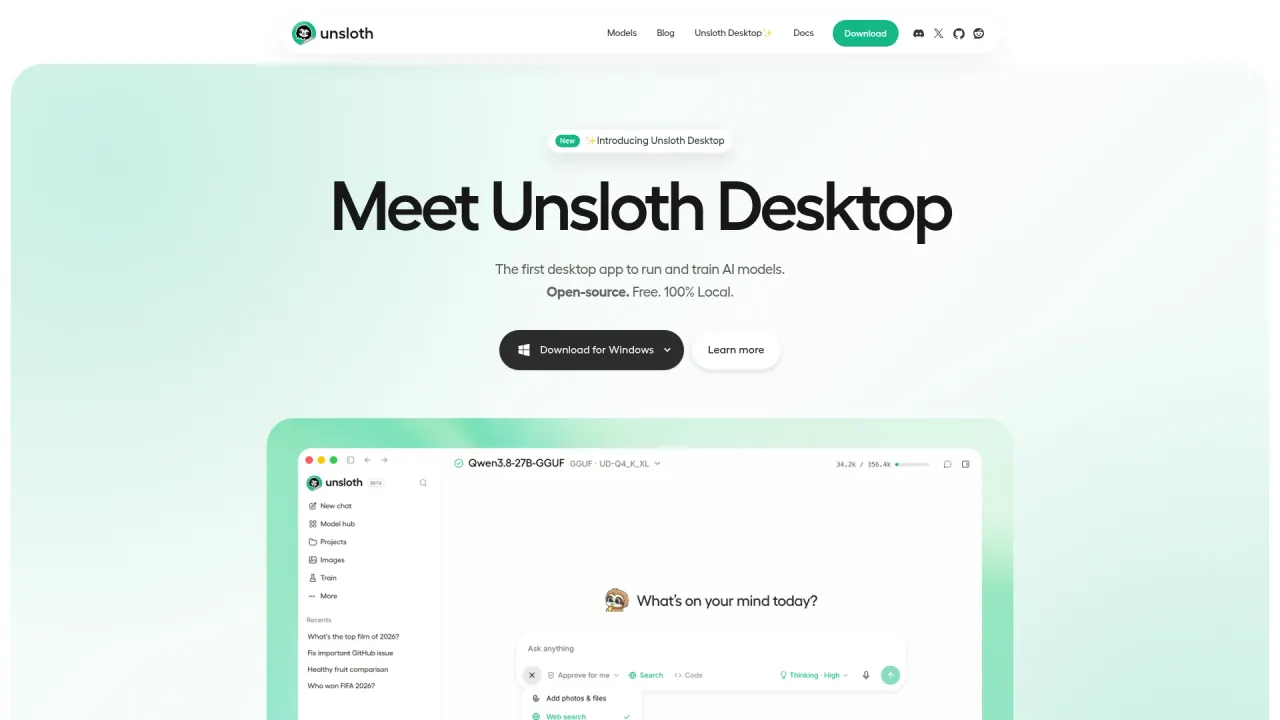
Oberflächenvorschau von Unsloth
Logo von Unsloth

Unsloth

Unsloth ist ein Open-Source-Framework, eine Desktop-App und eine Web-UI zum Fine-Tuning und Ausführen von LLMs, Diffusions-, Audio- und Embedding-Modellen auf eigener Hardware. Es umfasst No-Code-Training, LoRA, QLoRA und RL-Methoden, Datensatzerstellung und GGUF-Export.

Open Source KIKI-EntwicklungKI-Trainingsplattform#Open Source#No-Code#LLM
Kostenlos testen
Gespeichert
Besuche
Aufrufe
Preis
Kostenlos
Veröffentlicht
3. Okt. 2026
Domain
unsloth.ai
Nutzerbewertung

Hast du dieses Tool genutzt? Bewerte es

Dieses Tool bewerten

Unsloth Produktinformationen

Kostenlos testen
Tool-Informationen
Gespeichert
Besuche
Aufrufe
Preis
Kostenlos
Veröffentlicht
3. Okt. 2026
Domain
unsloth.ai
Nutzerbewertung

Hast du dieses Tool genutzt? Bewerte es

Dieses Tool bewerten

Empfohlene Tools

Verwandte Tools

Kostenlos testen

Was ist Unsloth?

Unsloth ist ein Open-Source-Framework zum Ausführen und Trainieren von LLMs, mit dem Sie KI-Modelle über eine Open-Source-Oberfläche auf Ihrer eigenen lokalen Hardware ausführen und trainieren. Es deckt Text-, Vision-, Diffusions-Bild- und -Video-, Audio- und Embedding-Modelle ab, sowohl für lokale Inferenz als auch für LLM-Fine-Tuning.

Unsloth lässt sich auf drei verschiedene Arten installieren: Unsloth Desktop als native App, Unsloth Studio als browserbasierte Web-UI oder Unsloth Core als ursprüngliches, codebasiertes Python-Paket. Desktop und Studio sind die No-Code-Oberflächen; Core ist die Bibliothek, die Entwickler aus ihren eigenen Trainingsskripten und Notebooks aufrufen.

Unsloth Desktop ist als Beta gekennzeichnet und wird als kostenlose Open-Source-App zum Ausführen und Trainieren von KI-Modellen auf eigener Hardware beschrieben, verfügbar für macOS, Windows und Linux. Unsloth Studio ist ebenfalls in der Beta und als Open-Source-No-Code-Web-UI positioniert, mit der sich offene Modelle in einer lokalen Oberfläche trainieren, ausführen und exportieren lassen. Die Startseite beschreibt Unsloth Desktop mit drei Worten: Open Source, kostenlos und 100 % lokal. Ein Porträt in der Wirtschaftspresse von 2024 berichtete, dass die Mitgründer des Unternehmens die Brüder Michael und Daniel Han seien, die damals an Y Combinator teilnahmen.

Kernfunktionen

Die zentrale Aussage von Unsloth lautet, dass es LLMs, Diffusions-, TTS- und Embedding-Modelle 2× schneller mit 70 % weniger VRAM und ohne Genauigkeitsverlust trainiert. Das ist die eigene Angabe des Anbieters; die Testbedingungen dahinter folgen unten.

Trainingsmethoden und Modellabdeckung

  • Trainingsmethoden: Unsloth unterstützt Reinforcement Learning, LoRA, QLoRA, vollständiges Fine-Tuning, Pretraining, GRPO, DPO und FP8-Training.
  • Modellumfang: Laut Unternehmen werden Inferenz und Training für 500+ Modelle unterstützt; Workflows für Vision, TTS, Embedding und RL sind separat dokumentiert.
  • No-Code-Training: In Unsloth Desktop ziehen Sie eine PDF-, CSV- oder JSON-Datei hinein und wählen LoRA, vollständiges Fine-Tuning oder Pretraining; dieselbe Seite wiederholt die Aussage „2x schneller, 70 % weniger VRAM“ und gibt an, dass Multi-GPU funktioniert.
  • Trainingsüberwachung: Unsloth Studio verfolgt Trainingsverlust, Gradientennormen und GPU-Auslastung in Echtzeit, und die Fortschrittsansicht lässt sich auf anderen Geräten wie einem Smartphone öffnen.

Benchmark-Bedingungen hinter der Geschwindigkeitsaussage

Die veröffentlichten Trainings-Benchmarks liefen auf H100- und Blackwell-GPUs mit dem Alpaca-Datensatz, einer Batchgröße von 2, 4 Gradient-Accumulation-Schritten, Rank 32 und QLoRA auf allen linearen Schichten. Gegenüber einer Baseline aus Hugging Face + FA2 nennt die Tabelle für Llama 3.3 (70B) 2x Geschwindigkeit, mehr als 75 % weniger VRAM und 13x längeren Kontext, für Llama 3.1 (8B) 2x Geschwindigkeit, mehr als 70 % weniger VRAM und 12x längeren Kontext, beides auf GPUs mit 80 GB.

Unsloth führt seine Long-Context-Ergebnisse auf seinen Gradient-Checkpointing-Algorithmus plus Apples CCE-Algorithmus zurück und sagt, je mehr Daten, desto weniger VRAM werde benötigt. Das sind Benchmarks des Anbieters, keine unabhängigen Messungen.

Modelle ausführen, Tools und Recherche

  • Selbstheilende Tool-Aufrufe: Laut Unsloth sorgen Tool-Aufrufe, die Fehler erkennen, reparieren und erneut versuchen, für bis zu 50 % genauere Tool-Aufrufe, und Modelle können Bash und Python in einer sicheren Umgebung ausführen.
  • Websuche und Deep Research: Die normale Websuche läuft, während das Modell noch nachdenkt, und Deep Research plant zuerst, sucht nach Quellen und schreibt dann einen ausführlichen Bericht mit Quellenangaben.
  • Bild- und Videogenerierung: Unsloth generiert mit Qwen-Image-2.1, FLUX, Z-Image, LTX, Wan und feinabgestimmten LoRA-Adaptern. Laut eigenem Beispiel verkürzte ein Lauf von MiniMax-H3 FP8 auf einer NVIDIA B200 eine Generierung mit 960×544, 124 Frames und 8 Schritten von über 70 Sekunden auf 13 Sekunden.
  • Neue Modelle: Unsloth sagt, es könne fast jedes Modell ausführen und trainieren, auch kommende, verspricht Day-Zero-Support für Familien wie Qwen3.8, Gemma, Meta, NVIDIA und GLM und schreibt die Grundlagenarbeit llama.cpp und Hugging Face zu.
  • Modellvergleich und Inferenz: Studio kann Modelle nebeneinander gegeneinander antreten lassen, und seine Backends für llama.cpp und Hugging Face übernehmen Multi-GPU-Inferenz, automatisches Offloading und Fitting.

Export, API und Anbieter

Unsloth Studio exportiert Modelle, auch feinabgestimmte, als safetensors oder GGUF für llama.cpp, vLLM, Ollama, LM Studio und andere Laufzeitumgebungen. Genau dieser Exportschritt bringt ein in Unsloth trainiertes Modell in andere Software.

In die andere Richtung stellt Unsloth lokale Modelle über eine OpenAI-kompatible API bereit und kann auch ein ChatGPT/Codex-Abo sowie Cloud-Anbieter anbinden. Der Befehl unsloth run stellt ein Modell bereit und ändert Einstellungen wie Kontextgröße, GPU-Layer, Threading, Sampling, Netzwerk und Tool-Konfiguration.

Anleitung

Unsloth Desktop installieren

  1. Laden Sie das Installationsprogramm für Ihr System herunter: eine .dmg-Datei für macOS, eine .exe für Windows oder eine .deb für Linux.
  2. Öffnen Sie unter macOS das .dmg-Installationsprogramm, ziehen Sie Unsloth nach Applications, starten Sie dann die App und warten Sie, bis die Installation abgeschlossen ist; unter Windows und Linux folgen Sie den Anweisungen des Installationsprogramms.
  3. Öffnen Sie das Dropdown-Menü Select model oder den Tab Model hub, wählen Sie ein Modell und eine zu Ihrem Gerät passende Quantisierung, laden Sie es herunter und beginnen Sie danach zu chatten.

Fine-Tuning-Workflow in Unsloth Studio

  1. Starten Sie Unsloth und laden Sie ein Modell aus lokalen Dateien oder einer unterstützten Integration.
  2. Importieren Sie Trainingsdaten aus PDF-, CSV- oder JSONL-Dateien oder erstellen Sie einen Datensatz von Grund auf.
  3. Bereinigen und erweitern Sie den Datensatz in Data Recipes und trainieren Sie dann mit empfohlenen Presets oder einer eigenen Konfiguration.
  4. Chatten Sie mit dem trainierten Modell, vergleichen Sie es mit dem Basismodell und speichern oder exportieren Sie es dann lokal in den Stack, den Sie bereits nutzen.

Studio kann auch eine YAML-Trainingskonfiguration importieren und die relevanten Einstellungen vorausfüllen, statt bei den Presets zu beginnen.

Fernzugriff

Standardmäßig bindet sich unsloth studio an 127.0.0.1, sodass nur der lokale Rechner darauf zugreifen kann. Die Option --secure stellt es nur über einen kostenlosen Cloudflare-HTTPS-Link bereit und startet gar nicht, wenn der Tunnel nicht aufgebaut werden kann; der rohe Port wird so nie offengelegt.

Anwendungsfälle von Unsloth

  • Lokale Coding-Agenten: Unsloth Start verbindet Claude Code, Codex und andere Agenten über den Befehl unsloth start mit lokalen Modellen, sodass ein Agenten-Workflow mit einem Modell auf Ihrer eigenen GPU laufen kann.
  • Dokumente zu Trainingsdaten machen: Data Recipes wandelt hochgeladene PDF-, CSV- und JSON-Dateien über einen Graph-Knoten-Workflow auf Basis von NVIDIA NeMo Data Designer in nutzbare oder synthetische Datensätze um, sodass ein Fine-Tuning-Datensatz von Ihren eigenen Dokumenten ausgehen kann.
  • Eigene Bildstile: Unsloth trainiert LoRA-Adapter für SDXL, FLUX.2, Qwen-Image und Z-Image auf Ihren eigenen Bildern, wobei Captioning und Rank-Auswahl in der App erfolgen; das Ergebnis lässt sich exportieren und für die Inferenz wieder laden.
  • Lokale Sprach-Workflows: Die App erledigt Generierung, Fine-Tuning oder Transkription von Audio vollständig lokal und deckt Text-to-Speech, Speech-to-Text, Whisper und Qwen3-ASR ab.
  • Fine-Tuning ohne lokale GPU ausprobieren: Ein kostenloses Google-Colab-Notebook führt Unsloth Studio auf den T4-GPUs von Colab aus; dort lassen sich die meisten Modelle bis 22B Parameter trainieren und ausführen, bevor man auf eine größere GPU wechselt.

Für wen ist es

  • Entwickler mit einer GPU: Ein unabhängiger Framework-Vergleich von 2026 empfiehlt Unsloth für eine einzelne Consumer-GPU mit unterstützter Architektur und LoRA oder QLoRA und nennt dafür den Spielraum bei der Kontextlänge.
  • Wer LLMs lokal ausführen will, ohne zu trainieren: Die Oberfläche erfordert überhaupt kein Fine-Tuning; Sie können ein beliebiges GGUF oder Modell herunterladen und unverändert nutzen.
  • Nutzer ohne dedizierte GPU: Ohne GPU funktioniert Unsloth weiterhin für Chat und Data Recipes, sodass auch ein reiner CPU-Rechner mit Modellen chatten und Datensätze erstellen kann.
  • Weniger geeignet für Teams mit Bedarf an fortgeschrittener Parallelisierung: Derselbe Vergleich sagt, dass Unsloth versagt, wenn Tensor-, Kontext- oder Expertenparallelität als vollwertige Konfiguration nötig ist und wenn ein Modell nicht auf seiner Unterstützungsliste steht, weil seine Vorteile aus architekturspezifischen Kernels stammen.

Plattformen

  • Desktop-Downloads: Unsloth Desktop gibt es als .dmg für Mac (Apple Silicon und Intel), als .exe für Windows 10 und neuer sowie als .deb für Ubuntu und kompatible Linux-Distributionen.
  • Betriebssysteme und Chips: Unsloth unterstützt Mac, Windows, Linux und WSL sowie GPUs und CPUs von NVIDIA, Intel, AMD und Mac, wobei ältere Hardware womöglich nicht gut unterstützt wird.
  • Trainingshardware für Studio: Training in Unsloth Studio funktioniert derzeit auf NVIDIA-, AMD-, MLX- und Intel-Geräten und erfordert Python 3.11–3.13; Unsloth Core kann auch auf AMD- und Intel-Geräten trainieren.
  • Windows: Studio läuft unter Windows ohne WSL, die genannten Trainingsanforderungen sind aber Windows 10 oder 11 (64 Bit) und eine NVIDIA-GPU mit installierten Treibern.
  • Unsloth Core auf NVIDIA: Core benötigt eine GPU mit CUDA Capability 7.0 oder höher, etwa V100, T4, RTX-20- und -50-Serie, A100, H100 oder L40; GTX 1070 und 1080 funktionieren, sind aber langsam.
  • Unsloth Core auf anderer Hardware: AMD- und Intel-GPUs funktionieren über eigene Anleitungen, während die Unterstützung von Apple Silicon/MLX für Core als in Arbeit beschrieben wird.
  • Docker: Ein offizielles Docker-Image funktioniert für Unsloth; an der Mac-Kompatibilität wird noch gearbeitet.
  • Bereitstellung im lokalen Netz: Die Bereitstellung über LAN hält den Datenverkehr in Ihrem Netzwerk und funktioniert ohne Internetverbindung; Fernzugriff läuft über den in der Anleitung beschriebenen Cloudflare-Tunnel.

Preise

PlanAngegebener PreisGeschwindigkeitsgewinnVRAM-ReduktionGPU-Unterstützung
FreeKostenlos2x60 %Einzeln
Unsloth ProNicht angezeigt (Contact us)2,5x Anzahl GPUs80 %Multi
Unsloth EnterpriseNicht angezeigt (Contact us)32x Anzahl GPUs90 %Multi + Node

Unsloth Pro wird mit 2,5x schnellerem Training, 20 % weniger VRAM und Unterstützung für bis zu 8 GPUs beworben, Unsloth Enterprise mit 30x schnellerem Training, Multi-Node-Unterstützung und 30 % Genauigkeit, doch beide zeigen nur eine Schaltfläche Contact us, sodass für keinen ein öffentlicher Preis angezeigt wird. Enterprise listet zusätzlich bis zu +30 % Genauigkeit, 5x schnellere Inferenz, vollständiges Training, alle Pro-Funktionen, Multi-Node-Unterstützung und Kundensupport.

Die Plankarten lesen sich anders als die Dokumentation. Die Free-Karte beschreibt sich als Freeware der Standardversion von Unsloth, kennzeichnet sie als Open Source, nennt Unterstützung für Mistral, Gemma und Llama 1, 2, 3 und führt MultiGPU weiterhin als demnächst verfügbar (coming soon). Die Tabelle der Planunterschiede bewertet die Free-Stufe mit 2x Geschwindigkeitsgewinn und 60 % VRAM-Reduktion, was von der in der Dokumentation durchgängig verwendeten Angabe „2× schneller, 70 % weniger VRAM“ abweicht.

Zur Bedeutung von „kostenlos“ gehört hier auch die Lizenz. Unsloth nutzt ein Dual-Licensing-Modell: Das Kernpaket von Unsloth bleibt Apache 2.0, während bestimmte optionale Komponenten wie die Unsloth Studio UI unter AGPL-3.0 stehen. Laut Unternehmen hilft diese Struktur, die laufende Entwicklung zu unterstützen und das Projekt zugleich Open Source zu halten.

Alternativen zu Unsloth

Ein unabhängiger Vergleich von Open-Source-Fine-Tuning-Frameworks aus 2026 stellt Unsloth drei anderen Projekten gegenüber und weist jedem eine andere Aufgabe zu:

  • Axolotl: Der Vergleich verweist Teams mit zwei bis acht GPUs, langem Kontext, vollständigem Fine-Tuning oder RLHF-Pipelines auf Axolotl und nennt FSDP2 plus Sequenzparallelität den am besten dokumentierten Weg.
  • LLaMA-Factory: Es ist die empfohlene Wahl für die breiteste Modellabdeckung, Bediener ohne Engineering-Hintergrund und den schnellsten ersten Lauf, mit Wechsel zur CLI beim Skalieren.
  • TRL: Eigene Trainingsschleifen, neue Post-Training-Algorithmen und enge Kopplung an Hugging Face sprechen für TRL, das als die Schicht beschrieben wird, die die anderen Frameworks umhüllen.

Diese Optionen schließen sich nicht aus: LLaMA-Factory kann Unsloth als Backend nutzen, TRL liefert eine Unsloth-Integration mit, und Axolotl ruft intern TRL-Trainer auf. Wer LLaMA-Factory oder TRL wählt, kann darunter also trotzdem Unsloth laufen haben.

Einschränkungen

Reife und Skalierung

  • Multi-GPU-Einrichtung: Unsloths eigene Multi-GPU-Anleitung sagt, der Prozess könne komplex sein und erfordere manuelle Einrichtung; offizielle Multi-GPU-Unterstützung soll erst noch angekündigt werden.
  • Unabhängige Sicht: Ein unabhängiger Vergleich von 2026 kommt zu dem Schluss, dass Unsloth bei Single-GPU-Geschwindigkeit und Kontextlänge vorn liegt, Multi-GPU aber seine dokumentierte Schwachstelle bleibt.
  • Neue Architekturen: Unsloth funktioniert mit jedem von transformers unterstützten Modell, doch manche neueren Modelle brauchen wegen seiner Optimierungen eventuell eine kleine manuelle Anpassung.

Hinweise zu Hardware und Leistung

  • VRAM-Untergrenzen: Die VRAM-Bedarfstabelle nennt absolute Mindestwerte, und manche Modelle brauchen mehr. Für ein 8B-Modell listet sie 6 GB mit QLoRA (4-Bit) und 22 GB mit LoRA (16-Bit).
  • Studio nur mit CPU: Auf reinen CPU-Geräten unterstützt Studio Chat für GGUF-Modelle und Data Recipes; Export wird als sehr bald verfügbar beschrieben.
  • Inferenzgeschwindigkeit: Websuche, Codeausführung und Tool-Call-Healing verlangsamen die Inferenz; sind sie ausgeschaltet, sollte die Geschwindigkeit der anderer llama.cpp-Apps entsprechen.
  • Aufwärmzeit: Training kann anfangs langsamer wirken, weil torch.compile typischerweise etwa 5 Minuten oder länger zum Aufwärmen und Kompilieren braucht.
  • Exportierte Modelle: Liefert ein Modell, das in Unsloth funktioniert hat, in Ollama, vLLM oder einer anderen Laufzeitumgebung schlechte, unsinnige oder sich wiederholende Ausgaben, ist die häufigste Ursache ein falsches Chat-Template; das beim Training verwendete Template muss auch dort genutzt werden.

Datenschutz, Sicherheit und Lizenzen

  • Telemetrie: Unsloth Desktop gibt an, keine Telemetrie zu haben; es erkennt Ihren GPU-Typ und Ihr Gerät für die Kompatibilität und kann vollständig offline laufen.
  • Zugriffskontrolle in Studio: Unsloth Studio lässt sich vollständig offline nutzen und verwendet tokenbasierte Authentifizierung mit verschlüsselten Passwörtern sowie JWT-Access- und Refresh-Abläufen.
  • Tool-Berechtigungen: Dank Berechtigungskontrollen können das Modell und Unsloth ohne Ihre Zustimmung weder auf Ihre Dateien zugreifen, sie ändern oder bearbeiten noch das Internet nutzen.
  • Exponierte Server: Serverseitige Tools (Websuche, Python- und Terminal-Codeausführung) laufen unter Ihrem Benutzer und sind standardmäßig aktiv, sodass jeder, der den Server mit dem API-Schlüssel erreicht, Code auf dem Rechner ausführen kann; die Dokumentation verbindet das Exponieren mit dem Flag --disable-tools.
  • Lizenzaufteilung: Die LICENSE des Repositorys stellt die Kernbibliothek, Tests und Skripte unter Apache 2.0, während die optional installierbaren Ordner für Studio und CLI unter AGPLv3 lizenziert sind (studio/* und unsloth_cli/*).

FAQ

Q1. Ist Unsloth kostenlos?

Unsloth Desktop wird als kostenlose Open-Source-App beschrieben, und der Free-Plan ist die Standardversion. Unsloth Pro und Unsloth Enterprise gibt es auch, doch die Preisseite zeigt Contact us statt eines Preises.

Q2. Brauche ich eine NVIDIA-GPU?

Nicht für jede Aufgabe. Chat und Data Recipes laufen auf der CPU, und das Training in Studio unterstützt NVIDIA-, AMD-, MLX- und Intel-Geräte. Für Training unter Windows wird eine NVIDIA-GPU als Voraussetzung aufgeführt.

Q3. Kann Unsloth bereits heruntergeladene Modelle nutzen?

Ja. Bereits heruntergeladene Modelle werden automatisch gefunden, und Sie können eigene Ordner angeben, falls Ihre nicht erkannt werden.

Q4. Kann ein in Unsloth trainiertes Modell in Ollama oder LM Studio laufen?

Ja. Unsloth exportiert als GGUF oder safetensors für Laufzeitumgebungen wie llama.cpp, Ollama, vLLM und LM Studio, sofern das Chat-Template dem beim Training verwendeten entspricht.

Q5. Welche Lizenz gilt für Unsloth?

Das Kernpaket steht unter Apache 2.0, während optionale Komponenten wie die Unsloth Studio UI unter AGPL-3.0 stehen.

Kennen Sie ein ähnliches Tool?
Wenn Sie andere großartige KI-Tools kennen, können Sie sie uns gerne einreichen