TTSMaker wandelt eingefügten Text im Browser in MP3 oder WAV um, mit über 600 KI-Stimmen in mehr als 100 Sprachen, einem wöchentlichen Gratiskontingent und kommerziellen Rechten ohne Namensnennung.
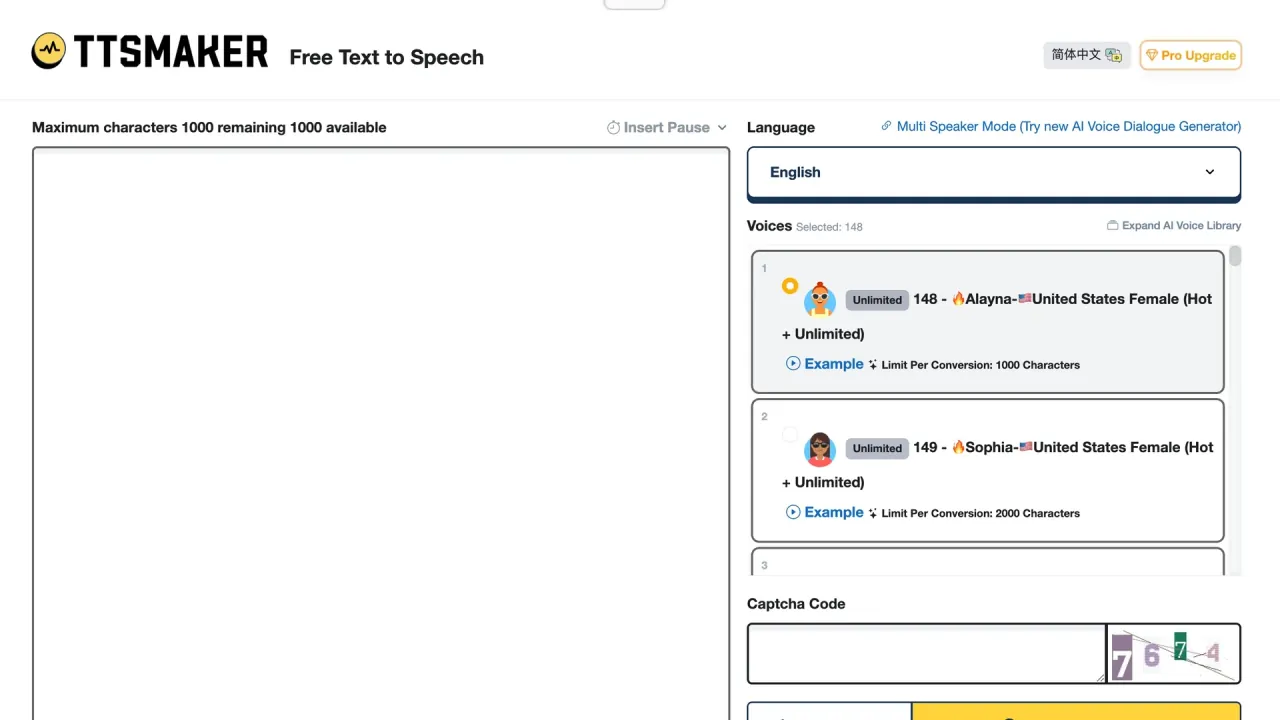
TTSMaker ist ein kostenloser Text-zu-Sprache-Dienst, der komplett im Browser läuft: eingefügter Text wird zu einer Audiodatei, die sich anhören oder herunterladen lässt. Es gibt zwei Zugänge — den offenen Konverter auf ttsmaker.com, der ohne Konto funktioniert, und TTSMaker Pro auf pro.ttsmaker.com mit bezahlten Zeichenkontingenten, einem Dialogeditor für mehrere Stimmen und einer API.
Das Produkt ist ein Konverter, kein Audiostudio. Text rein, MP3 oder WAV raus; eine Schnittzeitleiste oder einen Einstieg für Voice Cloning gab es auf keiner für diese Seite geprüften Seite. Die Selbstbeschreibung des Anbieters nennt es ein kostenloses Text-zu-Sprache-Werkzeug, das Sprachsynthese anbietet und mehrere Sprachen unterstützt; die FAQ der Website beschreibt dasselbe als KI-Stimmengenerator.
Zwei Punkte trennen es von den meisten kostenlosen Angeboten dieser Kategorie. Der Gratisplan ist keine Testphase: Der Anbieter kündigt eine dauerhaft kostenlose Version für Nutzer an und behält sich zugleich vor, die zugehörigen Richtlinien künftig anzupassen. Und kommerzielle Rechte kommen mit der kostenlosen Ausgabe statt mit einem Upgrade — die veröffentlichte Lizenz gewährt ein nicht exklusives, unwiderrufliches, weltweites und dauerhaftes Nutzungsrecht an den erzeugten Audiodateien.
Der Preis dafür liegt auf der anderen Seite: Dateien werden binnen Minuten gelöscht, und die Gratisstufe bringt Captchas und Werbung mit.
Der Katalog wird mit über 600 KI-Stimmen in mehr als 100 Sprachen beworben. Das Detail, das die meisten Einträge auslassen: Die Obergrenze einer einzelnen Umwandlung gilt je Stimme, nicht je Konto. In der Stimmliste stehen Einträge mit Limit Per Conversion: 20000 characters neben anderen mit Limit Per Conversion: 300 characters. Wer eine Stimme wählt, wählt damit auch, wie viel Text in einem Durchgang passt.
Eine zweite Ebene innerhalb der Bibliothek sind die als unlimited markierten Stimmen. Jeder Tarif, auch der kostenlose, nennt über 20 unlimited-Stimmen, deren Ausgabe das wöchentliche Zeichenkontingent nicht verbraucht. Das ist allerdings eine Richtlinie und keine Zusage: Der Anbieter behält sich vor, die Zahl der Stimmen, deren Verfügbarkeit (Hinzufügen oder Entfernen von Stimmen) und die Synthesegeschwindigkeit anzupassen.
Audio lässt sich als MP3, OGG, AAC, OPUS oder WAV exportieren, MP3 zusätzlich in Standard- und hoher Qualität; bei hoher Qualität verdoppelt sich die Größe der konvertierten Audiodatei üblicherweise. Zwei Extras sind in dieser Preisklasse ungewöhnlich: Der Konverter erzeugt eine zeitcodierte Untertiteldatei zum eben produzierten Audio, und Hintergrundmusik lässt sich unter die Sprachspur legen — in der Gratisversion bis zu 3 BGM-Dateien, die nach 6 Stunden ablaufen, gegenüber 20 Uploads in den bezahlten Tarifen. Ein reiner Anhörmodus wandelt nur die ersten 50 Zeichen um, damit sich eine Stimme günstig prüfen lässt.
Ein eigener Dialogeditor baut Gespräche aus Blöcken, jeder mit eigener Sprache und Stimme, wandelt den Text jedes Blocks in Sprache um und fügt alle Blöcke zu einer einzigen Audiodatei zusammen. Die Gratisgrenze ist eng: bis zu 5 Dialogblöcke, 200 Zeichen je Block und höchstens 5 erzeugte Dialoge pro Woche. Bezahlte Konten öffnen das auf 300 Dialogprojekte mit je bis zu 100 Blöcken, und die Gratisversion hat dafür keine Speicherfunktion.
Pausenmarken im Text sind zuverlässiger als nachträglich eingefügte Stille; sie zählen in Millisekunden, und die API bietet denselben Mechanismus als Parameter im Bereich 0-10000 ms mit Standardwert 0.
Die v2-API hat zwei zentrale Aufrufe: Einer liefert die Stimmliste mit IDs und Zeichengrenzen je Stimme, der andere erstellt einen Umwandlungsauftrag und gibt statt der Audiodatei eine URL auf eine temporäre Datei zurück, die nach 2 Stunden gelöscht wird. Der Download gehört deshalb in denselben Job wie der Auftrag.
Die Szenarienliste des Anbieters dreht sich um drei Aufgaben, die jeweils auf eine konkrete Produktgrenze treffen:
Entwickler ergänzen ein viertes Muster: Python-Wrapper von Dritten auf einer öffentlichen Code-Hosting-Plattform, von denen sich einer als Python-Bibliothek zur Interaktion mit der TTSMaker-API zur Umwandlung von Text in Sprache beschreibt.
Gut geeignet, wenn Sie:
Schlecht geeignet, wenn Sie:
Eine Unstimmigkeit zählt beim Entwickeln: Dieselbe Dokumentationsseite schreibt, die temporäre URL sei 24 Stunden gültig, und weiter unten, die Datei werde nach zwei Stunden gelöscht. Planen Sie mit dem kürzeren Wert.
Abgerechnet werden Zeichen, nicht Minuten, weil die Audiolänge von Sprache, Stimme und Tempoeinstellung abhängt. Die Spanne, die über den nötigen Tarif entscheidet: 300,000 Zeichen ergeben etwa 6.9 Stunden englisches Audio, 4.3 Stunden auf Spanisch und wegen der Sprachunterschiede über 14 Stunden auf Chinesisch. Die Tarifübersicht wurde im Zustand jährlicher Abrechnung erfasst; der Reiter für monatliche Abrechnung wurde dabei nicht dargestellt, daher sind unten nur die Jahreswerte bestätigt.
| Tarif | Jährliche Abrechnung | Zeichenkontingent | Maximum je Umwandlung |
|---|---|---|---|
| Free | Kostenlos | 20,000 pro Woche | 500 |
| Lite | $119.88 pro Jahr, $36 gespart | 300,000 pro Monat | 10,000 |
| Pro Mini | $227.88 pro Jahr, $60 gespart | 600,000 pro Monat | 20,000 |
| Pro Max | $299.88 pro Jahr, $96 gespart | 1,200,000 pro Monat | 20,000 |
| Studio | $1296 pro Jahr, $384 gespart | 6,000,000 pro Monat | 30,000 |
Die Stufen unterscheiden sich außerdem bei Werbung und Captchas, der Zahl der Pauseneinfügungen, Hosting- und Hintergrundmusikplätzen, der Rechnungsstellung sowie bei den E-Mail-Reaktionszielen, die sich von 72h bei Lite auf 24h bei Studio verkürzen. Der API-Zugang beginnt bei Pro Mini, Zusatzpakete mit Zeichen werden Abonnenten separat verkauft.
Der nützlichste Vergleich kommt von außerhalb des Anbieters. Eine unabhängige redaktionelle Übersicht zu KI-Stimmengeneratoren kürte TTSMaker zur Gratisempfehlung und führte dafür an, dass kommerzielle Nutzung auch bei den kostenlosen Stimmen erlaubt ist und mehr als 600 Stimmen in 100 Sprachen bereitstehen, von denen 20 unbegrenzt kostenlos nutzbar sind — im selben Eintrag urteilt sie, die Oberfläche wirke im Vergleich zu ElevenLabs oder Speechify schlicht. Es gewinnt bei Rechten und Preis und verliert beim Feinschliff.
Drei Situationen sprechen für ein anderes Werkzeug: wenn die Stimme selbst das Ergebnis ist und wie eine Darbietung bewertet wird; wenn Voice Cloning gebraucht wird, das keine hier geprüfte Seite anbietet; und wenn eine Pipeline dauerhaft gehostete Assets statt eines ablaufenden Links braucht.
Eine Warnung beim Vergleichen: Verzeichnisse für KI-Werkzeuge führen hier veraltete Zahlen, eines nennt weiterhin über 200 KI-Stimmen, was der aktuellen offiziellen Tarifübersicht widerspricht.
Das ist die wichtigste betriebliche Einschränkung, und drei offizielle Seiten nennen drei verschiedene Zahlen:
Die Zeilen der Tarifübersicht passen zu einer Unterscheidung nach Tarif — 30 Minuten Verlauf gratis, 24h bezahlt — doch Lizenz- und Datenschutztexte sind nicht so eingegrenzt, sodass die Abweichung offen bleibt. In jedem Fall gilt dieselbe sichere Gewohnheit: Audio und Untertiteldatei sofort nach der Umwandlung herunterladen.
Minuten, nicht Tage. Die veröffentlichten Werte widersprechen sich — 30 Minuten in der Lizenz, 60 Minuten in der Pro-Datenschutzerklärung, 24 Stunden in den Bedingungen — und alle sind kurz genug, dass sofortiges Herunterladen die einzig sichere Gewohnheit bleibt. Eine unabhängige Rezension warnt ebenso, dass TTSMaker Ihre Dateien nur 30 Minuten speichert und sie dann löscht.
Nein. Der API-Zugang verlangt ein Pro- oder Studio-Abonnement, einen Schlüssel je Konto und eine Anfrage pro Sekunde. Free- und Lite-Konten haben keinerlei API-Unterstützung.
Kündigen lässt sich jederzeit, der Zugang bleibt bis zum Ende des Abrechnungszyklus. Die Erstattung ist enger gefasst: innerhalb von 30 Tagen, wenn keine Zeichen verbraucht wurden, innerhalb von 7 Tagen nach Abbuchung, wenn weniger als 500 verbraucht wurden, keine Teilerstattung und nur eine Erstattung je Konto, bevor Käufe gesperrt werden.
