Replicate ist eine Cloud-Plattform, die KI-Modelle hinter einer einzigen HTTP-API ausführt, feinabstimmt und hostet. Die meisten Modelle werden pro GPU-Sekunde abgerechnet, offizielle Modelle pro Ausgabe, und Guthaben wird im Voraus gekauft.
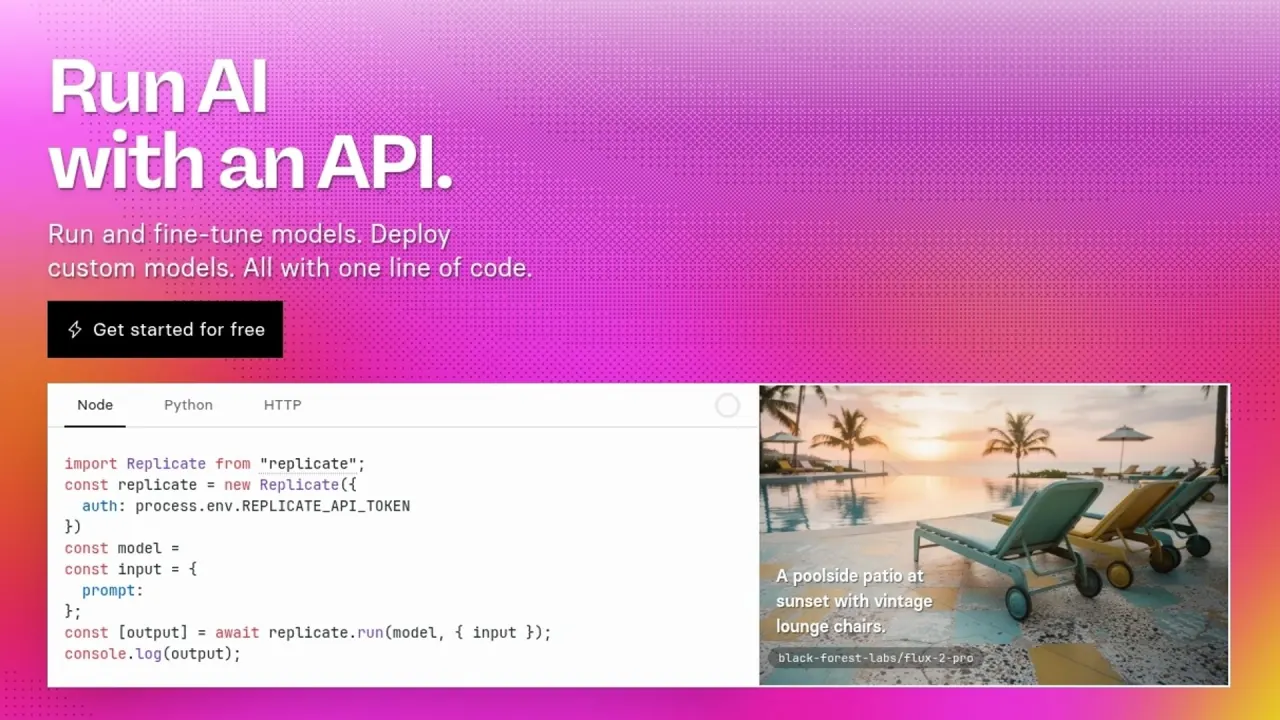
Replicate lässt Sie KI-Modelle über eine Cloud-API ausführen, ohne maschinelles Lernen zu verstehen oder eigene Infrastruktur zu betreiben. Eine HTTP-Anfrage schickt eine Eingabe an ein Bild-, Video-, Audio- oder Sprachmodell und liefert das Ergebnis zurück: keine GPU zu mieten, kein Container zu bauen. Im Kern ist es eine KI-Modell-API.
Hinter dieser Schnittstelle stecken drei Aufgaben: ein von anderen veröffentlichtes Modell ausführen, eines mit eigenen Daten feinabstimmen und selbst verpackten Code bereitstellen. Jede davon ist mit einer Zeile Code erreichbar.
Betreiber ist Replicate, LLC., 101 Townsend Street in San Francisco. Am 17. November 2025 wechselte der Eigentümer: „die führende Plattform zum Ausführen von KI-Modellen“ gab bekannt, sich Cloudflare anzuschließen. Die Produktoberfläche war davon ausdrücklich ausgenommen — der Anbieter erklärt, die API ändere sich nicht und die heute genutzten Modelle liefen weiter; der Käufer sagte dasselbe zu: APIs und Workflows bestehender Nutzer laufen ohne Unterbrechung weiter. Auch die Entwicklung stoppte nicht: Der jüngste Changelog-Eintrag ergänzt Markdown-Anweisungsdateien, die Coding-Assistenten Expertenwissen über den Umgang mit KI-Modellen auf dieser Plattform geben.
Die Katalogzahl stammt auf beiden Seiten vom Anbieter: Die Übernahmemitteilung nennt mehr als 50.000 Open-Source- und feinabgestimmte Modelle; eine unabhängige Zählung tauchte in den geprüften Kanälen dieser Runde nicht auf.
Hinter einer API stehen vier Objekte, die sich bei Latenz und Kosten unterschiedlich verhalten:
„Ein Modell auf der Plattform“ ist deshalb kein einheitliches Leistungsprofil: Offizielle Modelle sind stets warm und antwortbereit, lassen sich also ohne Sorge vor Kaltstarts ausführen, während ein selten genutztes Community-Modell zuerst von Grund auf geladen wird.
Die Kapazität bewegt sich ohne Konfiguration in beide Richtungen: Bei viel Verkehr skaliert die Plattform automatisch hoch, im Leerlauf wieder auf null. Ist diese Voreinstellung zu locker, erlaubt die Deployment-Funktion unter anderem, Hardware und Skalierungsparameter jedes Modells selbst zu steuern. Für Teams teilen Organisationen (organization) den Zugriff auf Modelle, API-Token, Abrechnung und Dashboards.
Der voreingestellte Sicherheitsfilter greift enger, als der Name vermuten lässt: Für Vorhersagen über das Web wird der Safety Checker nur beim SDXL-Basismodell, beim Flux-Basismodell und bei allen davon abgeleiteten Feinabstimmungen aktiviert. Es gibt zudem einen Ausweg — beim Ausführen über die API lässt sich der Safety Checker deaktivieren — womit der API-Pfad ohne garantierten Filter bleibt.
Die erste Integration ist kurz, doch zwei dieser Schritte sind jetzt billig und später teuer.
Die dokumentierten Fähigkeiten decken ein eher enges Aufgabenfeld ab.
Dieselben Fakten ziehen die Grenze: garantierte Antwortzeit, ein Lauf über dreißig Minuten oder Ausgaben, die zum späteren Abruf auf der Plattform liegen bleiben, fallen aus dem dokumentierten Rahmen eines Standardkontos.
Es passt zu Softwareteams, die serverlose GPU-Inferenz wollen, ohne den Machine-Learning-Stack selbst zu besitzen, und die eine schwankende Rechnung leichter verkraften als den Betrieb eigener Cluster. Es passt ebenso zu Modellautoren, denn Veröffentlichen und Feinabstimmen sind hier erstklassige Operationen.
Vier Situationen passen schlecht, und jede lässt sich auf eine veröffentlichte Klausel zurückführen:
Alles ist über HTTP erreichbar. Die hauseigenen Clients decken Node.js, Python, Swift und Go ab, dazu kommt ein gehosteter MCP-Client; andere Ökosysteme wie Elixir werden von Beitragenden gepflegt, nicht vom Anbieter, was den erwartbaren Support verändert.
Es gibt auch einen Browser-Weg, und der ist der schnellste, um die Eingabefelder eines Modells vor dem Schreiben von Code anzusehen.
Replicate Preise kennen keine Tarifstufen. Sie zahlen nur, was Sie verbrauchen: Manche Modelle werden nach Hardware und Zeit abgerechnet, andere nach Ein- und Ausgabe. Welcher Zähler gilt, ist eine Eigenschaft des Modells, nicht Ihres Kontos. Beim Zeitzähler folgt der Preis der Hardware:
| Hardware | Pro Sekunde | Pro Stunde |
|---|---|---|
| Nvidia T4 | $0.000225 | $0.81 |
| Nvidia L40S | $0.000975 | $3.51 |
| Nvidia A100 (80 GB) | $0.001400 | $5.04 |
| Nvidia H100 | $0.001525 | $5.49 |
Das sind Preise pro Laufzeitsekunde, nicht pro Anfrage: Die meisten Modelle werden nach der Zeit abgerechnet, die sie zum Laufen brauchen, und der Sekundenpreis richtet sich nach der genutzten Hardware, weshalb derselbe Prompt auf einem schwereren Modell mehr kostet. Der Ausgabezähler arbeitet umgekehrt: Offizielle Modelle werden nach vorhersehbaren Größen wie erzeugten Bildern, Sekunden Videoausgabe oder Ein- und Ausgabetoken bepreist, mit veröffentlichten Beispielen von $0.04 pro erzeugtem Bild bis $3.75 pro Million Eingabetoken. Nur dort lässt sich ein Budget pro Anfrage vorab berechnen, und die höchsten Stufen sind gar nicht Selbstbedienung: zusätzliche Multi-GPU-H100-Kapazität gibt es nur mit Abnahmeverpflichtung.
Kaltstarts sind auf geteilter Kapazität ein Latenzproblem und auf dedizierter Kapazität ein Abrechnungsproblem. Auf der geteilten Seite zahlen Sie bei einem öffentlichen Modell nur die Zeit, in der es Ihre Anfragen aktiv verarbeitet; Einrichtungs- und Leerlaufzeit des Modells sind kostenlos. Das Warten bleibt trotzdem real: In manchen Fällen dauert dieser Vorgang mehrere Minuten. Es liegt auch nicht ganz in Ihrer Hand, denn standardmäßig teilen Sie sich einen Hardware-Pool mit anderen Kunden, und Ihre Anfragen landen in einer gemeinsamen Warteschlange.
Das Warten zu beseitigen verschiebt den Zähler. Auf dedizierter Kapazität zahlen Sie die gesamte Zeit, in der Instanzen des Modells online sind: die Zeit für das Hochfahren, die Leerlaufzeit beim Warten auf Anfragen und die aktive Verarbeitungszeit. Schnell startende Feinabstimmungen sind die Ausnahme und werden nur für die aktive Verarbeitungszeit berechnet, ob öffentlich oder privat.
Kostenloser Zugang existiert, ist aber begrenzt und unbeziffert. Ausgewählte Modelle laufen gratis, bis Sie nach einer Weile zur Einrichtung der Abrechnung aufgefordert werden — ohne Betrag, Modellliste oder Laufzeit. Nicht aufgeladene Konten werden zusätzlich gedrosselt: Wurde Ihnen Guthaben gewährt, ohne dass eine Zahlungsmethode hinterlegt ist, gilt eine Grenze von 1 Anfrage pro Sekunde und höchstens 6 Anfragen pro Minute.
Der bezahlte Zugang ist vorausbezahlt und verfällt. Gekauftes Guthaben ist ab Kaufdatum 1 Jahr gültig und außerhalb gesetzlicher Vorgaben nicht erstattungsfähig; der Vertrag wiederholt die Verfallsregel: Jede Zahlung auf das Prepaid-Guthaben verfällt am Ende des zwölften Monats nach dem Zahlungsdatum, wenn sie nicht vollständig verbraucht wurde. Die automatische Aufladung hat Untergrenzen — Mindestschwelle $5, Mindestaufladebetrag $15 — und sobald der Kontostand null erreicht, wird neue Arbeit blockiert und laufende Infrastruktur abgeschaltet.
Enterprise-Konditionen werden verhandelt, nicht veröffentlicht: fester Ansprechpartner, bevorzugter Support, höhere GPU-Limits und Performance-SLAs, dazu Mengenrabatte an eine Abnahmeverpflichtung gekoppelt.
Zwei Fakten erledigen den Großteil des Vergleichs. Der erste ist Breite: Enterprise-Nutzer erhalten über eine API und einen Vertrag Zugang zu mehr als 50.000 Modellen, was etwas anderes ist als ein auf eine Modalität getrimmter Dienst. Der zweite ist, dass die günstigste Konfiguration die geteilte ist — dort begegnen Ihnen je nach Nutzung durch andere Kunden gelegentlich Kaltstarts oder Skalierungsgrenzen.
Unabhängige Quellen benennen das Feld, statt es zu ranken. Ein namentlich gezeichneter Technikbericht zum Start des Unternehmens im Februar 2023 beschrieb einen vollen Markt: Das Start-up konkurriert mit Anbietern wie Hugging Face und OctoML und in gewissem Maße Runway ML, die zusammen Hunderte Millionen Dollar eingesammelt haben. Eine öffentliche Entwicklerdiskussion brachte später eine längere Praktikerliste hervor — wie viele Akteure gibt es in diesem Feld? Replicate, RunPod, Modal, Northflank, FAL.
Drei Fragen trennen sie in der Praxis: Veröffentlicht der Anbieter einen Hardwarepreis pro Sekunde oder nur einen Preis pro Ausgabe? Berechnet er Leerlaufzeit, sobald Instanzen fixiert sind? Und behält er Ihre Ausgaben oder löscht er sie per Zeitschaltung? Kein unabhängiger Benchmark erreichte in dieser Runde die Quellenschwelle: Die gefundenen Vergleichsseiten stammten von konkurrierenden Plattformen oder von provisionsgetriebenen Aggregatoren.
Dokumentation und Vertrag sagen Unterschiedliches über fehlgeschlagene Arbeit. Die Abrechnungsdokumentation hält fest, dass ein fehlgeschlagener Lauf bei keinem Modell berechnet wird, während das Abbrechen eines Laufs bei einem offiziellen Modell dennoch in Rechnung gestellt werden kann. Die Bedingungen sagen das Gegenteil: Teilläufe und fehlgeschlagene Versuche sind abrechenbar, je nach dem in den Logs des Anbieters festgehaltenen genauen Fehlerpunkt. Eine dritte Regel betrifft verkettete Modelle: Scheitert das Modell, werden die Laufzeit sowie die Kosten der vor dem Fehler aufgerufenen nachgelagerten Modelle berechnet. Diese Seiten sind untereinander widersprüchlich, und eben jene Logs sind der Nachweis zur Beilegung von Abrechnungsstreitigkeiten — eine fehleranfällige Last braucht die geltende Regel also schriftlich.
Im Selbstbedienungstarif ist nichts vertraglich festgezurrt. Der Anbieter behält sich das Recht vor, nach eigenem Ermessen jederzeit Änderungen am Dienst vorzunehmen, auch durch Beschränken oder Einstellen einzelner Funktionen, vorübergehend oder dauerhaft und ohne Vorankündigung. Ohne Verfügbarkeitszusage kann ein Modell, von dem Ihr Produkt abhängt, ohne Ankündigung verschwinden — also Versionen festnageln und einen Ausweichpfad behalten. Auch die Streitbeilegung ist eingegrenzt: Es gilt das Recht des Bundesstaates Kalifornien, und Sammelschiedsverfahren sind nicht zulässig.
Eine einheitliche Schnittstelle verdeckt uneinheitliche Lizenzen: Sie dürfen Machine-Learning-Modelle nicht entgegen den Open-Source-Lizenzbeschränkungen ihres Eigentümers nutzen. Permissive Lizenzen, reine Forschungsnutzung und proprietäre Bedingungen liegen hinter demselben Aufruf.
Die Aufbewahrung ist asymmetrisch. Über die API erzeugte Vorhersagen werden nach einer Stunde gelöscht, während Daten von Vorhersagen aus der Weboberfläche unbefristet aufbewahrt werden — die Historie sammelt also der Browser-Pfad an. Die Überwachung ist ausdrücklich geregelt: Der Anbieter behält sich vor, Ihre Nutzung des Dienstes auf Einhaltung dieser Richtlinie zu überwachen, einschließlich automatisierter und manueller Prüfungen von Inhalten und Aktivitäten. Die Datenschutzerklärung warnt gesondert, dass hochgeladene Trainingsdaten jede Art von Informationen enthalten können, von denen einige nach verschiedenen Datenschutzgesetzen als „sensibel“ gelten könnten.
Die Rechte an Ausgaben sind weit, aber bedingt. Der Anbieter überträgt Ihnen sämtliche etwaigen Rechte, Titel und Ansprüche an der Ausgabe, einschließlich kommerzieller Nutzung wie Verkauf oder Veröffentlichung, vorbehaltlich geltender Drittbedingungen — dieser Vorbehalt ist die Lizenz des Modells, das die Ausgabe erzeugt hat. Im Gegenzug lizenzieren Sie Ihre Eingaben in dem Umfang, der nötig ist, um die Ausgabe bereitzustellen, kundenabgeleitete Modelle zu trainieren und zu erzeugen, den Dienst gemäß den Bedingungen zu erbringen sowie Resultant Data zu erstellen und zusammenzustellen. Ob diese Eingaben die eigenen Modelle des Anbieters trainieren, sagen die veröffentlichten Richtlinien weder so noch so.
Die Plattform erklärt, personenbezogene Daten im Sinne US-bundesstaatlicher Datenschutzgesetze weder zu „verkaufen“ noch zu „teilen“, und die Richtlinie hält fest, dass personenbezogene Daten von Kindern unter 16 Jahren nicht absichtlich erhoben werden.
Es gibt ein begrenztes Gratiskontingent, keinen Gratistarif: Ausgewählte Modelle laufen kostenlos, bis Sie zur Einrichtung der Abrechnung aufgefordert werden, und weder Kontingent noch Laufzeit noch Modellliste sind veröffentlicht. Ohne hinterlegte Zahlungsmethode ist der Durchsatz auf eine Anfrage pro Sekunde gedeckelt.
Bei öffentlichen Modellen nicht, dort sind Einrichtungs- und Leerlaufzeit kostenlos. Sobald Sie Kapazität fixieren, ändert sich das: Dedizierte Instanzen und Deployments berechnen auch Einrichtungs- und Leerlaufzeit.
Ja. Guthaben ist ab Kaufdatum ein Jahr gültig, und der Vertrag hält fest, dass jede Zahlung am Ende des zwölften Monats nach der Zahlung verfällt, wenn sie nicht vollständig verbraucht wurde. Prepaid-Guthaben ist nicht erstattungsfähig, außer wenn das Gesetz es verlangt oder der Vertrag es ausdrücklich vorsieht.
Über die API standardmäßig nicht: Eingaben, Ausgaben, Dateien und Logs werden nach einer Stunde entfernt, alles Nötige müssen Sie selbst herauskopieren. Nur im Browser erzeugte Vorhersagen bleiben, bis Sie sie löschen.
