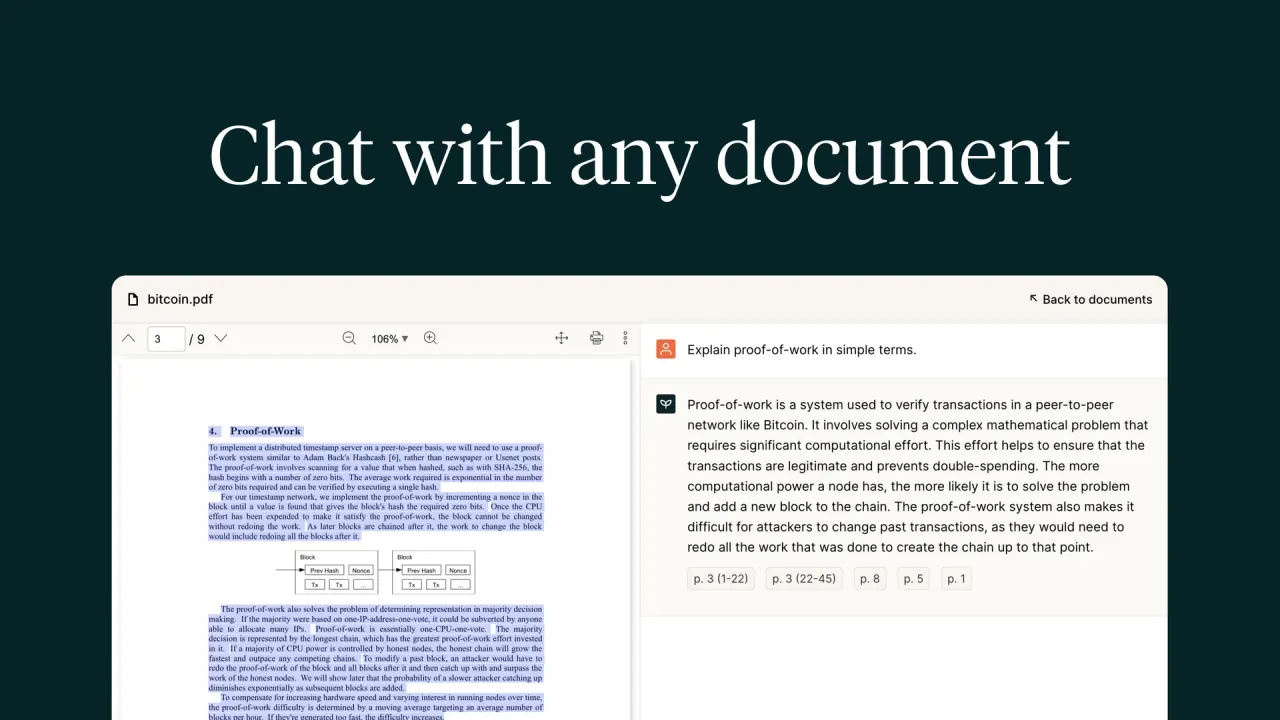
Stellen Sie Fragen zu mehreren PDFs, erhalten Sie Zusammenfassungen oder wandeln Sie Dokumente in strukturierte Daten um. Eine separate Entwickler-API bietet Parsing, schemaabhängige Extraktion, Abschnittserkennung und Dokumentenfragen.
Hast du dieses Tool genutzt? Bewerte es
Hast du dieses Tool genutzt? Bewerte es
PDF.ai ist ein PDF-Chat-Dienst und eine Entwicklerplattform, um Fragen zu stellen, Dokumente zusammenzufassen und Informationen aus PDF-Dateien zu gewinnen. Im Web steht das Gespräch mit Dokumenten im Mittelpunkt; die PDF-API bietet Parsing, strukturierte Extraktion, Abschnittserkennung und Fragen zu verarbeiteten Dateien. Beide Zugangswege haben getrennte Preise und Nutzungsmaßstäbe.
Das Entwicklerangebot ist darauf ausgerichtet, PDFs in strukturierte Daten umzuwandeln, eigene Felder zu extrahieren und Abschnitte intelligent zu erkennen. Damit ist das Produkt sowohl für Menschen relevant, die ein Dokument lesen, als auch für Entwickler, die dessen Inhalt in eine andere Anwendung übernehmen.
Der v2-Endpunkt Parse wandelt ein PDF in Markdown oder JSON um und unterstützt OCR, Tabellenformatierung und Bildextraktion.
Beschrieben werden zwei Qualitätsmodi für das Parsing. Standard ist die Voreinstellung und unterstützt die Sprachauswahl für OCR; der Parameter für die Sprachliste ist auf Englisch voreingestellt. Advanced verwendet Bild-Sprach-Modelle und soll bei komplexen Dokumenten möglicherweise eine höhere Genauigkeit bieten, ohne dass eine Sprache gewählt werden muss. „Möglicherweise“ ist dabei wichtig: Die Dokumentation beschreibt eine Verarbeitungsoption und keine gemessene Genauigkeitsgarantie für jedes Layout oder jeden Scan.
Die Dokumentenextraktion nutzt ein übergebenes JSON-Schema, um die zurückzugebenden Felder festzulegen. Der v2-Endpunkt Extract liefert strukturierte Daten zusammen mit Zitaten, die einzelne Felder mit den jeweiligen Quellabschnitten im Dokument verknüpfen.
Der v2-Endpunkt Split erkennt Abschnitte anhand übergebener Beschreibungen und liefert die Seiten, auf denen sie stehen, samt Konfidenzwerten. Die Abschnittsbeschreibungen werden als JSON-Array eingegeben; jedes Objekt braucht einen Namen und kann zusätzlich eine Beschreibung enthalten.
Der v2-Endpunkt Ask akzeptiert Fragen zu einem oder mehreren bereits geparsten Dokumenten. Nach Angaben des Unternehmens bezieht er den vollständigen Dokumentkontext ein; eine Anfrage übergibt ein Array von Dokument-IDs. Parsing ist für diesen Weg Voraussetzung: Die IDs im Array müssen auf bereits verarbeitete Dokumente verweisen.
Auch das Webprodukt bietet sprachübergreifende Gespräche. Ein PDF kann in einer Sprache vorliegen, die Frage in einer anderen; laut Anbieter folgt die Antwort der Sprache der Frage. Das ist eine Gesprächsfunktion, keine vollständige Liste von OCR-Sprachen und kein Nachweis einer identischen Erkennungsqualität über verschiedene Sprachen hinweg.
API-Anfragen werden mit einem Schlüssel authentifiziert, der auf der Seite Developer erzeugt wird. Der Schlüssel erscheint nur einmal bei der Erstellung; geht er verloren, lässt sich auf derselben Seite ein neuer erzeugen. Anfragen ohne Schlüssel liefern einen Fehler.
Ein dokumentiertes Muster zur Wiederverwendung beruht auf der Dokument-ID und den Parsing-Einstellungen:
Parse-Ergebnisse werden für spätere Aufrufe mit einer Dokument-ID und denselben Einstellungen zwischengespeichert; Antworten aus dem Cache benötigen null Parsing-Credits. Laut Dokumentation kann diese Wiederverwendung auch bei Extract und Split Parsing-Credits sparen.
Der Parse-Endpunkt wird für Inhaltsextraktion, den Aufbau von Wissensdatenbanken und Abläufe zur abrufgestützten Generierung positioniert. Markdown oder strukturierte Dokumentinhalte können in einem solchen Ablauf als Parsing-Ausgabe dienen.
Eine Bibliothek gespeicherter Prompts unterstützt wiederkehrende Fragen, indem sie bevorzugte Prompts zur späteren Verwendung speichert. Der Anbieter beschreibt auch das Bearbeiten gespeicherter Prompts über ein Stiftsymbol und das Entfernen nicht mehr benötigter Prompts.
Die Webfunktion zum Chatten mit allen Dokumenten sucht in hochgeladenen PDFs nach passenden Antworten und zeigt das PDF an, das sie für die Schlüsselwörter der Frage als am relevantesten bewertet. So lässt sich eine vorhandene Dokumentensammlung befragen und zugleich die Verbindung zum ausgewählten Quelldokument behalten. Beschrieben wird eine relevanzbasierte Suche in hochgeladenen Dateien, nicht die Behauptung, jedes Dokument trage zu jeder Antwort gleich viel bei.
PDF.ai bedient unterschiedliche Bedürfnisse, je nachdem, ob das Ergebnis eine herunterladbare durchsuchbare Datei, ein Dokumentengespräch oder eine durch Code genutzte Antwort sein soll. Browser-OCR und API-Zugang verdeutlichen diesen Unterschied:
Die gehostete Dokumentenoberfläche von PDF.ai wird über die Website aufgerufen; Entwickler integrieren sie über HTTP-API-Anfragen. Die Parse-Dokumentation enthält Beispiele für cURL, Python, Node.js und PHP.
Die verfügbaren Wege haben unterschiedliche Einstiegspunkte:
Die am 29. Oktober 2026 erfassten Webpreise zeigten für kostenpflichtige Stufen jährliche Abrechnung. Pro wurde mit $10 pro Monat bei jährlicher Abrechnung angezeigt, Ultimate mit $20 pro Nutzer und Monat bei jährlicher Abrechnung und Enterprise mit $30 pro Nutzer und Monat bei jährlicher Abrechnung. Hobby war als dauerhaft kostenlos ausgewiesen. Dies sind die erfassten Tarife bei Jahresabrechnung; sie legen keinen Betrag für eine Auswahl mit monatlicher Abrechnung fest.
| Webtarif | Erfasster Preis | PDF-Uploads pro Monat | Fragen pro Monat | OCR pro Datei | Maximale Dateigröße |
|---|---|---|---|---|---|
| Hobby | $0, dauerhaft kostenlos | 1 | 100 | 2 Seiten | 10MB |
| Pro | $10/Monat, jährlich abgerechnet | 100 | 1,000 | 10 Seiten | 50MB |
| Ultimate | $20/Nutzer/Monat, jährlich abgerechnet | Unbegrenzt | Unbegrenzt | 50 Seiten | 50MB |
| Enterprise | $30/Nutzer/Monat, jährlich abgerechnet | Unbegrenzt | Unbegrenzt | 100 Seiten | 100MB |
Die monatlichen Upload- und Fragekontingente werden getrennt gezählt.
OCR hat ein Seitenkontingent pro Datei; die maximale Dateigröße wird dagegen in MB angegeben. Der Anbieter unterscheidet diese OCR-Grenzen des Produkts ausdrücklich von der Tabelle der API-Credits. Die OCR-Seitengrenze ist daher kein API-Credit-Kontingent. Dass eine Datei die Größengrenze einhält, belegt allein noch nicht, dass alle gescannten Seiten in das OCR-Kontingent des Tarifs passen.
Die v2-Credit-Dokumentation nennt einen kostenlosen API-Tarif mit 200 Credits pro Monat ohne erforderliche Kreditkarte. Die kostenpflichtigen monatlichen Stufen haben folgende Kontingente; sie sind von den Webtarifen oben getrennt.
| Monatlicher API-Preis | Credits pro Monat |
|---|---|
| $0 | 200 |
| $49 | 3,000 |
| $99 | 10,000 |
| $249 | 30,000 |
| $599 | 100,000 |
Parse kostet im Standardmodus 1 Credit pro Seite und im erweiterten Modus 2 Credits pro Seite. Bei aktivierter optionaler LLM-Bildverarbeitung betragen die dokumentierten Zusatzkosten 1 Credit je fünf Bilder, aufgerundet. Zwischengespeicherte Parsing-Ergebnisse mit denselben Einstellungen benötigen null Parsing-Credits. Wiederholte Verarbeitung und ein erstes Parsing haben somit unterschiedliche Kostenbestandteile.
Der Extract-Endpunkt berechnet Extraktionskosten nach der Größe des Schemas: Bis zu fünf Felder kosten 2 Credits pro Seite, mehr als fünf Felder 4 Credits pro Seite. Liegt kein geparstes Ergebnis im Cache vor, kommen die jeweils anfallenden Parsing-Gebühren hinzu. Die Beispiele des Endpunkts trennen die Extraktionsgebühr vom ersten Parsing, statt Extraktion als eine pauschale Gebühr je Anfrage zu behandeln.
Die kurze Credit-Übersicht bezeichnet die beiden Extract-Tarife hingegen als „Standard“ und „Advanced“, mit 2 beziehungsweise 4 Credits pro Seite. Die Endpunktreferenz unterscheidet sie nach der Feldanzahl. Diese veröffentlichten Beschreibungen sind nicht identisch; beide Formulierungen bleiben hier getrennt, statt sie zu einer erfundenen einheitlichen Regel zusammenzuführen.
Split kostet 2 Credits pro Seite zusätzlich zum anfallenden Parsing. Laut Dokumentation vermeidet die Übergabe einer Dokument-ID Parsing-Credits; bei einer Datei oder URL wird dagegen während des Aufrufs geparst. Die Wiederverwendung geparster Inhalte verändert diesen Parsing-Anteil, während die Split-Gebühr Bestandteil des Vorgangs bleibt.
Ask berechnet 3 Credits multipliziert mit der gesamten Seitenzahl aller befragten Dokumente. Das dokumentierte Beispiel kombiniert ein Dokument mit 10 Seiten und eines mit 5 Seiten zu 45 Credits. Der Preis richtet sich nach der vollständigen Seitenzahl der Anfrage, nicht nach pauschal drei Credits für jede Frage unabhängig davon, wie viele Dokumente sie umfasst.
Die veröffentlichte Kündigungsrichtlinie schließt Teil- und Vollerstattungen aus. Sie erlaubt die jederzeitige Kündigung über das Stripe Portal und erklärt, dass nach der Kündigung keine weiteren Gebühren anfallen. Kündigung und Erstattungsanspruch sind daher unterschiedliche Fragen: Ein Abonnement beenden zu können ist kein Versprechen, bereits abgebuchte Beträge zurückzuzahlen.
Zwei Alternativen bedienen ähnliche Anforderungen an Dokumentengespräche mit unterschiedlichen Schwerpunkten. Die folgenden Unterschiede stammen aus den Produktbeschreibungen der jeweiligen Wettbewerber und bestätigen die Genauigkeit keines der Dienste unabhängig.
Die dedizierte API-Dokumentation für Legacy v1 nennt maximal 100MB für PDF-Uploads per URL und 4.5MB für direkte Datei-Uploads sowie 500 Anfragen pro Minute. Sie nennt keine Begrenzung der Seitenzahl, beschreibt aber ein Upload-Zeitlimit von 60 Sekunden für PDFs mit sehr vielen Seiten. Dieselbe Referenz kennzeichnet den alten Ultimate-API-Tarif als nicht mehr unterstützt. Das sind Aussagen zu Legacy v1, keine allgemeinen Grenzen der Web-App oder der heutigen v2-Endpunkte.
Auch Modellnamen haben eine Versionsgrenze. Die Legacy-v1-Chatreferenz nennt gpt-4o und gpt-4-turbo mit jeweils 2 und 4 Credits pro Nachricht sowie einen Parameter für die Antwortsprache. Diese Beschreibung pro Nachricht gehört zu v1; sie ersetzt weder die seitenbasierte Formel von v2 Ask noch identifiziert sie das Modell hinter einer Webstufe namens Basic oder Advanced.
Die Datenschutzerklärung beschreibt freiwillig angegebene Kontaktdaten, Cookies und Geräteinformationen sowie angemessene Maßnahmen zum Schutz personenbezogener Daten. Sie erklärt, persönliche Informationen weder zu verkaufen noch an Dritte weiterzugeben, außer wenn dies gesetzlich vorgeschrieben oder zur Erfüllung von Anfragen nötig ist. Diese Ausnahmen bleiben Teil der Aussage; es ist kein bedingungsloses Versprechen, dass niemals ein Dritter Informationen erhält.
Die geprüfte Datenschutzerklärung nennt weder eine Aufbewahrungsdauer für hochgeladene Dokumente noch, ob hochgeladenes Material zum Training von KI-Modellen verwendet wird. Diese Grenze der Offenlegung ist bei sensiblen Dateien relevant: Allgemeine Formulierungen zu personenbezogenen Daten dokumentieren für sich genommen nicht, wie lange ein PDF, extrahierter Text oder Gesprächsinhalte verfügbar bleiben.
Ein separater Anbieterleitfaden beschreibt eine Option für private Dokumente. Die private PDF-Datei werde nicht in die Systeme des Unternehmens hochgeladen; das Anzeigen des Dokuments sei dann nicht möglich, Chatten jedoch weiterhin. Die Option muss vor Beginn des Uploads eingestellt werden. Dies ist eine Aussage zum privaten Dateimodus; sie belegt weder eine vollständig lokale Architektur noch eine Zusage, sämtliche an einem Gespräch beteiligten Informationen nicht zum Training zu verwenden.
Der Entwickler-Marketingbereich erklärt, Dateien würden nach der Verarbeitung gelöscht. Die v2-Löschreferenz beschreibt separat eine gespeicherte PDF-Datei, einen Dokumentdatensatz und zwischengespeicherte Parsing-Ergebnisse, die dauerhaft entfernt werden können. Diese Aussagen lassen den automatischen Aufbewahrungszeitplan offen; der Marketingsatz ersetzt nicht das konkrete Speicher- und Löschverhalten des Endpunkts.
Der v2-Endpunkt Delete gilt nur für Dokumente, die über v2 Parse, Extract oder Split erstellt wurden. Er entfernt den zugehörigen Dokumentdatensatz, die gespeicherte hochgeladene Datei und die zwischengespeicherten Parsing-Ergebnisse dauerhaft. Die Löschung ist unumkehrbar und kostet keine API-Credits. Dieser Umfang belegt nicht denselben Löschmechanismus für sämtliche anderen Produktzugänge oder älteren Endpunkte.
Für das Entfernen von Webdokumenten gibt es einen eigenen dokumentierten Ablauf: Im Dashboard Documents öffnen, das Papierkorbsymbol neben einer Datei wählen und auf das Fenster reagieren, das nach dauerhaftem Entfernen aus dem Konto fragt. Diese Anweisung auf Kontoebene beschreibt eine Nutzerkontrolle. Sie liefert weder eine feste Aufbewahrungsdauer noch beantwortet sie die separate Frage nach der Nutzung für KI-Training.
Nein. Hobby nennt einen monatlichen PDF-Upload und 100 Fragen pro Monat. Der kostenlose API-Tarif nennt stattdessen 200 Credits monatlich, wobei die Nutzung vom Endpunkt und der Seitenzahl abhängt.
Ja. Der Anbieter beschreibt das Hochladen eines PDFs in einer Sprache und Fragen in einer anderen; die Antworten folgen der Sprache der Frage. Die OCR-Sprachauswahl ist eine separate Parsing-Einstellung.
Die veröffentlichte Richtlinie erlaubt Kündigungen über das Stripe Portal, schließt aber Teil- und Vollerstattungen aus. Künftige Gebühren zu stoppen und einen bereits abgebuchten Betrag zurückzuzahlen sind unterschiedliche Regelungen.
