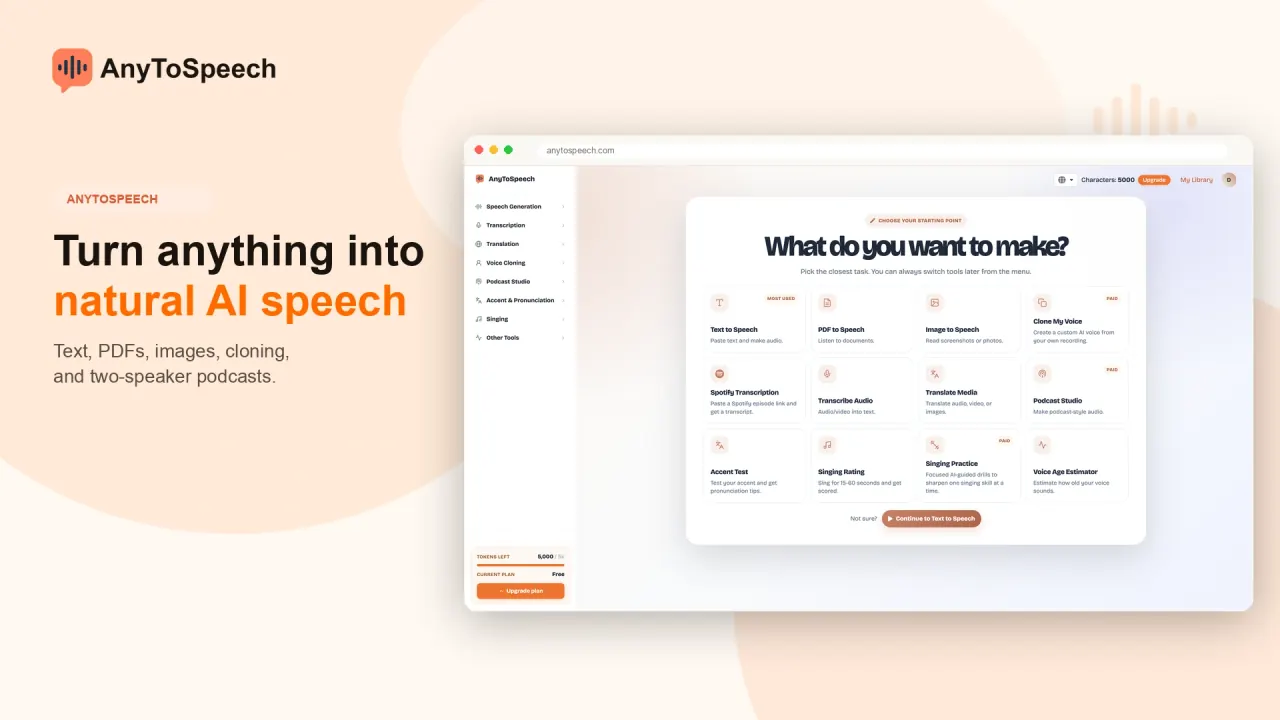
Texte und Dokumente vertonen, Aufnahmen transkribieren, Dialoge und Podcasts erstellen sowie Akzent oder Gesang analysieren. Browser, Mobilgeräte und MCP nutzen dasselbe AnyToSpeech-Konto.
Hast du dieses Tool genutzt? Bewerte es
Hast du dieses Tool genutzt? Bewerte es
AnyToSpeech kombiniert Spracherzeugung, Transkription, Übersetzung und Stimmanalyse in einem Dienst. Das Anhören von Dokumenten, geskriptete Gespräche, eigene Stimmen und kurze Bewertungen der Stimme ergänzen diese Kernaufgaben.
Die Umwandlung von Text zu Sprache macht aus Klartext, Dokumenten oder PDFs Audio mit wählbaren Stimmen und MP3-Download. Für das Vorlesen von Dokumenten, das Darstellen eines geschriebenen Skripts und das Erstellen eines Gesprächs aus einem Thema gibt es getrennte Produktionswege.
Der Zugang hängt von der Funktion ab: Kostenlose Vorschau, monatliches Kontingent und kostenpflichtige Erzeugung sind unterschiedliche Angebote.
Fertige Transkriptionen lassen sich in My Library abrufen, ohne die Verarbeitungsseite geöffnet zu lassen. Die Funktion wirbt auch mit Übersetzung und Downloads als TXT oder DOCX.
Die Stimmenbibliothek bietet Hörproben und Filter für Sprache, Geschlecht, Ton und Akzent. Beim Geschlecht stehen weiblich, männlich und neutral zur Wahl.
Stimmklonen beginnt mit drei angeleiteten Aufnahmen von jeweils 10–15 Sekunden. Unterstützt werden Browseraufnahmen und vorhandene WAV-, MP3- oder M4A-Dateien. Der fertige Klon wird zu einer im Dienst wiederverwendbaren Stimme.
Die Klon-FAQ nennt 27 Sprachen, darunter Englisch, Französisch, Spanisch, Deutsch, brasilianisches Portugiesisch, Japanisch, Koreanisch, Chinesisch und Arabisch. Diese Zahl gilt für das Klonen und ist keine gemeinsame Sprachanzahl für alle Werkzeuge. Voice Design nennt separat Englisch, Französisch, Spanisch, Deutsch, Portugiesisch, Italienisch, Japanisch, Koreanisch und Chinesisch.
Voice Design akzeptiert entweder 13 strukturierte Attribute oder eine freie Beschreibung mit 30–250 Zeichen. Die Attribute betreffen Dialekt, Geschlecht, Alter, Emotion, Ton, Tonhöhe, Lautstärke, Tempo, Klarheit, Sprachfluss, Persönlichkeit, Textur und Umgebung. Für diesen beschreibungsbasierten Weg ist keine Aufnahme nötig.
Jede Anfrage an Voice Design erzeugt drei Stimmvorschauen zum Vergleich. Gespeichert wird das Ergebnis zu einer eigenen Stimmoption in unterstützten AnyToSpeech-Werkzeugen. Die Zugangsformulierung ist sorgfältig zu lesen: Voice Design heißt Pro-Funktion, wird aber zugleich als zusammen mit Klonen in kostenpflichtigen Tarifen enthalten beschrieben. Das grenzt es nicht eindeutig auf den Website-Tarif namens Pro ein.
Multi-Speaker Text to Speech unterstützt zwei bis sechs Sprechende, Pausen und emotionale Hinweise und mischt das Gespräch in eine MP3. Nutzer schreiben den Dialog und bestimmen, wer jede Zeile spricht.
Podcast Studio erzeugt aus einem Thema eine MP3 mit zwei Sprechenden, Intromusik und gesprochenem Episodentitel. Auch ein vorbereitetes Skript kann eingegeben werden. Die Einleitung ist Bestandteil der erzeugten Episode.
Themenbasierte Episoden zielen auf 2, 5, 10 oder 20 Minuten gesprochene Länge; eingefügte Skripte dürfen bis zu 12,000 Zeichen enthalten. Das sind Zielzeiten und eine davon getrennte Eingabegrenze für Skripte.
English Accent Test analysiert eine vorgelesene Passage hinsichtlich vermuteter Muttersprache, eines Werts für die Nähe zur muttersprachlichen Aussprache, Vokal- und Konsonantenmerkmalen sowie Intonation. Dies sind die vom Unternehmen genannten Analysekategorien, keine unabhängige Zertifizierung der Sprachbeherrschung.
Die Gesangsanalyse berichtet Tonhöhe, Rhythmus, Klangfarbe, Umfang, Ausdruck, Atemkontrolle und Textverständlichkeit sowie einen Stimmtyp. Bewertet wird die eingereichte Gesangsleistung.
Im Mehrsprecher-Editor lassen sich einzelne Zeilen, Sprechende und Pausen steuern.
Vor der Aufnahme eines KI-Podcasts lässt sich das Skript prüfen, umschreiben, zwischen Sprechenden neu verteilen und mit Regiehinweisen versehen. Laut Seite erfolgt die Berechnung beim Drücken von Record.
Die Podcast-Zeitleiste unterstützt das Verschieben und Kürzen von Clips, die Neuaufnahme einer Zeile, die Lautstärkeänderung je Stimme und das Rückgängigmachen von Änderungen. Einzelne Sätze lassen sich überarbeiten, ohne die ganze Episode zu ersetzen.
Speichern aktualisiert die Episode in der Bibliothek und die über den Freigabelink abgespielte Version. Der Download liefert den neuesten Schnitt mit Coverbild in der MP3.
Hilfreich ist die Unterscheidung, ob das Ergebnis geschriebene Zeilen bewahren, Quellenmaterial in einer erzeugten Diskussion erklären oder ein Dokument vorlesen soll.
Kostenlose Vorschauen, kostenpflichtige Erzeugung und die folgenden Bedingungen zur Nutzung der Ausgaben und der Website sind wesentliche Grenzen für die Produktion.
AnyToSpeech bietet Apps für iPhone und Android. Plattformübergreifende Zugänge belegen keine identischen Kataloge oder Limits in jeder Oberfläche.
Die MCP-Einrichtung nutzt die Kontoanmeldung für ChatGPT, Claude, Cursor oder VS Code; Perplexity und Meta Muse verwenden einen Integrationsschlüssel.
MCP verbraucht die bestehenden Credits, Transkriptionsminuten und Tariflimits des Kontos. Die Erstellung über Assistenten nutzt dasselbe Nutzungskontingent wie der Website-Zugang.
Die Website hat die Stufen Free, Hobby, Standard und Pro. Die Tabelle zeigt die am 29. Oktober 2026 erfassten Monthly-Preise und Leistungen. Das Zeichen $ ist das angezeigte Symbol; ein ISO-Währungscode wird nicht angegeben.
| Website-Tarif | Angezeigter Monatspreis | Sprachzeichen pro Monat | Transkriptionsminuten pro Monat | Stimmklon-Kontingent |
|---|---|---|---|---|
| Free | $0 | 5,000 | 50 | Nicht enthalten |
| Hobby | $7 | 50,000 | 200 | 1 |
| Standard | $14 | 100,000 | 1,000 | 3 |
| Pro | $69 | 1,000,000 | 5,000 | 10 |
Die Preisseite beschreibt Free-Sprachumwandlungen mit jeweils ungefähr 30 Sekunden und schließt Premiumstimmen aus. Die Free-Karte auf der Startseite zeigt dagegen ungefähr 15 Sekunden Audio. Die separate Transkriptionsoberfläche nennt für Free 50 Minuten monatlich. Sprachzeichen und Transkriptionsminuten sind getrennte monatliche Zähler.
Mehrsprecher-Sprache verbraucht einen Credit pro Zeichen; neue Konten enthalten kostenlose Credits. Zeichenverbrauch und Transkriptionsminuten werden separat gezählt.
Die Preisoberfläche bietet Monthly und Yearly mit dem Hinweis „Save 40%+“. Die Abrechnungs-FAQ beschreibt jedoch weiterhin alle Tarife als monatliche Abonnements, monatliche Erneuerung der Zeichenkontingente und Übertrag ungenutzter Zeichen in den nächsten Monat. Jahresauswahl und rein monatliche FAQ stehen nebeneinander; sie ergeben keine vollständig einheitliche Darstellung der Abrechnungsintervalle.
Abonnements können jederzeit gekündigt, pausiert, hoch- oder heruntergestuft werden. Erstattungen sind innerhalb von sieben Tagen nach dem Kauf nur zulässig, wenn das Produkt nicht benutzt wurde; die Anfrage erfolgt per E-Mail. Die Nichtnutzung ist Teil der Erstattungsregel, das Zeitfenster also keine bedingungslose siebentägige Testphase nach produktivem Einsatz.
Luvvoice bietet Text-zu-Sprache mit Anhören im Browser und MP3-Downloads. Es ist ein passender Vergleich für die direkte Umwandlung von Text in Audio.
Luvvoice akzeptiert auch PDF- und TXT-Dokumente zur Vertonung. Das überschneidet sich mit Dokumenthören und eingefügten Skripten, belegt aber keine gleiche Stimmqualität, Nutzungsbedingungen oder Produktionslimits.
Narakeet bietet Dokument-zu-Audio sowie Videoabläufe aus PowerPoint oder Markdown. Sein Weg zum Folienvideo ist gesondert relevant, wenn ein Projekt eine visuelle Präsentation als Ergebnis braucht und nicht nur eine Erzählung oder Gesprächsdatei.
Narakeet wandelt außerdem SRT- oder WebVTT-Untertitel in Audio um, das mit deren Zeitstempeln synchronisiert ist. Dies ist relevant, wenn vorhandene Zeitmarken das Ergebnis festlegen.
Die Erzeugung in Podcast Studio erfordert einen kostenpflichtigen Tarif; Free-Konten können auf der Seite Stimmen vorhören. Ein sichtbarer „Ausprobieren“-Einstieg bedeutet daher nicht, dass ein kostenloses Konto eine fertige Episode produzieren kann.
Die Gesangsbewertung erwartet eine Darbietung von 15–60 Sekunden; wortloses Summen erhält einen niedrigeren Wert für Textverständlichkeit. Diese Regel ist bei der Deutung des Gesamtergebnisses wichtig: Eine wortlose Stimmübung wird nicht genau wie eine Darbietung mit verständlichem Liedtext bewertet.
Die Website-Bedingungen schließen Minderjährige und Personen unter 18 Jahren aus. Diese Grenze gilt, obwohl Bildungszwecke und studentisches Hören zur Produktpositionierung gehören. Solche Zielgruppen bedeuten nicht, dass alle Personen im Schulalter nutzungsberechtigt sind.
Die Website beschreibt Stimmen namentlich genannter Personen als unterhaltende KI-Nachbildungen ohne Verbindung, Überprüfung oder Billigung durch diese Personen. Dazu gehört ein Generator im Stil von Donald Trump. Die tatsächlich erzeugte Ausgabe und die Erlaubnis der genannten Personen wurden nicht unabhängig verifiziert.
Gäste und kostenlose Konten dürfen im Generator für Personenstimmen pro Kalendermonat fünf Erzeugungen mit jeweils bis zu 500 Zeichen durchführen. Dies ist ein werkzeugspezifisches Kontingent und nicht das allgemeine Sprachzeichenkontingent eines Tarifs.
Die Marketingseite zum Klonen nutzt den Aufruf „Start Cloning -- It's Free“. Der Preisvergleich schließt Klonen hingegen aus Free aus und nennt Klon-Kontingente für kostenpflichtige Stufen. Die öffentlichen Formulierungen vermitteln daher unterschiedliche Eindrücke dazu, ob das Erstellen eines Klons zum kostenlosen Zugang gehört.
Die Free-Karte der Startseite streicht die kommerzielle Nutzung sämtlicher Ausgaben durch. Die eigene Preisseite führt kommerzielle Nutzung ebenfalls unter den in Free nicht enthaltenen Funktionen auf.
Die Text-zu-Sprache-FAQ erlaubt monetarisierte soziale Beiträge, bezahlte Anzeigen, IVR-Systeme und Sprachnachrichten kleiner Unternehmen, nennt aber einen eigenen Vorbehalt für kommerzielle Nutzung in großem Umfang. Die Website-Bedingungen beschränken separat die Nutzung der Website für Werbung oder Marketing.
Die Datenschutzerklärung nennt die Erfassung von E-Mail-Adressen und die bei Lemon Squeezy liegenden Abrechnungsdaten, auf die AnyToSpeech nach eigener Aussage keinen direkten Zugriff hat. Sie beschreibt zudem Protokolle mit IP-Adresse, Browsertyp, Internetanbieter, Zeitstempeln, Herkunfts- oder Ausstiegsseiten und möglicherweise Klickzahlen. Diese allgemeinen Besucher- und Abrechnungsangaben sind von Zusagen zu bestimmten Audiowerkzeugen zu unterscheiden.
Die Klon-FAQ sagt, Sprachdaten seien bei Übertragung und Speicherung verschlüsselt, Klone blieben privat im Konto und Sprachdaten würden weder an Dritte weitergegeben noch zum Modelltraining verwendet. Das ist eine Unternehmensaussage zu den Sprachdaten der Klonfunktion, keine plattformweite Trainingsverzichtszusage für jedes Dokument, Bild, Transkript oder erzeugte Episode.
English Accent Test sagt, Audio werde direkt nach der Analyse gelöscht und Sprachaufnahmen würden nicht gespeichert. Das Gesangswerkzeug erklärt separat, Clips in Echtzeit zu verarbeiten und zu verwerfen, ohne Anmeldung oder Weitergabe. Diese Löschbeschreibungen gelten für die Bewertungsabläufe, nicht für gespeicherte Podcasts, Stimmklone im Konto oder die allgemeine Library.
Das Anzeigen von Inhalten gewährt AnyToSpeech eine nicht ausschließliche, weltweite, unwiderrufliche und unterlizenzierbare Lizenz, sie in beliebigen Medien zu nutzen, zu vervielfältigen, anzupassen, zu veröffentlichen, zu übersetzen und zu verbreiten. Die Bedingungen definieren solche Inhalte weit: Audio, Video, Text, Bilder und anderes Material, das Nutzer auf der Website anzeigen möchten. Diese Lizenz ist neben den Ausgabe- und Datenschutzaussagen eine wesentliche Bedingung zu Inhaltsrechten.
Nutzer müssen Eigentümer der angezeigten Inhalte sein und dürfen keine Rechte Dritter verletzen; AnyToSpeech behält sich vor, Inhalte ohne Ankündigung zu entfernen. Die MCP-Stimmstudiofunktion umfasst das Löschen eigener benutzerdefinierter Stimmen. Diese Löschfunktion nennt für sich genommen weder eine Aufbewahrungsdauer noch eine Frist zum Entfernen sämtlicher zugehöriger Uploads oder erzeugter Dateien.
Nein. Podcast Studio erlaubt Free-Nutzern das Vorhören von Stimmen, die Erzeugung einer Episode erfordert aber einen kostenpflichtigen Tarif. Diese Zugangsregel unterscheidet sich von den kostenlosen Credits für einen manuell geschriebenen Mehrsprecher-Dialog.
Das Produkt verbindet PDF-zu-Audio mit einer wiederverwendbaren geklonten Stimme und positioniert diese Kombination ausdrücklich für Autoren. Stimmklonen nutzt aufgenommene Beispiele; Voice Design erstellt eine Stimme dagegen aus einer schriftlichen Beschreibung.
Nein. MCP nutzt dieselben Konto-Credits, Transkriptionsminuten und Tariflimits wie die Website. Eine Assistentenanbindung verändert den Zugang zu den Werkzeugen und fügt kein separates Erzeugungsabonnement hinzu.
